第十一讲 · 复杂场景下的知识表示学习与推理
对应 PPT:第11讲 第 10 讲的深化——专门讲”如何建模不同的关系特性”(1-N/N-N/对称/逆反/组合/层次)。重点:TransE 家族完整对比、张量分解改进、特定空间模型。
1. 关系特性分类
1.1 复杂映射特性(4 类)
| 类型 | 含义 | 例子 |
|---|---|---|
| 1-1 | 一对一 | (北京, 首都, 中国) |
| 1-N | 一对多 | (中国, 有城市, 北京/上海/广州) |
| N-1 | 多对一 | (小明/小强, 出生于, 北京) |
| N-N | 多对多 | 多名球员效力于多支俱乐部,如 C 罗关联皇家马德里和曼联 |
“1”位置是唯一性实体,“N”位置是非唯一性实体。
1.2 多种关系模式(4 类)
| 模式 | 含义 | 例子 |
|---|---|---|
| 对称关系 | 夫妻、朋友 | |
| 反对称关系 | 老师 | |
| 逆反关系 | 球员 ↔ 效力于 | |
| 组合关系 | (小明, 出生于, 北京) + (北京, 首都, 中国) → (小明, 国籍, 中国) |
1.3 实体间层次关系
- 中国 > 广西省 > 桂林市(自顶向下的层次)
- 双曲空间 / 极坐标可建模这种树状结构
2. 基础模型的局限
| 模型 | 局限 |
|---|---|
| TransE | 不能建模 1-N(强制 t 相等);对称关系 → ;无法建模层次 |
| RESCAL | 每个关系需要完整矩阵,参数量较大 |
| DistMult | 对角双线性打分对头尾天然对称,难以表示反对称关系 |
3. 基于关系感知映射的模型
3.1 模型总览
| 模型 | 表示空间 | 打分函数 | 特点 |
|---|---|---|---|
| TransH | 实数 | 关系超平面投影 | |
| TransR | 实数 | 关系空间投影 | |
| STransE | 实数 | 头尾实体不同投影 | |
| TransD | 实数 | 自适应稀疏投影 | |
| TransF | 实数 | 放松约束 | |
| TransA | 实数 | 马氏距离 |
3.2 TransH
- 每个关系 r 对应超平面法向量
- 实体投影到超平面再平移
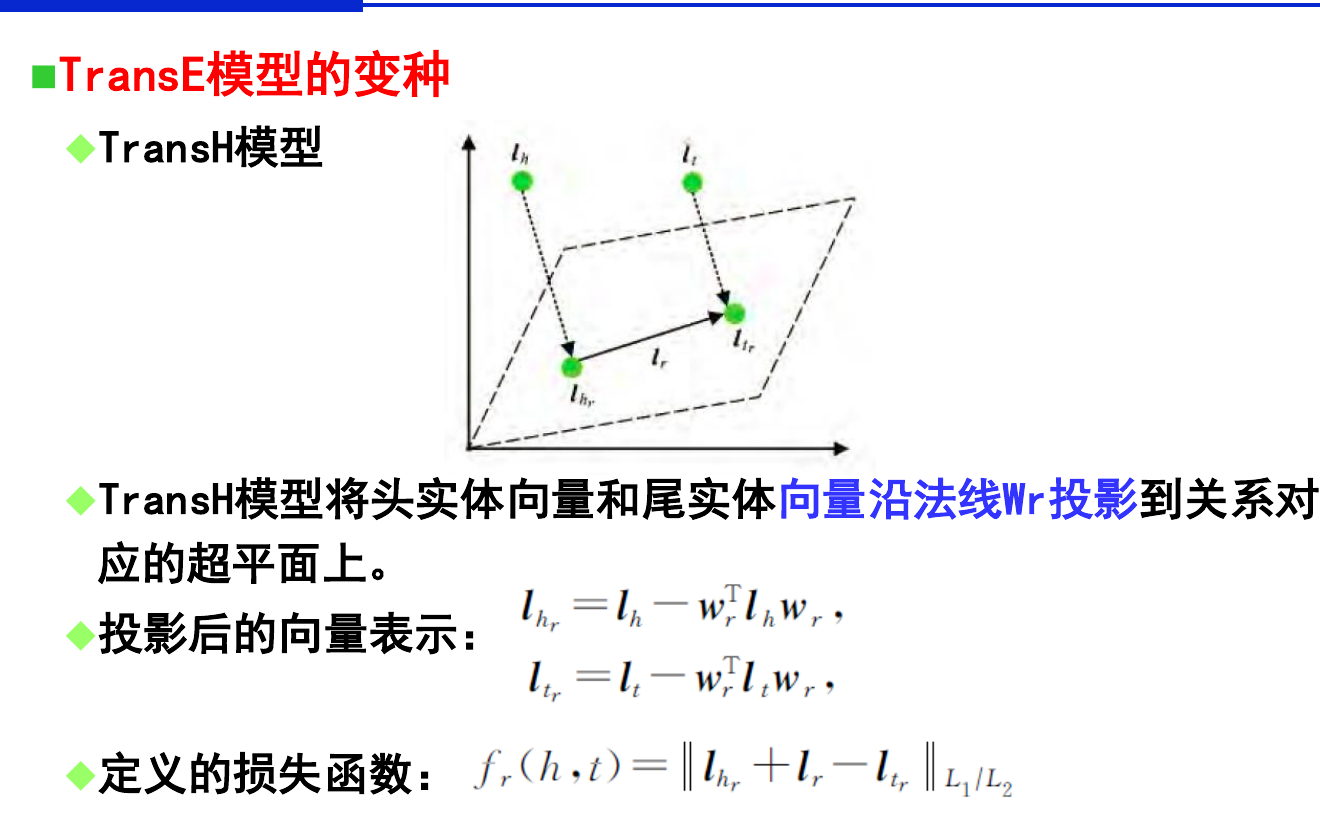
- 投影公式:
- 缺点:同一关系的所有实体都投影到同一个超平面,无法精细区分
3.3 TransR / STransE / TransD
| 模型 | 关键创新 | 优缺点 |
|---|---|---|
| TransR | 每个关系一个投影矩阵 | 实体/关系空间分离;参数多 |
| STransE | 头/尾实体分别投影 | 更灵活;参数更多 |
| TransD | 自适应稀疏投影矩阵 | 减少参数 |
TransD 的投影公式:
- 头尾实体分别投影 → 自适应
3.4 TransF
- 放松 TransE 的硬约束:头实体+关系 ≠ 必须等于尾实体,只需保持相同方向
3.5 TransA / TransM
- TransA:欧氏距离 → 加权马氏距离(对不同分量加权)
- TransM:降低 1-N 关系权重
4. 基于特定表示空间的模型
4.1 4 个模型
| 模型 | 表示空间 | 思想 |
|---|---|---|
| KG2E | 多维高斯空间 | 实体/关系表示为高斯分布,含不确定性 |
| ManifoldE | 流形空间 | 实体在球体内(不强制相等) |
| TorusE | 紧李群环 | TransE 的李群环版本 |
| HAKE | 极坐标系 | 模长+相角分别建模层次和语义 |
4.2 KG2E(不确定性建模)
- 实体/关系嵌入多维高斯分布
- = 中心位置, = 不确定度
- 先得到实体差分分布:
- 再用 KL 散度或期望似然比较该分布与关系分布
KG2E 同时表示复杂映射特性和不确定性,这是它与确定性点向量模型的主要区别。
4.3 ManifoldE(流形)
- 打破”点 = 点”的硬约束
- 头实体和关系为球心,尾实体在球内:
- 巧妙解决 1-N 问题:1-N 的多个 t 只要都在球内即可
4.4 TorusE(紧李群环)
- 把 TransE 搬到李群环上
- 同一头实体不同尾实体的差值可以相同 → 建模 1-N
- 打分函数:
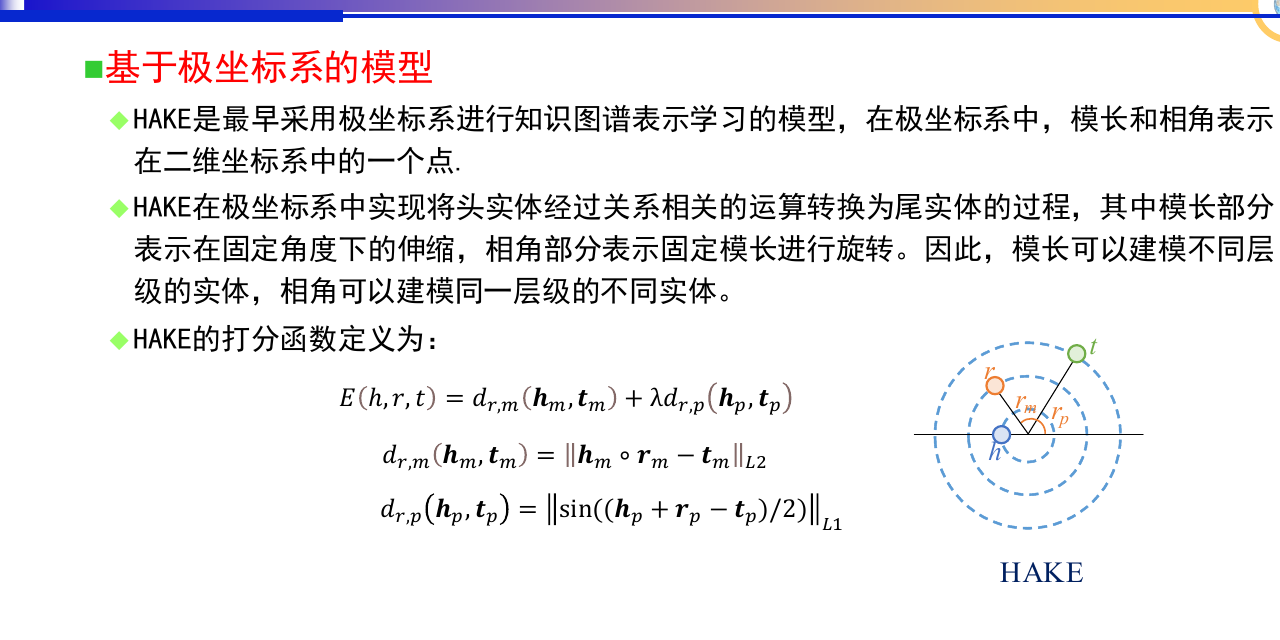
4.5 HAKE(极坐标建模)
- 实体/关系表示为极坐标
- 模长 建模层次(同一层 → 相同模长)
- 相角 建模语义(同一类 → 相近相角)
- 数学:
$\mathbf{h} \circ \mathbf{r}$在极坐标下 = 模长相乘 + 相角相加
5. 建模多种关系模式的 3 类方法
5.1 总览
| 类型 | 代表模型 | 关键思想 |
|---|---|---|
| 改进张量分解 | ComplEx / HolE / SimplE | 打破交换律 |
| 改进关系感知映射 | PairRE / TripleRE / TranS | 增加映射+平移 |
| 旋转操作 | RotatE / QuatE / DualE | 复数/四元数旋转 |
5.2 改进张量分解
ComplEx(复数空间与共轭):
- 实体/关系嵌入复数空间
- 使用带尾实体共轭的复数三线性打分
- 打分函数:
- = 尾实体的共轭
- 同时建模对称 + 反对称
HolE:
- 循环相关运算
- 头尾实体间的循环相关 → 同时建模对称/反对称
- 但不能建模组合关系
SimplE:
- 为每个实体分别学习头角色嵌入 和尾角色嵌入
- 为每个关系构造对应的逆关系
- 打分函数:
5.3 改进关系感知映射
PairRE(最优雅的方案):
- 关系用成对向量 分别处理头/尾
- 打分函数:
- 满足约束:
| 关系模式 | PairRE 约束 |
|---|---|
| 对称 | |
| 反对称 | |
| 逆反 | |
| 组合() |
TripleRE:
- 关系表示为3 部分(头映射 + 平移 + 尾映射):
TranS:
- TripleRE 的扩展,2 次映射 + 3 次平移:
三式都用残差向量的范数作为标量距离:距离越小,三元组越可信。
5.4 旋转操作
RotatE(复数旋转):
- 是模长 1 的复数(纯旋转)
- 4 种关系模式都能建模
- 缺点:复数空间一个平面上的旋转,可能导致奇异性
QuatE(四元数旋转):
- 实体/关系嵌入四元数空间
- 通过哈密顿乘法实现在两个平面上的旋转(更稳定)
- 打分函数:
DualE(对偶四元数 = 旋转 + 平移):
- 实体/关系嵌入对偶四元数空间
- 对偶四元数同时表示旋转和平移
- 关系使用单位对偶四元数:实部归一化,实部与对偶部正交,即 、
- 打分函数:
6. 建模层次关系
6.1 2 类方法
| 方法 | 代表模型 | 核心思想 |
|---|---|---|
| 双曲空间 | Poincaré | 双曲空间 = 连续树形空间 |
| 极坐标系 | HAKE | 模长建模层次,相角建模语义 |
6.2 Poincaré 模型
- 庞加莱球(特殊的几何空间)
- 距球心近 = 高层抽象概念,距球心远 = 低层具体实体
- 打分函数:
- 只关注”上位”层次关系(如 WordNet)
6.3 HAKE 极坐标
- 二维极坐标 表示一个点
- 模长 → 层次关系(同一层 = 相同模长)
- 相角 → 语义(同一类 = 相近相角)
7. 模型对比表
| 模型 | 空间 | 打分函数核心 | 主要建模 |
|---|---|---|---|
| TransE | 实数 | 1-1、反对称、组合 | |
| TransH | 实数 | 投影到关系超平面 | 1-N |
| TransR | 实数 | 投影到关系空间 | 复杂映射 |
| STransE | 实数 | 头尾分别投影 | 复杂映射 |
| TransD | 实数 | 自适应稀疏投影 | 复杂映射 |
| TransF | 实数 | 放松方向约束 | 简单关系 |
| TransA | 实数 | 加权马氏距离 | 复杂映射 |
| KG2E | 高斯 | 不确定性相似度 | 不确定性 |
| ManifoldE | 流形 | 球体内距离 | 1-N |
| TorusE | 李群环 | 李群平移 | 1-N |
| ComplEx | 复数 | 带共轭的三线性积 | 对称+反对称 |
| HolE | 实数 | 循环相关 | 对称+反对称 |
| SimplE | 实数 | 双嵌入+逆关系 | 对称+反对称 |
| PairRE | 实数 | 成对关系向量 | 4 种模式 + 复杂映射 |
| TripleRE | 实数 | 头映射+平移+尾映射 | 4 种模式 |
| TranS | 实数 | 2 次映射+3 次平移 | 4 种模式 |
| RotatE | 复数 | 4 种模式 | |
| QuatE | 四元数 | 哈密顿乘法(两平面) | 4 种模式 + 更稳定 |
| DualE | 对偶四元数 | 旋转+平移 | 4 种模式 |
| HAKE | 极坐标 | 模长+相角 | 层次关系 |
| Poincaré | 双曲 | 庞加莱距离 | 层次关系 |
8. 静态知识图谱推理:规则、路径与大模型
课件从这里开始不再只讨论“换一种嵌入空间”,而是比较三条完整推理路线。
8.1 规则推理四个层次
| 层次 | 代表方法 | 课件中的关键点 |
|---|---|---|
| 归纳逻辑编程 | AMIE+ / ScaLeKB / Evoda | 优化规则搜索;用清理、分区提升规模;把 Horn 扩展到更一般的 Datalog |
| 神经规则学习 | NeuralLP / DRUM / RLvLR / RNNLogic / RARL / Ruleformer | 端到端学习规则、用嵌入剪枝、RNN 或 Transformer 生成规则序列 |
| 规则增强 KGE | KALE / RUGE / RulE / RPJE | 实例化规则并赋软真值,或联合表示实体、关系、规则 |
| 规则与 KGE 迭代 | IterE / UniKER / EngineKG | 新规则补图,更新后的图再训练表示;两种学习形成闭环 |
这条路线的优点是规则可读、可验证;难点是搜索空间和规则噪声。神经方法提升可扩展性,但也可能让规则的符号含义变弱。
8.2 随机游走:把路径变成特征
PRA 从头实体出发进行受约束、带权的随机游走,把不同关系路径到达候选实体的概率作为特征,再训练分类器预测关系。SFE 在此基础上抽取局部子图特征。课件还列出:
- PathCon:将路径和实体对邻接关系构成的上下文一起预测;
- CPRA:聚类相关关系,用多任务学习建模路径交互;
- C-PR:用词嵌入提供全局语义,再做双向选择性游走;
- ANet:把启发式 A 搜索引入动作选择,优先扩展重要实体和关系;
- 结合网络文本的方法:从文本和 KG 中共同学习句法—语义规则再推理。
随机游走的关键是“枚举路径并转成固定特征”;它不需要训练一个会走图的 Agent,但长路径数量会迅速膨胀。
8.3 强化学习:让 Agent 学会走哪条边
强化学习把整张 KG 当环境,把关系边当动作,把当前位置和查询编码成状态。代表方法形成一条清晰演化线:
| 方法 | 解决的问题 |
|---|---|
| DeepPath | 首次用强化学习做静态多跳推理,以到达正确尾实体为主要奖励 |
| MINERVA | 用 LSTM 记忆历史状态和动作序列,再输出动作概率 |
| DIVA | 用变分推理表示路径和答案的不确定性 |
| MultiHopKG | 给中间状态软奖励,并用 Action Drop 增加路径多样性 |
| M-Walk | 用 RNN 记忆路径,并用蒙特卡罗树搜索缓解稀疏奖励 |
| RARL | 把高质量规则作为动作先验 |
| AttnPath | 用 LSTM 与图注意力丰富状态,减少原地停滞 |
| DIVINE | 用生成对抗模仿学习从示例路径学习策略和奖励 |
这里的“可解释”来自最终路径,但路径存在不等于因果解释;还要检查每条边是否真的支撑结论。
8.4 LLM 搜图:把“选边”交给语言模型
| 方法 | 最小理解 |
|---|---|
| StructGPT | 反复调用结构化数据接口,把返回路径线性化给 LLM,再决定继续还是作答 |
| KSL | 用提示把检索改写为多跳决策序列,零样本搜索并输出完整路径 |
| KD-CoT | 把多步推理写成多轮问答,每轮向外部系统检索精确知识 |
| ToG | 由 LLM 对关系、实体分支做集束搜索,逐步保留最有价值路径 |
| KnowledgeNavigator | 从问题约束出发选择证据,再整理成提示增强生成 |
| CoT 直接评价 | 同时评价最终答案和中间推理步骤,而不只看答案对错 |
| KG-Agent | 迭代选择工具查询 KG,并用指令数据微调 Agent 能力 |
| AgentTuning | 混合领域 Agent 指令和通用指令,提高多步工具使用能力 |
LLM 可以借助参数知识缓解冷启动,但也可能补出图中没有的边。安全边界是:语言模型负责规划和筛选,图查询负责提供证据,最终答案要能回溯到真实路径。
9. 动态图第一类:增量式知识表示学习
静态模型默认训练集不变;真实 KG 会新增、删除实体和事实。增量学习目标是在保留旧知识的同时,只更新受变化影响的部分,而不是每次全量重训。
| 路线 | 模型 | 课件中的核心设计 |
|---|---|---|
| 多嵌入空间 | PuTransE | 每次更新建立新空间,组合多个空间的三元组分数 |
| 锚点定位 | ABIE | 用 k-shell 找关键锚点,新知识只在锚点确定的空间中训练 |
| 持续学习 | CKGE | 分层学习新三元组,并用增量蒸馏保留旧知识 |
| 持续学习 | LKGE | 掩码自编码更新表示,再用迁移机制注入新实体和关系 |
| 自适应更新 | AIR | 估计三元组重要性,只更新最受变化影响的知识并传播嵌入 |
| 删除感知 | TIE | 用已删除三元组作负样本,只用新增三元组微调 |
| 空间变换 | RotatH / MMRotatH | 在超平面旋转更新;后者还能处理新实体的未见模态 |
| 局部子图 | DKGE / Navi | 将更新影响限制在上下文或局部邻域 |
| 在线局部更新 | UOKE / KGCR | 用 R-GCN、正则化、高阶路径等平衡新旧知识 |
选择标准很直白:更新很频繁就优先局部或在线方法;若最担心灾难性遗忘,就关注蒸馏、迁移和新旧平衡机制。
10. 动态图第二类:时序知识图谱推理
时序 KG 把三元组扩展为事件四元组 。课件将方法分为五组。
10.1 时间嵌入表示
| 方法 | 时间怎样进入模型 |
|---|---|
| TA-TransE | 把时间与谓词组合为序列,用 LSTM 编码时间化关系 |
| HyTE | 把实体和关系投影到时间特定的超平面 |
| TERO | 把时间从超平面投影改成复数旋转 |
| TARGAT | 图注意力学习时间感知邻域,再用 Temporal Transformer 编码事件 |
| LCGE | 融合时间嵌入,并以自动挖掘的时序规则正则化关系表示 |
10.2 事件演化学习
| 方法 | 怎样利用历史 |
|---|---|
| Know-Evolve | 从历史事件演化建立因果关联,预测未来事件 |
| RE-Net | GCN 编码每个时刻的子图,GRU 编码历史子图序列 |
| EvolveRGCN | 不直接编码子图序列,而让每个时刻的 GCN 权重随时间演化 |
| CyGNet | 用时间感知复制机制识别并复用重复事件 |
| CluSTeR | 先用 MDP 搜索一、二跳历史证据,再做时序推理 |
10.3 时序规则学习
StreamLearner 给静态规则加入“体先于头”的时间属性;TLogic 用时序随机游走保证规则体时间有序;TILP 搜索含时间区间的规则并过滤;TEILP 进一步使用可微随机游走并为规则关联条件概率密度;NeuSTIP 以神经—符号机制联合规则语言、时间一致性和置信度。
10.4 时序多步路径
- xERTE:用时间约束的图注意力扩展和剪枝可解释子图;
- TPath:把时间写进强化学习的状态、动作和奖励;
- T-GAP:GNN 编码查询上下文,按时间顺序传播实体注意力;
- RTTI:用时间戳中值与表示变化编码时间区间,再进行强化学习搜索。
10.5 大模型路线
| 方法 | 做法 |
|---|---|
| PPT | 把时序补全变成带时间间隔提示的掩码预测 |
| ECOLA | 联合事件四元组与描述文本,设计词语、实体、谓词三类掩码任务 |
| GPT-NeoX 路线 | 检索最近历史事件作上下文,把输出解码为实体分布 |
| CSProm-KG | 用事件、实体和关系生成 soft prompt,连接冻结语言模型与 KGE |
| zrLLM | GPT-3.5 生成关系描述,T5 编码后对齐到时序 KGE 空间 |
11. 多模态知识图谱推理
多模态并不是简单把图像向量拼到实体后面。课件依次比较文本增强、模态融合、集成、负采样和预训练模型。
11.1 多模态嵌入
| 路线 | 模型 | 核心做法 |
|---|---|---|
| 文本描述 | DKRL / TEKE / KG-BERT / SimKGC | CBOW/CNN、实体链接上下文、BERT 分类、对比学习文本编码 |
| 图像融合 | IKRL / TransAE / RSME | 把图像对齐到实体空间;RSME 用遗忘门丢弃噪声图像 |
| 深层融合 | HRGAT / MKBE / NativE / MMKGR | 超节点图注意力、把模态当额外三元组、自适应融合、门控注意力多跳推理 |
| 模态集成 | MoSE / IMF | 各模态独立建模,推理时调权或联合三元组分数 |
| 负采样 | MANS / MMRNS | 用视觉信息做细粒度负采样,或用跨模态注意力和对比损失估计采样分布 |
11.2 微调预训练模型
- MKGformer / VISTA:用 ViT 与 BERT 的高层构建多级融合编码器,以掩码预测完成推理;
- SGMPT:增加图结构编码器和双策略融合;
- MMKRL:把多模态和结构知识重构到统一空间并做对齐;
- MoMoK:关系引导的模态专家混合,联合各模态预测。
多模态方法的核心风险是模态缺失、模态质量不均和错误对齐;模型复杂并不自动意味着图像一定有用。
12. 低资源推理:少样本与零样本
课件采用 N-way K-shot 设定:每个关系只有 K 个支持三元组,并且训练、验证、测试关系互不重叠。Wikidata 的长尾统计说明约 10% 的关系不超过 10 个事实,因此这不是边缘场景。
12.1 度量学习
| 方法 | 怎样匹配支持集与查询集 |
|---|---|
| GMatching | 编码实体邻居子图,再比较支持实体对和查询实体对 |
| FSRL | 关系感知邻居编码器 + 循环自编码器聚合多个支持样本 |
| FAAN | Transformer 编码实体对,自适应选择最相关的支持样本 |
| TransAM | 全局—局部注意力同时建模三元组内和三元组间交互 |
| HMNet | 实体感知与关系感知两个匹配网络联合打分 |
| MetaP | CNN 学关系模式,并平衡正负支持样本的模式相似度 |
12.2 元学习
MetaR 从支持实体对得到关系元,再用梯度元快速适应;GANA 用门控图注意力和 BiLSTM 表示支持集,并把 MAML 引入 TransH;SMetaR 用线性映射简化 GANA;Meta-iKG 在长尾关系子图上用 MAML 学 GNN 初始参数;HiRe 从实体、关系上下文、三元组三个层次表示关系元。
12.3 文本、本体与路径补信号
| 外部信息 | 方法 | 作用 |
|---|---|---|
| 文本 | TCVAE / ZSGAN / HAPZSL | 生成额外三元组、由描述生成未见关系表示、注意力原型匹配 |
| 本体 | OntoZSL / DOZSL / DMoG | 用概念层次、属性解耦、本体图与文本图表示未见关系 |
| 路径 | P-INT / EPIRL | 注意力比较支持与查询路径,或用强化学习构造推理子图再匹配 |
少样本仍看过目标关系的少量例子;零样本则必须依靠描述、本体或可迁移结构生成未见关系表示,两者不要混为一谈。
13. 归纳式知识图谱推理
归纳推理的测试图里会出现训练时没见过的实体,甚至是另一张目标图。模型要学习可迁移的结构模式,而不能给每个实体背一个固定向量。
| 路线 | 模型 | 可迁移的东西 |
|---|---|---|
| 图搜索 | CBGNN | 循环空间中的规则表示 |
| 虚拟邻居 | VN | 用对称路径规则补未见实体邻域,并与 KGE 迭代 |
| 路径 + 编码 | ARGCN / ELPE | GCN 或 Graph Transformer 编码未见实体,RL 搜路径作解释 |
| 子图与路径 | NBFNet | 用 INDICATOR、MESSAGE、AGGREGATE 三个算子统一路径与 GNN |
| 局部子图 | GraIL | 根据实体对周围子图预测关系,学习与实体身份无关的语义 |
| 上下文与路径 | PathCon / SNRI / REPORT | 关系消息传递,或分别用 GNN、GRU、Transformer 编码子图与路径 |
| 对比学习 | LogCo / RPC-IR | 用正负关系路径构造更充分的自监督信号 |
| 全局—局部聚合 | CG-AGG | HGNN 全局聚合器 + GNN 局部聚合器 |
| 邻居加权 | SAGNN / LAN | 按拓扑频率或逻辑注意力给未见实体邻居赋权 |
区分三个容易混淆的概念:
- 增量式:同一张图在更新,重点是快速更新与不遗忘;
- 时序式:事实带时间,重点是事件演化和时间约束;
- 归纳式:测试时出现未见实体或新图,重点是可迁移结构。
14. 用问题类型选择方法
静态、实体都见过
├── 要规则解释 → 规则学习 / 规则增强 KGE
├── 要多跳证据 → PRA / RL 路径 / LLM 搜图
└── 只要高效补全 → KGE

图在变化
├── 只关心新增删除 → 增量式 KGE
└── 事实本身带时间 → 时序推理

信息不只结构
├── 有描述或图像 → 多模态推理
└── 关系样本极少 → 少样本 / 零样本

测试出现未见实体或目标图
└── 归纳式推理
这棵树比背几十个缩写更重要:先判定任务假设,再看模型怎样利用信息,最后才记代表模型。
15. 本讲小结
复杂场景下的知识表示学习与推理
├── 复杂映射:关系感知投影 / 高斯、流形、李群空间
├── 关系模式:复数三线性 / 成对映射 / 旋转
├── 层次关系:Poincaré / HAKE
├── 静态推理:规则 / 随机游走 / 强化学习 / LLM 搜图
├── 动态推理:增量更新 / 时序事件
├── 额外模态:文本 / 图像
├── 低资源:少样本 / 零样本
└── 归纳式:迁移到未见实体或目标图