第十讲 · 知识表示学习与推理基础
对应 PPT:第10讲 重点:KGE 动机、四类经典模型、TransE、复杂关系变种、路径与规则增强、实体类型、文本和新场景推理。
1. KGE 基本概念
1.1 基于归纳的 KG 推理分类
基于图结构的推理       (第9讲:PRA、强化学习)
基于规则学习的推理     (第9讲:AMIE)
基于表示学习的推理     (KG Embedding,本讲)
1.2 传统大规模 KG 的 2 大问题
① 计算效率问题
- 可移植性差:需要设计专门的图算法
- 可扩展性差:基于图的算法复杂度高
- 难满足实时计算需求
② 数据稀疏问题
- 长尾分布:对长尾实体的计算准确率很低
- 大量实体/关系的语义信息未被利用
1.3 KGE 核心思想
把知识图谱嵌入到低维向量空间。
- 实体 → 低维向量
- 关系 → 低维向量或矩阵/操作
- 通常 10/20/50 维
3 大优势:
- 显著提升计算效率
- 有效减少数据稀疏
- 便于多源数据融合
1.4 KGE 解决什么任务
知识图谱补全通常给定三元组中的两个元素,预测缺失实体:
KGE 先把符号实体和关系变成可计算的数值表示,再用打分函数衡量候选三元组是否可信。训练时让真实三元组得分优于负样本,测试时把候选实体排序,再用 MR、MRR 和 Hits@n 评价正确答案的位置。
理解一个模型时可以依次问:实体和关系表示成什么、二者怎样交互、除了当前三元组还使用了哪些信息。
2. KGE 典型模型的 4 种类别
| 类别 | 代表模型 | 特点 |
|---|---|---|
| 基于翻译(TransE 系列) | TransE / H / R / D / RotatE | 用平移或旋转等操作建模关系 |
| 基于张量分解 | RESCAL / DistMult / HolE / ComplEx | 双线性或多线性交互 |
| 基于神经网络 | NTN / ConvE / ConvKB / KG-BERT | 深度学习 |
| 基于图神经网络 | R-GCN / KGAT / KBAT | 关系图卷积 |
3. 经典模型详解
3.1 TransE(最经典,NeurIPS 2013)
核心思想:
把关系看成从头实体到尾实体的翻译(平移)。 几何上看:从 h 平移 r 到达 t。
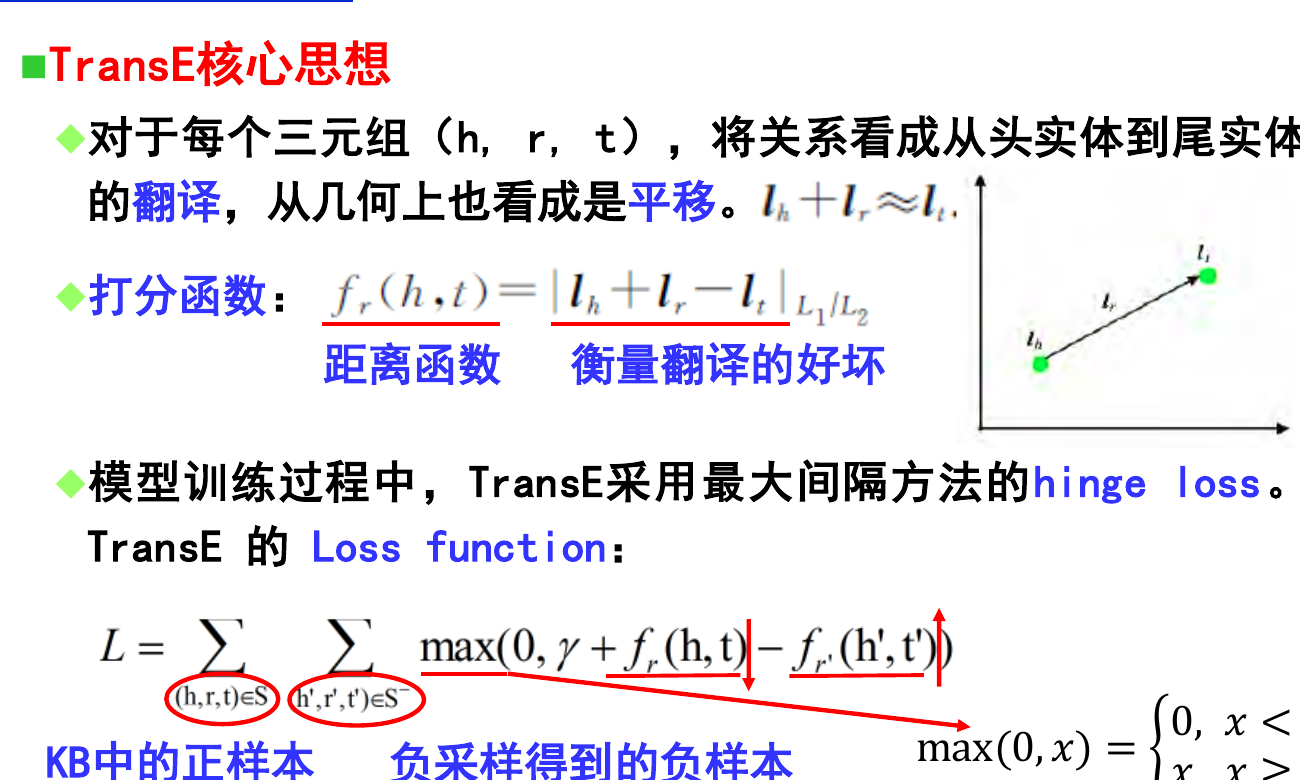
打分函数(距离函数):
下标 表示实现时可以选择 L1 或 L2 范数;不变的是正确三元组的平移距离应该较小。
平移不变量:
损失函数(hinge loss + 负采样):
- = 正样本(KB 中的三元组)
- = 负样本(采样得到)
- = 边际超参数(margin)
- = hinge 损失
负样本通常通过替换头实体或尾实体得到。训练前应过滤已经存在的真三元组,避免把它们当成负例;Bernoulli 负采样还会根据关系的 1-N、N-1 特性调整替换哪一侧。
训练流程(5 步):
① 输入:实体集合、关系集合、边际参数、向量维度
② 初始化:实体向量 e、关系向量 l
③ 从 KB 采样 minibatch
④ 负采样:构造负样本三元组
⑤ 最小化目标函数,计算梯度,更新参数
3.2 TransE 的局限
- 简单模型,难处理一对多、多对一、多对多关系
- 例:(中国, 有城市, 北京) 和 (中国, 有城市, 上海) → 强制北京 ≈ 上海 ❌
- 对对称关系会得到 (错误)
- 无层次关系建模
3.3 RESCAL(张量分解经典,ICML 2011)
核心思想:KG = 1 个三阶张量(每种关系 1 个切片)。
打分函数:
- = 关系 r 的关系矩阵
- 还原三阶张量
3.4 NTN(神经网络经典,NeurIPS 2013)
核心思想:每个关系 1 组神经网络参数。
打分函数:
- 表达能力强,但参数多、训练慢
3.5 R-GCN(图神经网络,ESWC 2018)
核心思想:用 GCN 聚合实体邻域信息,可建模关系。
R-GCN 主要负责沿不同关系聚合邻居并得到实体表示,完成链路预测时还要接 DistMult 等解码器。笼统写成 只能表示“这里需要一个解码评分”,并不是 R-GCN 独有的完整打分函数。
3.6 KG-BERT(Transformer,arXiv 2019)
- 用 BERT 对三元组做分类
- 表达力强,但不能扩展到大 KG
4. 复杂关系建模
4.1 复杂映射特性
| 关系类型 | 含义 | 例子 |
|---|---|---|
| 1-1 | 一对一 | (北京, 首都, 中国) |
| 1-N | 一对多 | (中国, 有城市, 北京) 和 (中国, 有城市, 上海) |
| N-1 | 多对一 | (小明, 出生于, 北京) 和 (小强, 出生于, 北京) |
| N-N | 多对多 | (本泽马, 效力于, 皇家马德里) |
4.2 TransH(AAAI 2014)
核心思想:每个关系 r 对应一个超平面(法向量 ),实体向量投影到超平面再平移。
投影公式:
打分函数:
优点:解决一对多问题(同一实体在不同关系下投影到不同超平面)。
4.3 TransR(AAAI 2015)
核心思想:实体和关系在不同空间——每个关系 r 有投影矩阵 ,将实体从实体空间投影到关系空间。
投影公式:
打分函数:
优点:分离实体/关系空间,表达更灵活;缺点:参数多。
4.4 RotatE(ICLR 2019)
核心思想:关系 r 看成复数空间中的旋转操作。
打分函数:
- = 复数乘法(元素级 Hadamard 积)
- 的每个分量是模长为 1 的复数(纯旋转,无缩放)
RotatE 能建模的关系模式:
| 模式 | 含义 | 例子 |
|---|---|---|
| 对称关系 | 自身对称 | 朋友、配偶 |
| 反对称关系 | 反对称 | 老师 |
| 逆反关系 | 球员 ↔ 效力于 | |
| 组合关系 | 出生于+位于=国籍 |
RotatE 的特点是能在同一套旋转表示中建模对称、反对称、逆关系和组合关系。
5. 引入路径信息的 KGE
5.1 动机
- 传统 KG Embedding 完全依赖三元组 → 缺乏可解释性
- 路径包含更丰富的语义关联
- 但路径表示完全数据驱动 → 误差累积
5.2 PTransE(EMNLP 2015)
- TransE + 多跳路径信息
- 3 种路径组合方式:
| 方式 | 含义 |
|---|---|
| 相加 | |
| 相乘 | |
| RNN/LSTM | 用 RNN/LSTM 编码路径 |
5.3 RPJE(Rule and Path Joint Embedding, AAAI 2020)
核心思想:联合嵌入三元组、路径、规则。
打分函数(3 个):
| 评分 | 公式 | 含义 |
|---|---|---|
| 三元组打分 | 评估三元组成立 | |
| 路径打分 | 评估路径与关系匹配 | |
| 关系对打分 | 评估规则中一对关系的距离 |
整体损失:
5.4 推理时(综合评估)
两项都是标量距离,才能直接相加。课件允许搜索长度不超过 的路径;“最大长度设为 效果更好”是该实验中的参数结论。
课件中的实验结论:
- 规则置信度阈值 0.7-0.8 时效果最好(trade-off)
- 最大路径长度 2 比 3 更好
- 引入规则置信度非常重要
6. 规则学习与嵌入迭代:EngineKG
EngineKG 把规则学习和 KG 嵌入放在一个迭代闭环里互相增强,论文将这个过程类比为四冲程发动机。
6.1 4 冲程循环
| 冲程 | 任务 | 输入 | 输出 |
|---|---|---|---|
| 进气 | 规则增强的知识表示学习 | 符号规则 + KG | 增强的 embedding |
| 压缩 | 规则引导的 KG 嵌入 | 高维符号 → 低维向量 | 嵌入表示 |
| 扩张 | 基于 KG 嵌入和路径的规则学习 | 嵌入 + 路径 | 新规则 |
| 排气 | 过滤低质量规则 + 更新规则集 | 候选规则 | 更新后的规则集 |
6.2 迭代方式
- 闭环:规则 ↔ 嵌入互相增强
- 启动只需少量种子规则
- 自动学出更多高质量规则
6.3 课件展示的实验结果
| 方法 | FB15K MRR | FB15K237 MRR |
|---|---|---|
| TransE | 0.534 | 0.289 |
| RotatE | 0.612 | 0.317 |
| PTransE | 0.679 | 0.364 |
| RPJE | 0.811 | 0.443 |
| EngineKG | 0.854 | 0.555 |
在课件展示的这组实验中,EngineKG 优于表中所列 baseline;这个结论只对应相同数据集和评测设置。
7. KGE 的 3 个评价指标
7.1 测试方法
测试样本:(h, r, ?)
          ↓
候选三元组:(h, r, e₁), (h, r, e₂), ..., (h, r, e_N)
          ↓
计算每个候选的分数
          ↓
排名
7.2 3 大指标
| 指标 | 公式 | 含义 |
|---|---|---|
| MR(Mean Rank) | 正确实体的平均排名(越小越好) | |
| MRR(Mean Reciprocal Rank) | 平均倒数排名(越大越好) | |
| Hits@n | 正确实体排在前 n 的比例 |
指标方向:MR 越小越好,MRR 和 Hits@n 越大越好。
8. OpenKE 平台(清华开源)
| 维度 | 内容 |
|---|---|
| 开发 | 清华 NLP 实验室(刘知远、孙茂松) |
| 整合算法 | TransE/H/R/D、RESCAL、DistMult、HolE、ComplEx 等 |
| 数据集 | FB15K、FB15K237、WN18、WN18RR |
| 底层 | C++ 多线程加速 |
| 版本 | PyTorch / TensorFlow / C++ |
| 主页 | http://openke.thunlp.org |
| GitHub | https://github.com/thunlp/OpenKE |
9. 知识图谱推理方法对比
| 类别 | 子类 | 优点 | 缺点 |
|---|---|---|---|
| 基于 KG 嵌入 | 翻译模型 | 效率高、泛化性好 | 不具有可解释性 |
| 张量分解 | |||
| 神经网络 | |||
| 图神经网络 | |||
| Transformer | |||
| 基于规则学习 | 归纳逻辑编程 | 精度高、可解释 | 鲁棒性不足、效率低 |
| 神经网络规则学习 | |||
| 规则 + 嵌入 | |||
| 基于路径 | 路径搜索 | 多步推理能力 | 缺乏精确路径表示 |
| 路径 + 嵌入 |
10. 给 KGE 增加实体类型:TKRL、AutoETER 与 CAKE
只用事实三元组时,模型知道“姚明—出生于—上海”,却未必显式知道“人—出生于—地点”。类型信息能提供更稳定、更接近常识的约束。
10.1 TKRL:让层次类型参与投影
TKRL 把实体的层次类型一起编码。一个实体可能同时属于多层概念,例如“姚明 → 体育人物 → 人物”;面对不同关系,模型选择相应的类型投影,再评价三元组。它解决的是“同一个实体在不同语义视角下应该有不同表示”。
10.2 AutoETER:自动学习关系相关的类型表示
AutoETER 同时处理三部分:
- 编码事实三元组;
- 把实体换成类型,编码类型三元组;
- 用约束让实体表示与类型表示彼此一致。
关键点是关系决定关注哪种类型。面对“周杰伦—演唱—七里香”,应突出“歌手”;面对“周杰伦—出演—头文字 D”,应突出“演员”。
10.3 CAKE:常识指导负采样,再由粗到细推理
CAKE 针对三个问题:实体与常识图谱链接不足、随机负采样容易产生假阴性或荒谬样本、实体类型没有结合关系语义。它的链路是:
事实三元组
  → 实体替换为类型,自动生成常识三元组
  → 按 1-1 / 1-N / N-1 / N-N 选择类型一致的高质量负样本
  → 先做类型级粗筛
  → 再做实体级细排
例如由 (David, Nationality, U.S.A.) 得到 (Person, Nationality, Country);预测 David 的国籍时先筛选 Country 类型,再对该类型下的候选实体打分。这样比在全体实体中盲猜更符合常识,也更高效。
11. 给 KGE 增加文本:DKRL 与 LambdaKG
11.1 DKRL
DKRL 同时保留实体的结构表示和描述文本表示。课件给出两种文本编码器:
- CBOW:把描述中的词向量相加,快但忽略词序;
- CNN:通过卷积保留局部词序和模式。
文本既能区分结构上相似的实体,也能为图中刚出现、连接很少的新实体提供初始表示。
11.2 LambdaKG
LambdaKG 是面向预训练语言模型知识图谱嵌入的工具库。这里应记住的不是一个新几何公式,而是工程边界:它把结构化三元组转成语言模型可处理的输入,并统一训练、负采样和评测流程,方便比较 KG-BERT 一类方法。
12. 知识图谱推理的新进展
12.1 强化学习:把找路径改写成 MDP
从头实体出发走到答案实体,可以写成马尔可夫决策过程:
- 状态:当前实体、查询关系以及已走路径;
- 动作:选择当前实体的一条出边及下一实体;
- 奖励:是否到达正确答案,也可给有用的中间路径软奖励;
- 策略:让期望累计奖励最大。
这类方法能给出可解释路径,但动作空间大、终点奖励稀疏,容易训练不稳定。
12.2 小样本:MetaR 学“怎样快速学一条新关系”
传统 KGE 假设每条关系都有足够三元组,现实中的关系却是长尾分布。MetaR 从少量支持样本提炼两种可迁移信息:
- 关系元:同一关系的支持三元组共享的关系表示;
- 梯度元:用少量梯度更新快速适应该关系。
目标不再是把每条长尾关系从头训练好,而是学习一种“看到几个例子就能适应”的能力。
12.3 Transformer:KG-BERT 与 CSProm-KG
| 方法 | 做法 | 边界 |
|---|---|---|
| KG-BERT | 把实体、关系及文本串联,交给 BERT 判断三元组真假 | 语义强,但逐候选编码,难扩展到超大候选集 |
| CSProm-KG | 用头实体和关系嵌入生成条件 soft prompt,再让 KGE 模型预测尾实体;加入相似困难负样本 | 冻结大模型可节省训练量,但仍依赖提示与候选设计 |
12.4 多模态与时序
- IKRL:编码实体图像,并把视觉表示融合进实体嵌入,再沿用 TransE 式交互。
- RE-Net:把不同时刻发生的事件看成序列,用子图聚合与循环网络建模历史事件,再预测当前事件。
它们分别回答两个问题:实体不只有结构和文字怎么办?同一事实会随时间变化怎么办?
13. LLM 与知识图谱推理的三条路线
课件最后用三幅图概括了三种结合方式:
- LLM 增强 KGE:从实体、关系描述中抽取文本表示,作为结构嵌入的额外信号。
- LLM 作为编码器或解码器:编码三元组或候选证据,再输出三元组成立概率或答案。
- LLM 作为 Agent:让模型反复选择查询工具、搜索图路径、读取结果并决定是否继续。
三者的主要差别不是“用了多大的模型”,而是 LLM 介入推理链的位置。越靠近 Agent,过程越灵活,也越需要限制动作、验证图证据并处理幻觉。
14. 按问题选择方法
| 遇到的问题 | 优先想到的路线 |
|---|---|
| 基础链路预测、追求速度 | TransE / DistMult 等轻量 KGE |
| 1-N、N-1、N-N | TransH / TransR / TransD |
| 需要路径和规则解释 | PTransE / RPJE / EngineKG |
| 类型决定语义 | TKRL / AutoETER / CAKE |
| 新实体结构边很少但有描述 | DKRL / 预训练语言模型 |
| 长尾新关系只有几个样本 | MetaR |
| 有图像 | IKRL |
| 事实随时间演化 | RE-Net 等时序模型 |
| 需要多轮查询与工具使用 | LLM Agent,但必须以图证据校验 |
15. 本讲小结
知识表示学习与推理基础
├── 补全任务:(h,r,?) / (?,r,t)
├── 四类 KGE:翻译 / 张量分解 / 神经网络 / 图神经网络
├── TransE:L1 或 L2 平移距离 + 负采样 + 间隔损失
├── 复杂关系:TransH / TransR / RotatE
├── 路径与规则:PTransE / RPJE / EngineKG
├── 额外信息:类型 / 文本 / 图像 / 时间
├── 新场景:强化学习 / 小样本 / Transformer / LLM Agent
└── 评价:MR / MRR / Hits@n