第九讲 · 知识推理:规则、路径与大模型
(updated 2026年8月23日)
对应 PPT:第9讲 重点:推理的分类、基于逻辑的推理、AMIE 规则学习、基于图结构的 PRA、强化学习多跳推理。
1. 推理概述
1.1 推理的定义
推理是通过已有知识推断出未知知识的过程。 是认知世界的重要途径:思考、认知、理解。
1.2 为什么 KG 需要推理
- 大部分开放 KG(Freebase、DBpedia)由人工或半自动构建
- KG 通常并不完备,大量实体间的隐含关系没有被记录
- **知识图谱补全(KGC)**预测尚未存储的事实,为后续查询补充候选证据
- **知识库问答(KBQA)**依赖图谱中可用的事实,因此可由 KGC 提供支撑;两者不是同一个任务
2. 推理的四类基本形式
2.1 演绎推理(自上而下,top-down)
- 给定前提 → 推断必然成立的结论
- 3 种形式(重点记例子):
| 形式 | 含义 | 例子 |
|---|---|---|
| 肯定前件假言推理 | 肯定前件 → 肯定后件 | ”如果今天是星期一 → 小明上 KG 课” + “今天是星期一” → “小明上 KG 课” |
| 否定后件假言推理 | 否定后件 → 否定前件 | ”如果今天星期一 → 小明上 KG 课” + “小明不上 KG 课” → “今天不是星期一” |
| 假言三段论 | 两个假言串联 | ”好好学习 → 好工作” + “好工作 → 好收入” → “好好学习 → 好收入” |
2.2 归纳推理(自下而上)
- 基于已有部分观察得出一般结论
- 2 种形式:
| 形式 | 含义 | 例子 |
|---|---|---|
| 归纳泛化 | 个体观察 → 整体结论 | 抽样 4 球中 3 白 1 黑 → 推断 20 球中约 15 白 5 黑 |
| 统计推理 | 整体统计结论 → 个体 | 90% 高中生上大学 + 小明是高中生 → 小明 90% 上大学 |
需要区分:统计推理把统计的“群体结论”应用到个体,归纳泛化则从个体推向整体。
2.3 溯因推理
- 已知观察 O + 知识 T → 推断最简单、最可能的解释 E
- 例:T=“下雨 → 马路湿” + O=“马路湿” → E=“下雨了”
- 结论是对观察的可能解释,不保证必然成立
2.4 类比推理
- 在两个事物间找类比信息,把已知事物的结论迁移到新事物
- 例:小明和小红同龄、都喜欢 A 和 B、小明还喜欢 C → 小红也可能喜欢 C
3. 面向 KG 的推理:3 大方法
| 方法 | 代表 |
|---|---|
| 基于逻辑的推理 | FOPL 规则、描述逻辑、AMIE |
| 基于图结构的推理 | PRA(Path Ranking Algorithm) |
| 基于表示学习的推理 | TransE 等(第 10、11 讲) |
4. 基于逻辑的知识推理
4.1 规则的一般形式
- 规则主体(body)由若干个原子(atom) 逻辑合取组成
- 原子 = 含变量的元组(一元或二元)
例子:
isLocation(X)是一元原子hasWife(X, Y)是二元原子
4.2 规则的肯定/否定形式
body+= 以肯定形式出现的原子的合取body-= 以否定形式出现的原子的合取
例:
- 若 X 的妻子是 Y,Y 的孩子有 Z,且 X 和 Y 不曾离婚 → X 的孩子有 Z
- 这里的”不曾离婚”是否定原子
4.3 规则的 3 种类型
| 类型 | 形式 | 表达能力 |
|---|---|---|
| 一般规则 | head ← body | 最强 |
| 霍恩规则(Horn rules) | (全肯定) | 中 |
| 路径规则(path rules) | 二元原子构成路径 + 闭环 | 最弱 |
包含关系:路径规则 ⊂ 霍恩规则 ⊂ 一般规则
4.4 规则评估的 3 个指标
| 指标 | 公式 | 含义 |
|---|---|---|
| 支持度(support) | support(rule) = 满足 body 和 head 的实例数 | 越大越好 |
| 置信度(confidence) | support(rule) / 满足 body 的实例数 | 越高规则越可靠 |
| 规则头覆盖度(head coverage) | support(rule) / 满足 head 的实例数 | 满足 head 的实例中同时满足 body 的比例 |
基于 PCA(Partial Completeness Assumption)的置信度:在 KG 不完整的假设下估计置信度。
对规则 ,标准置信度把全部规则体匹配放进分母;PCA 置信度只统计那些头实体 已经有至少一条已知 事实的候选:
这样不会把所有“图谱里没记录”的事实直接当成错误,更适合开放世界下的不完整知识图谱。
4.5 AMIE 规则学习算法
AMIE 是从知识图谱中学习 Horn 规则的算法,搜索时重点处理闭式、连通的候选规则。闭式描述的是候选规则中的变量连接方式,不是说 AMIE 本身是一条规则。
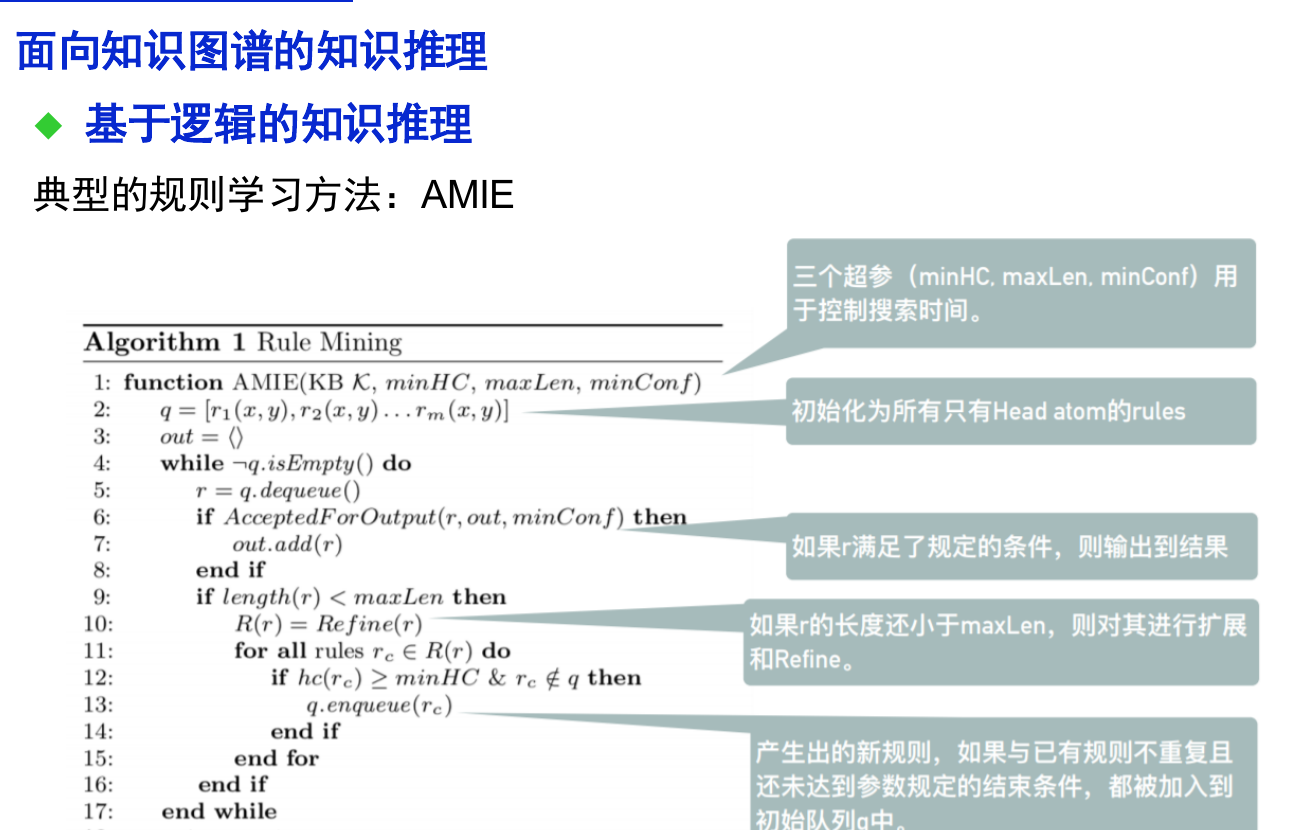
3 个扩展操作:
| 操作 | 含义 |
|---|---|
| 增加悬挂原子 | 增加一个新变量 + 一个已存在元素的原子 |
| 增加闭合原子 | 增加的两个元素都已出现在规则中 |
| 实例化变量 | 把变量替换为具体实体 |
2 个剪枝策略:
- 最低头覆盖度过滤:头覆盖度 < 0.01 → 直接剪掉(边缘规则)
- 置信度单调递增:新加原子必须让置信度增加,否则剪掉
4.6 基于逻辑推理的优缺点
| 优点 | 缺点 |
|---|---|
| 精确 | 大规模 KG 人工提供规则效率低 |
| 可解释 | 难以做到全面和准确 |
| 小型领域 KG 可由专家提供规则 |
5. 基于图结构的知识推理
5.1 PRA(Path Ranking Algorithm)
典型方法:PRA(Path Ranking Algorithm),基于图路径的推理。
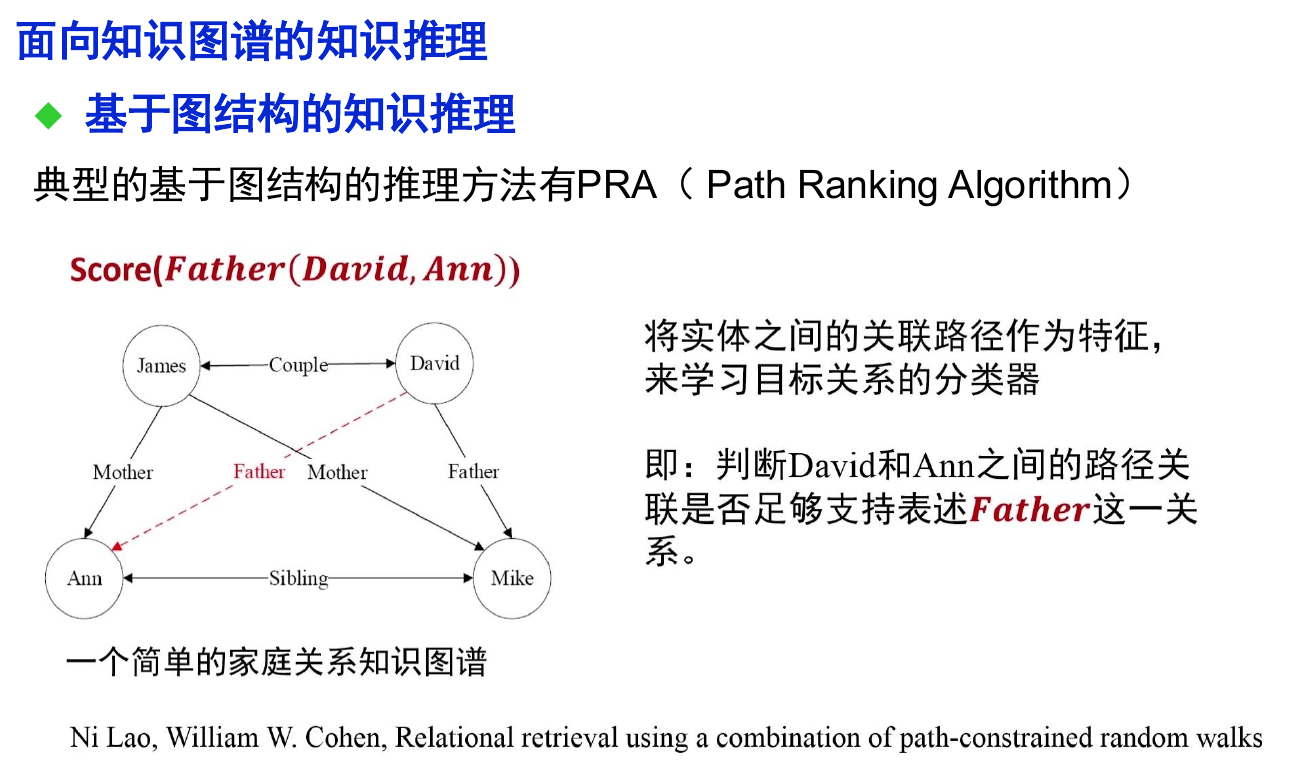
核心思想:
- 生成并筛选一组受关系序列约束的候选路径,不是无条件枚举全图所有路径
- 计算沿路径从源实体到达目标实体的随机游走概率,或用路径存在性、出现频率作为特征
- 用分类器组合路径特征,判断实体对之间是否存在目标关系
优点:能捕捉多跳推理。
6. 基于强化学习和大模型的多跳推理
6.1 结合强化学习的多跳推理
强化学习的 5 个要素:
| 要素 | 在 KG 中的含义 |
|---|---|
| 环境 | 整个知识图谱 |
| 动作 | 当前实体可走的一条关系边及其邻居实体 |
| 状态 | 智能体当前位置(当前实体 embedding + 与目标实体距离) |
| 奖励 | 综合全局正确性、路径效率和路径多样性三个分量 |
| 策略网络 | 两层全连接网络,状态向量 → 动作概率分布 |
训练技巧:
- 类似 AlphaGo:用广度优先搜索学习有监督策略
- 用蒙特卡洛策略梯度更新参数
课件所引方法把奖励拆为三个部分:到达目标实体时给全局奖励; 偏好短路径;路径与已有结果越相似,多样性奖励越低。三者分别约束正确性、效率和结果多样性。
6.2 结合大模型的多跳推理:Think on Graph (ToG)
ToG:用 LLM 作为智能体,在 KG 上做 beam search,让 LLM 沿着相关路径推理。
核心:
- 从问题中识别主题实体,在当前深度展开相邻关系和实体
- 让 LLM 对候选分支打分并剪枝,只保留 beam 中最相关的子图
- 基于保留事实尝试推理;证据不足时继续下一深度
- 证据足够或达到停止条件后,输出答案及其关系路径
LLM 负责相关性判断和语言推理,知识图谱负责提供可回溯的事实证据。
7. 本讲小结
知识推理
├── 一般推理:演绎 / 归纳 / 溯因 / 类比
│   └── 统计推理属于归纳推理
├── 逻辑推理
│   ├── 一般规则 / Horn 规则 / 路径规则
│   ├── 支持度 / 标准置信度 / PCA 置信度 / 头覆盖度
│   └── AMIE:扩展候选规则并剪枝
├── 图结构推理
│   └── PRA:受限路径随机游走特征 + 分类器
├── 强化学习多跳推理
│   └── 状态 / 当前可行动作 / 策略 / 三类奖励
└── ToG
    └── 搜索关系和实体 → LLM 打分剪枝 → 基于图证据作答