第八讲 · 知识存储与检索
对应 PPT:第8讲 重点:RDF 图 vs 属性图、SPARQL vs Cypher、4 种基于关系型数据库的存储方案。
1. 概述
1.1 2 个核心问题
- 如何保存知识图谱?
- 如何查询 / 增加 / 修改 / 删除图谱中的知识?
1.2 存储载体
| 规模 | 存储方式 | 例子 |
|---|---|---|
| 小规模 | 文件 | CSV、TXT |
| 大规模 | 数据库 | 关系型数据库 / 图数据库 |
2. 两种知识图谱数据模型
2.1 图的数学定义
- = 节点集合(Vertices)
- = 边集合(Edges)
2.2 RDF 图(来自语义网)
RDF 图 = 三元组 的有限集。
- 每个三元组 = 1 个陈述(Statement)
- 多个陈述 = 1 个描述(Description)
- 三元组含义:
- 与 之间有 关系
- 或 具有 属性,属性值为
关键:RDF 没有属性图那种直接挂在节点或边上的键值属性;补充信息仍通过三元组表达,描述某条陈述本身时还需要 RDF reification(具体化)等额外机制。
2.3 属性图(来自数据库)
节点性质(4 条):
- 每个节点有唯一 id
- 每个节点有若干出边
- 每个节点有若干入边
- 每个节点有若干属性(键值对)
边性质(5 条):
- 每条边有唯一 id
- 每条边有一个头节点
- 每条边有一个尾节点
- 每条边有标签(关系类型)
- 每条边有若干属性(键值对)
上面的定义可以按节点 4 条、边 5 条分别检查。
2.4 RDF 图 vs 属性图
| 维度 | RDF 图 | 属性图 |
|---|---|---|
| 起源 | 语义网 | 数据库 |
| 属性表达 | 用额外三元组表达 | 节点、边原生携带键值属性 |
| 类型标注 | 类(Class)+ 属性(Property) | 标签(Label)+ 键值对 |
| 查询语言 | SPARQL(W3C 标准) | Cypher(Neo4j) |
Neo4j 实际支持节点 Label,但它不是这页 PPT 所列的四条节点性质之一。
3. 知识图谱查询语言
3.1 SPARQL(RDF 标准查询)
SPARQL = SPARQL Protocol and RDF Query Language W3C 制定的 RDF 图数据标准查询语言;声明式查询语言。
返回形式:XML、JSON、CSV、TSV。
SPARQL 的 7 个核心语法元素
| 元素 | 作用 | 例子 |
|---|---|---|
| URI | 资源唯一标识 | <http://example.com/ontology#> |
| PREFIX | 定义前缀 | PREFIX abc: <http://...> |
| 变量 | ? 或 $ 开头 | ?capital、$country |
| SELECT | 指定返回变量 | SELECT ?capital ?country |
| WHERE | 指定查询条件(三元组模式) | WHERE { ?x abc:cityname ?capital } |
| FILTER | 过滤条件 | FILTER (?year < 2000) |
| OPTIONAL | 可选匹配 | OPTIONAL { ?x abc:phone ?phone } |
常用前缀(W3C 定义)
| 前缀 | 命名空间 | 用途 |
|---|---|---|
rdf: | RDF 核心 | type, Property, Statement |
rdfs: | RDF Schema | Class, subClassOf, label |
owl: | Web Ontology | Class, ObjectProperty |
xsd: | XML Schema Datatype | string, int, date |
foaf: | Friend of a Friend | name, knows |
skos: | Simple Knowledge Organization | Concept, prefLabel |
SPARQL 三元组模式(4 种用法)
| 主语 | 谓语 | 宾语 | 作用 |
|---|---|---|---|
abc:city_cairo | abc:cityname | "Cairo" | 存储内容 |
abc:city_cairo | abc:cityname | ?name | 查城市名称 |
?city | abc:cityname | "Cairo" | 按名字查城市 |
?x | abc:cityname | ?capital | 查所有城市及其名称 |
三元组模式中,哪个位置换成
?x,就是在查询哪个位置的值。
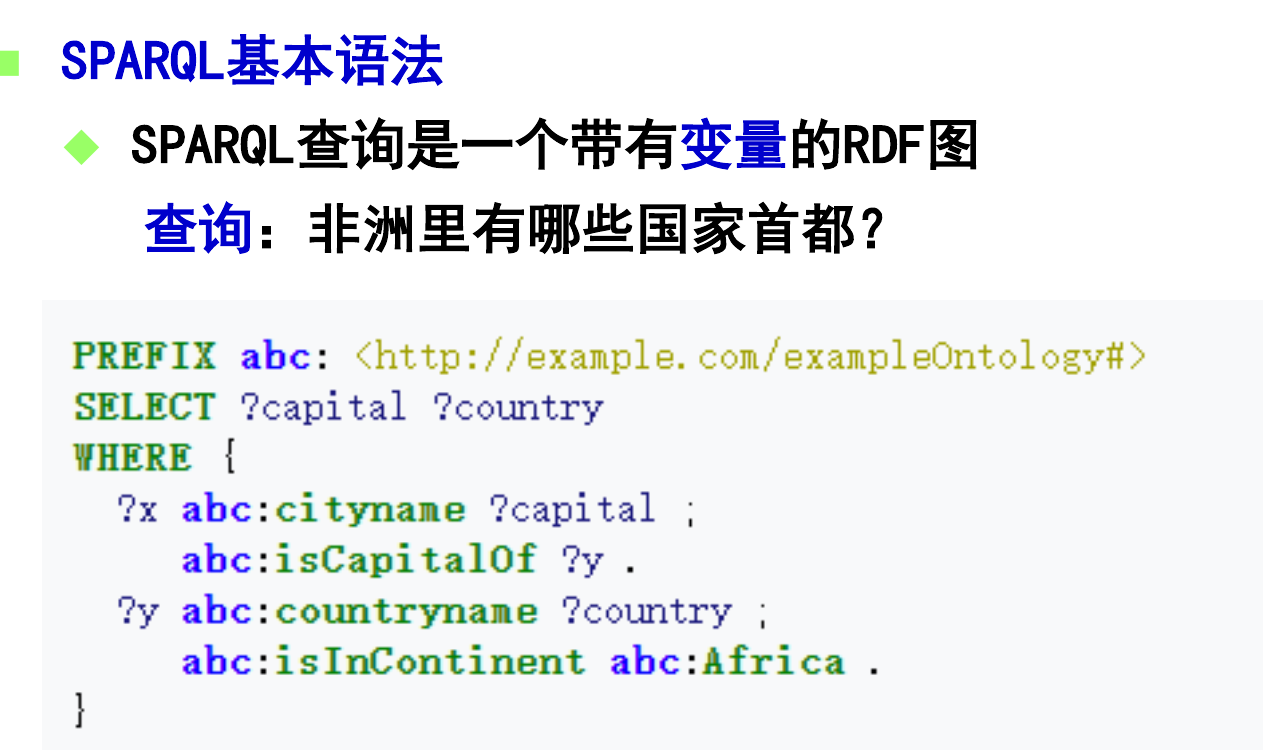
SPARQL 例子:非洲国家的首都
PREFIX abc: <http://example.com/exampleOntology#>
SELECT ?capital ?country
WHERE {
  ?country abc:locatedIn "Africa" .
  ?country abc:hasCapital ?capital .
}
3.2 Cypher(Neo4j 属性图查询)
Cypher 最初由 Neo4j 实现,声明式属性图查询语言。 实现系统:SAP HANA Graph、Redis Graph、AgensGraph、Memgraph。
Cypher 基本语法
节点:
(variable:Label {propertyKey: 'propertyValue'})
// ()
// :Label
// { propertykey: 'value' }关系:
(node1:LabelA)-[rel1:RELATIONSHIP_TYPE]->(node2:LabelB)
// -[]-> 有向
// <-[]- 反向
// -[]- 无向
Cypher 常用查询模式
| 模式 | 例子 |
|---|---|
| Match all nodes | MATCH (n) RETURN n |
| 按 label 查 | MATCH (a:Person) RETURN a |
| 按 label + 属性查 | MATCH (a:Person {name: "Théo Gauchoux"}) RETURN a |
| 按关系查 | MATCH (a)-[:KNOWS]-(b) RETURN a, b |
| 带 WHERE | MATCH (p:Person {name:"Alice"})-[s:LIVES_IN]->(city:City) WHERE s.since = 2015 RETURN p, city |
Cypher 经典例题
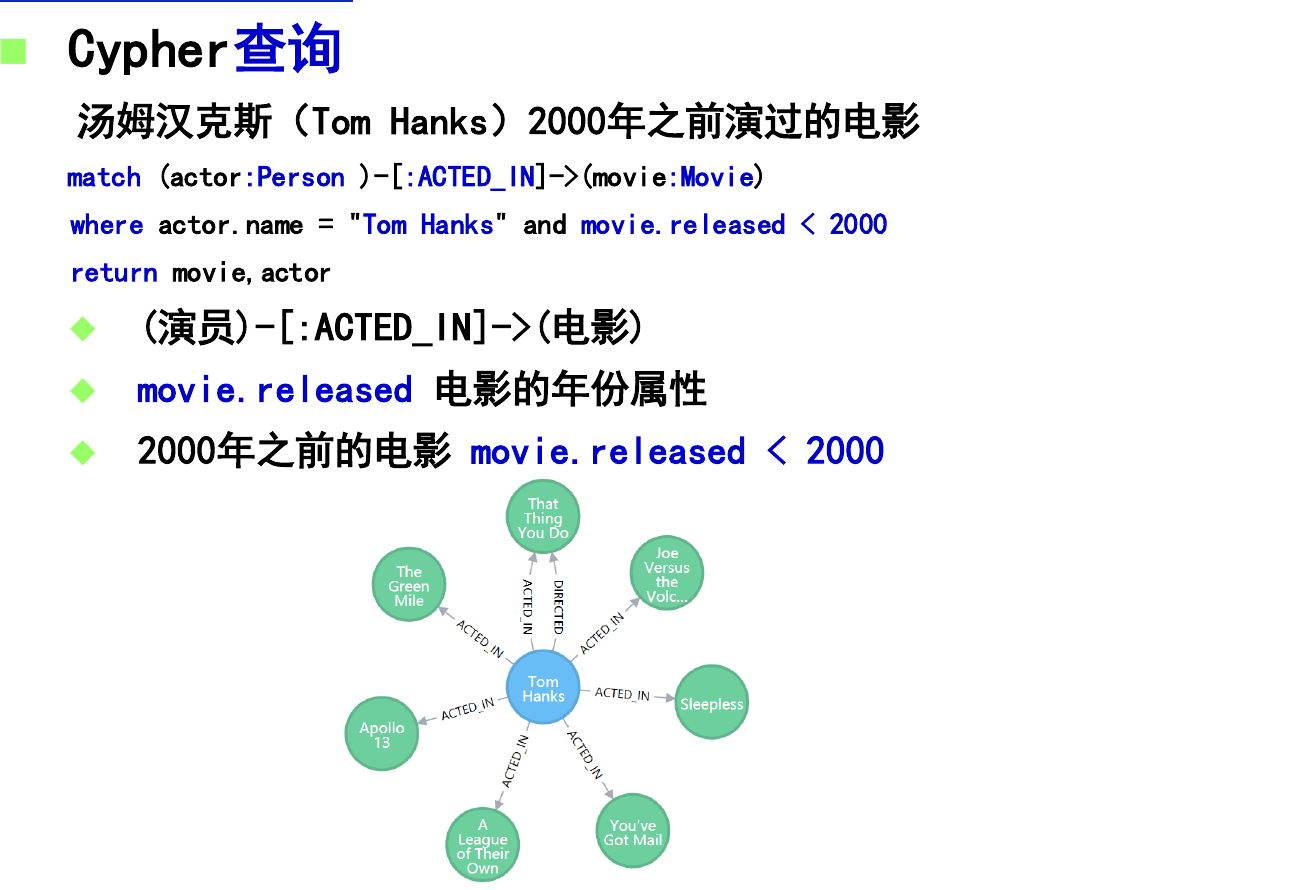
汤姆汉克斯 2000 年之前演过的电影
MATCH (actor:Person)-[:ACTED_IN]->(movie:Movie)
WHERE actor.name = "Tom Hanks" AND movie.released < 2000
RETURN movie, actor
这类查询通常按
MATCH、WHERE、RETURN三部分来写。
4. 常见知识图谱存储方法(4 大类)
4.1 三元组表(最简单)
- 每条记录 = 1 个三元组
(Subject, Predicate, Object) - 最简单、最直接
- 缺点:复杂查询需要大量自连接(self-join),性能低下
复杂度:
- 5 跳路径 → 5 个 JOIN
- 图模式匹配 → 指数级组合
- 一般:( = 表大小, = JOIN 次数)
例子:“找某人朋友所在公司的位置”
SELECT t3.o
FROM Triple t1
JOIN Triple t2 ON t1.o = t2.s
JOIN Triple t3 ON t2.o = t3.s
WHERE t1.s = 'A' AND t1.p = 'friendOf'
  AND t2.p = 'worksAt' AND t3.p = 'locatedIn';
4.2 水平表
- 每一行 = 1 个主语 + 全部谓语和宾语
- 缺点:不同主语谓语数量不同 → 列数 = 全部谓语数量总和 → 表结构改造成本高
4.3 属性表
- 水平表的细化:同类主语分到一张表
- 缺点:表类型过多性能低;不能彻底解决列数问题
4.4 垂直划分
- 以谓语为划分维度
- 为每种谓语建立 1 张表
- 缺点:表类型过多,复杂查询开销大
4.5 4 种方法对比
| 方法 | 优点 | 缺点 | 适用 |
|---|---|---|---|
| 三元组表 | 最简单、灵活 | 自连接性能差 | 小规模 / 简单查询 |
| 水平表 | 查询快 | 列数固定、改造难 | 谓语稳定的场景 |
| 属性表 | 比水平表更细 | 表多、复杂查询差 | 同类主语多 |
| 垂直划分 | 谓语查询快 | 复杂查询慢 | 简单分析场景 |
实际工业界更多用专门的 RDF 三元组库或图数据库(见下),而不是关系型数据库。
5. 面向 RDF 的三元组数据库
5.1 Eclipse RDF4J(开源标准)
- 开源 RDF 三元组数据库
- 支持 SPARQL 1.1
- 模块化设计,GraphDB 上层标准框架以 RDF4J 为标准
5.2 AllegroGraph(商业强大)
- 支持 SPARQL 1.1
- 推理机很全:
- RDFS++ 推理机
- OWL2 RL 推理机
- Prolog 规则推理系统
- 时空推理机制
- 社会网络分析库
- 可视化 RDF 图浏览器
6. 基于 Neo4j 的知识图谱存储与检索
6.1 Neo4j 概述
| 维度 | 内容 |
|---|---|
| 模型 | 属性图 |
| 社区版 | 单机(免费) |
| 企业版 | 集群 / 高可用(付费) |
| 查询语言 | Cypher |
| 安装 | Java + Neo4j 安装包 |
| 在线 | Neo4j Aura(云服务,免费版) |
6.2 安装步骤
① 安装 Java 虚拟机
② 下载 Neo4j(https://neo4j.com/download/)
③ 设置环境变量:Path 加 Neo4j bin 路径
④ 管理员身份 CMD 运行:neo4j.bat console
7. 查询语义与 Neo4j 操作
7.1 同一个问题如何落到两种查询语言
SPARQL 的查询条件本身仍是一张“带变量的 RDF 图”。例如查询北航隶属机构的名字,要让三个三元组模式通过变量相接:
SELECT ?name
WHERE {
  ?university <http://example.org/名称> "北航" .
  ?university <http://example.org/隶属于> ?organization .
  ?organization <http://example.org/名称> ?name .
}
Cypher 则直接画出节点—关系模式,并从匹配到的节点读取属性:
MATCH (university:University {name: '北航'})-[:隶属于]->(organization:Organization)
RETURN organization.name
两者的思路相同:先描述要匹配的局部图,再指定返回值。区别是 RDF 把名称也表达成三元组,属性图则把 name 放在节点的键值属性里。
7.2 Neo4j 的增删改查
课件不仅讲查询,还列出了创建节点和关系、增改属性、删除属性、删除节点和关系等操作。可以用下面这一组最小命令串起来理解:
CREATE (university:University {name: '北航'})
RETURN university
MATCH (university:University {name: '北航'})
MERGE (city:City {name: '北京'})
MERGE (university)-[:位于]->(city)
SET university.FOUNDED_IN = 1952
RETURN university, cityMATCH (university:University {name: '北航'})
REMOVE university.FOUNDED_INMATCH (:University {name: '北航'})-[relation:位于]->(:City {name: '北京'})
DELETE relationMATCH (node {name: '北航'})
DETACH DELETE nodeDELETE node 只能删除没有关系的节点;DETACH DELETE node 会先删除相连关系。清空当前数据库可写成 MATCH (node) DETACH DELETE node,执行前必须确认数据范围。
批量导入时,把 UTF-8 CSV 放入 Neo4j 的 import 目录:
LOAD CSV WITH HEADERS FROM 'file:///example_node.csv' AS line
MERGE (:Node {id: line.id, name: line.name})
LOAD CSV WITH HEADERS FROM 'file:///example_relation.csv' AS line
MATCH (source:Node {id: line.START_ID}), (target:Node {id: line.END_ID})
MERGE (source)-[:REL {type: line.TYPE}]->(target)Python 侧的 py2neo 相当于连接器;建立 Graph 后,可用 graph.run("MATCH ...") 发送 Cypher。查询语义仍由 Cypher 决定,py2neo 只负责连接、参数传递和结果封装。
7.3 北航小图谱:任一与同时
课件用“北航—人工智能学院—两门课程”演示了一个容易出错的查询。下面这条语句只要求课程名属于给定集合:
MATCH (department:Department)-[:开设]->(course:Course)
WHERE course.name IN ['人工智能导论', '知识图谱']
RETURN department.name它的语义是“开设了任一门课程的二级单位”,每匹配一门课就产生一行,同一个单位还可能重复出现。即使加 DISTINCT,也只是去重,并不会把“任一”变成“同时”。
要表达“同时开设两门”,可以用两个图模式约束同一个 department:
MATCH (department:Department)-[:开设]->(:Course {name: '人工智能导论'})
MATCH (department)-[:开设]->(:Course {name: '知识图谱'})
RETURN department.name
也可以聚合后要求两个目标课程都出现:
MATCH (department:Department)-[:开设]->(course:Course)
WHERE course.name IN ['人工智能导论', '知识图谱']
WITH department, count(DISTINCT course.name) AS courseCount
WHERE courseCount = 2
RETURN department.name
同一语义在 RDF/SPARQL 中通过两个独立三元组模式表达:
SELECT ?name
WHERE {
  ?department <http://example.org/开设> ?knowledgeGraph .
  ?department <http://example.org/开设> ?introToAI .
  ?knowledgeGraph <http://example.org/名称> "知识图谱" .
  ?introToAI <http://example.org/名称> "人工智能导论" .
  ?department <http://example.org/名称> ?name .
}
这组对照的核心不是背语法,而是先判断自然语言中的量词:是“至少一项命中”,还是“每项约束都要成立”。
8. 本讲小结
知识存储与检索
├── 数据模型:RDF 图 / 属性图
├── 查询语言:SPARQL / Cypher
├── 关系数据库方案:三元组表 / 水平表 / 属性表 / 垂直划分
├── RDF 数据库:RDF4J / AllegroGraph
└── Neo4j:查询、增删改、CSV 导入与图模式量词