第十二讲 · 知识图谱应用
对应 PPT:第12讲(应用1 + 应用2) 重点:问答(KBQA)3 大方法、推荐系统、视觉/跨模态、行业应用。
1. 知识图谱问答(KBQA)总览
1.1 问答系统 4 大历史阶段
| 阶段 | 时间 | 代表 |
|---|---|---|
| 基于模板的问答专家系统 | 1960~ | 早期专家系统 |
| 基于信息检索的问答 | 1990~ | 关键词匹配 + 信息抽取 + 浅层语义 |
| 基于社区的问答 | 2000~ | 百度知道、知乎(依赖网民贡献) |
| 基于知识图谱的问答 | 2010~ | Siri、度秘、Evi、WolframAlpha |
1.2 问答形式(3 类)
| 形式 | 特点 |
|---|---|
| 一问一答 | 单轮、单答案 |
| 交互式问答 | 多轮对话、上下文依赖 |
| 阅读理解 | 基于给定文档回答 |
1.3 问答系统基本组件
自然语言问题 → 问题分析 → 数据匹配 → 构造 query → 答案检索和评估 → 答案
   ↓              ↓           ↓           ↓              ↓
 linguistic     index       ontology    dataset        score
 tools/resources
1.4 KG 问答的核心挑战
将自然语言表达映射为知识图谱元素词汇,解决语义偏差(歧义性、模糊表达)。
例:“苹果有哪几个超过两万的电子产品?”——“苹果”指公司,“两万”指价格阈值。
2. 基本概念
2.1 问句短语
- Wh-words:who / what / which / when / where / why / how
- Wh-words + 名词/形容词/副词:which party / which actress / how long / how tall
2.2 问题类型(九类)
| 类型 | 例子 |
|---|---|
| 谓词型 | ”Who was the first man in space?” / “How far is Earth from Mars?” |
| 列表型 | ”Give me all cities in Germany.” |
| 最高级型 | ”What is the highest mountain?” |
| 对错型 | ”Was Margaret Thatcher a chemist?” |
| 观点型 | ”What do most Americans think of gun control?” |
| 方法型 | ”How do I make a cheese cake?” |
| 解释型 | ”Why did the revenue of IBM drop?” |
| 关联型 | ”What is the connection between Barack Obama and Indonesia?” |
| 比较型 | ”What is the difference between impressionism and expressionism?“ |
2.3 答案类型
| 类型 | 例子 |
|---|---|
| 事实型-Entity | event, color, animal |
| 事实型-Human | group, individual |
| 事实型-Location | city, country |
| 事实型-Numeric | count, distance |
| 事实型-Temporal | date, time |
| 摘要型 | Abbreviation |
| 描述型 | Description |
| 解释型 | Explanation(“How…”) |
| 证据型 | Justification(“Why…“) |
2.4 问题主题
- 例:“What is the height of Mount Everest?” → (geography, mountains)
2.5 领域类型
- 开放域 vs 特定域
- 数据类型:文本 / 图片 / 音频 / 视频
- 多模态问答 / Visual QA
3. KG 问答的 3 类主流方法
| 方法 | 思路 | 优点 | 缺点 |
|---|---|---|---|
| 基于模板 | 手工 SPARQL 模板匹配 | 响应快、准确率高、可回答复杂问题 | 模板库庞大、与真实问题难匹配 |
| 基于语义解析 | 问题 → 逻辑表达式 → SPARQL | 可回答复杂问题(如时序) | 需语义解析器,规则制定繁琐 |
| 基于深度学习 | LSTM/Attention/Memory Network | 无需人工模板、端到端 | 早期通用模型对复杂和时序约束支持不足 |
4. 基于模板的方法
4.1 基本思路
理解问题需要 3 部分:
- 语义结构(与数据集无关):who →
SELECT ?x WHERE { ... } - 领域无关词汇:the most N、more than i N
- 领域相关词汇:具体实体、关系、属性
4.2 TBSL(Template-Based SPARQL)架构
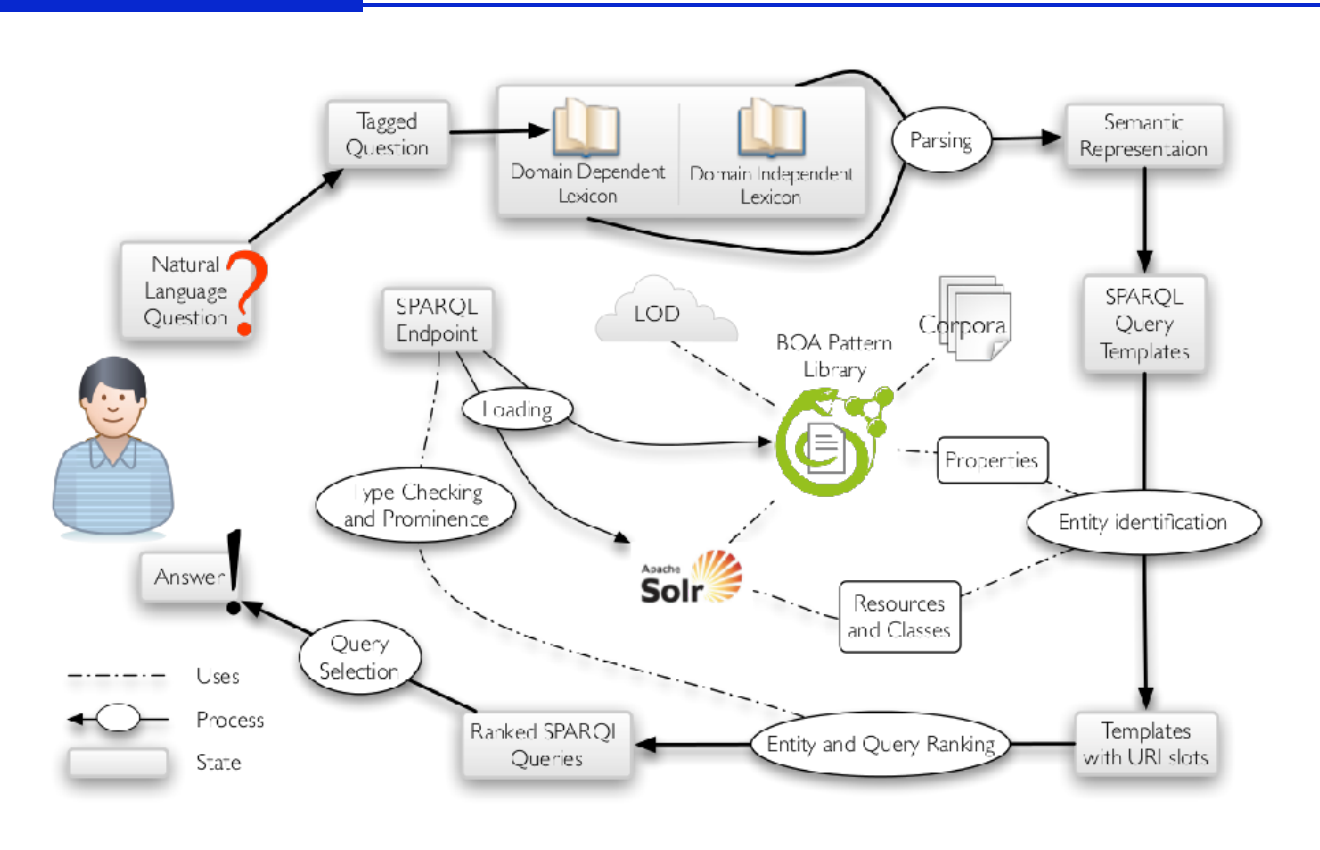
TBSL 是模板方法的经典实现,3 步:
Step 1: 模板生成 — Linguistic Processing
- 词性标注
- 用语法规则表示问句
- 区分 domain-dependent / domain-independent 词汇
- 将语义表示转化为 SPARQL 模板
Step 2: 模板实例化 — 概念识别和关系检测
- 资源(resources)和类(classes):
- 用 WordNet 定义同义词
- 计算字符串相似度
- 属性标签(property labels):与模式库中自然语言表示比较
- 最高排位的概念填充槽位
Step 3: 查询排序和选择
- 每个实体按字符串相似度打分
- 模板分值 = 多个槽位实体的平均打分
- 检查 type 一致性:
?x rdf:type <class>与p的 domain/range 是否一致 - 返回打分最高的查询
4.3 经典例题:Who produced the most films?
SPARQL 模板:
PREFIX dbo: <http://dbpedia.org/ontology/>

SELECT ?producer (COUNT(DISTINCT ?film) AS ?filmCount)
WHERE {
  ?film a dbo:Film ;
        dbo:producer ?producer .
}
GROUP BY ?producer
ORDER BY DESC(?filmCount)
LIMIT 1
dbo:producer 的方向是作品指向制片人。GROUP BY + COUNT + ORDER BY 才完整表达“制作电影最多”;不能因为自然语言里的 “who” 在句首,就把图上的边写反。
4.4 复杂问题处理
- 依存树重写:并列连词、关系从句
- 子问题回答:匹配模板 → 实例化 → 查询 → 排序 → 返回列表
- 答案拼接:子查询打分
1/r(r = 位置),取交集,选不为空 + 组合后得分最高的 query 组合
5. 基于语义解析的方法
5.1 4 步流程
问句 → 语义解析 → 语义表示 → 资源映射 / Logic Form → 候选答案生成 → 排序 → 答案5.2 两种语义表示
| 表示方法 | 特点 |
|---|---|
| 基于符号的表示 | 形式化、可解释(如 λ-calculus) |
| 基于分布式的表示 | 向量化、可融合 DL |
5.3 SP vs IR(重要区别)
| 方法 | 思路 | 适用 |
|---|---|---|
| Semantic Parsing (SP) | 问句 → 逻辑表达式 → 查询 | 复杂问题 |
| Information Retrieval (IR) | 问句 → 候选 → 排序 | 简单问题 |
5.4 语义解析器训练
- 数据:问题-答案对(QA pairs)
- 训练一个语义解析器(神经网络 / 概率模型)
- 学”问句 → 逻辑表达式”的映射
6. 基于深度学习的方法(重要)
6.1 主要模型
| 模型 | 思想 |
|---|---|
| LSTM | 序列建模 |
| Attention Model | 关注重要部分 |
| Memory Network | 外部记忆 + 推理 |
6.2 早期通用深度学习方法的边界
优点:
- 无须像模板方法那样人工编写大量模板
- 也无须像语义解析方法那样制定繁琐的语义规则
缺点:早期 LSTM、Attention、Memory Network 方法主要面向简单、单边关系问题,没有为
first、before、after等约束设计专门操作,因此容易忽略时序语义。
这不是所有深度学习 KBQA 的永久局限。显式时间建模、子图推理或程序生成都可以处理时序问题。
6.3 KEQA / EmbedKGQA / DSSAGN(简单 vs 复杂)
| 模型 | 适用 | 核心 |
|---|---|---|
| KEQA | 简单问句(一阶关系) | 知识表示学习嵌入 + 简单问答 |
| EmbedKGQA | 复杂问句 | BERT 编码复杂问句 + KG 嵌入 |
| DSSAGN | 复杂问句 | 句法 + 语义信息 + 增强 GNN |
| CF-KGQA | 复杂问句 | 因果关系纳入多跳问答 |
课件还给出三种补充路线:KEPLER 联合知识嵌入与预训练语言表示;BRGNN 对复杂多跳问句做双向推理并生成查询路径;Marie and BERT 把化学领域实体链接、多种 KGE 模型和答案重排序接在一起。
6.4 时序问答模型
| 模型 | 核心创新 |
|---|---|
| TwiRGCN | GCN + 时间加权机制 + 门控机制 |
| CRONKGQA | 时序知识表示学习(嵌入含时间信息) |
| TempoQR | 时间嵌入表示 + 实体感知 |
| CTRN | 捕捉隐式时序特征 + 关系表示 |
| EXAQT | 挖KG 密集子图 + 微调 BERT 增强事件 |
| Prog-TQA | 大模型 ICL + 组合时序约束 |
| GenTKGQA | 子图检索 + LLM 生成(LLM 双阶段) |
7. 推荐系统
7.1 传统 vs KG 推荐
| 类型 | 思路 | 局限 |
|---|---|---|
| 传统推荐 | 仅利用用户-物品历史 | 缺乏可解释性、个性化弱 |
| 基于 KG 推理的推荐 | KG 提供多样化、精确、可解释的推荐 | 需要构建领域 KG |
7.2 KG 推理挖掘用户喜好
| 模型 | 核心 |
|---|---|
| KGCN | 图卷积网络 + 聚合邻居信息 |
| KGNCF-RRN | 改进的 RRN + 关系路径编码(多步) |
| KGECF | 用户-物品交互建模为单一关系 KG + 表示学习 |
7.3 KG 推理增强推荐可解释性
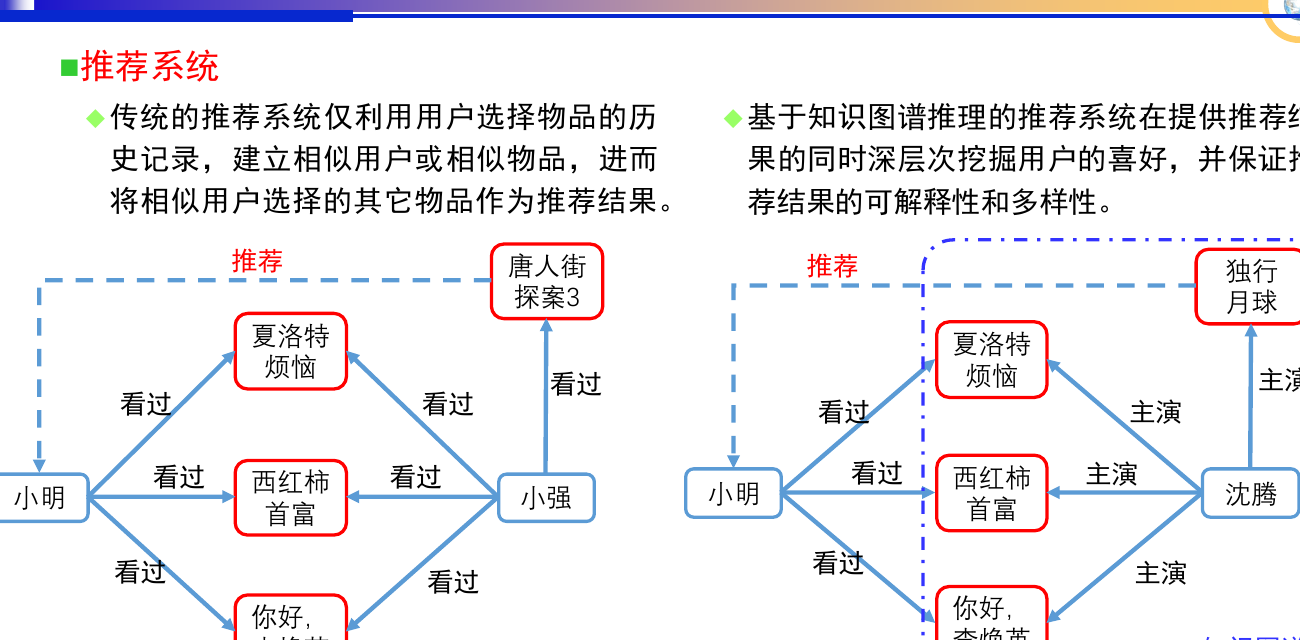
| 模型 | 核心 |
|---|---|
| PGPR | 强化学习 + 多步推理 + 软奖励策略 |
| KPRN | 组合 KG 实体和关系嵌入 |
| CogER | 模仿人类认知过程(系统1 + 系统2) |
| KRRL | 自监督强化学习 + MOOCs 可解释推荐 |
| KGAT | 压缩附带信息 + 降低计算成本 + 保持准确性 |
| RippleNet | KG 嵌入 + 多跳路径传播 |
评论增强推荐会同时使用用户—物品交互图和知识图谱:前者提供点击、购买、评分等行为信号,后者提供物品、演员、类别等语义关系。模型可在两张图上并行做协同过滤,再把“用户—中间实体—推荐物品”的图路径转成解释。
元路径是异构图上的类型级路径模板,例如“用户—看过—电影—主演—演员—主演的逆关系—电影”。它描述一类可复用关系,不是某几个具体实体组成的单条路径。
8. 视觉与跨模态
8.1 视觉问答(VQA)
VQA:基于图像 + 知识图谱回答问题。
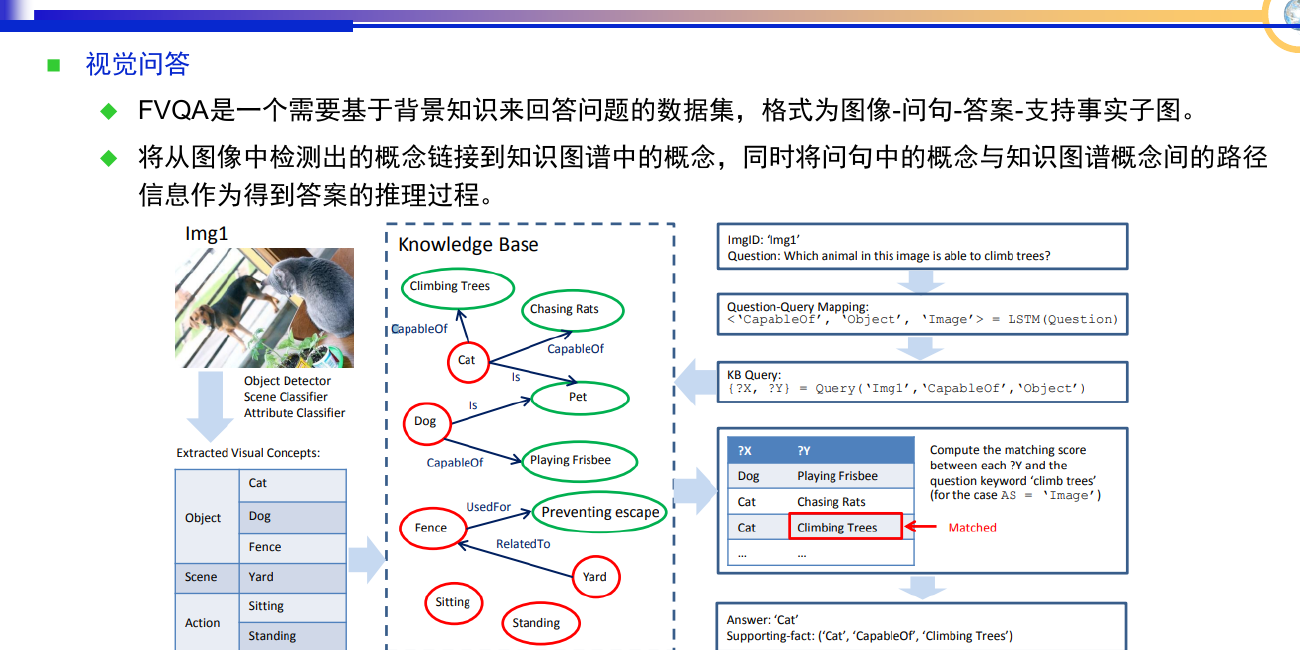
图谱的作用是提供像素里没有直接出现的背景事实:先把图像中检测到的对象、属性和场景链接到图谱实体,再沿事实路径寻找答案。
| 模型 | 核心 |
|---|---|
| FVQA | 数据集格式:图像-问句-答案-支持事实子图 |
| Graphhopper | 图像 → 场景图 + KG 路径推理 |
| 大模型 VQA | LLM + 视觉编码器(GPT-4V 等) |
8.2 跨模态检索
| 模型 | 核心 |
|---|---|
| KCR | ResNet 图像特征 + 改进 BERT 文本特征 |
| MMRG | 文本 KG + 视觉 KG + 类似 BERT 掩码 |
| IRGR | 图像/文本/实例相似度矩阵 + KNN 关系图谱 |
8.3 场景理解
| 模型 | 核心 |
|---|---|
| GB-Net | Faster R-CNN 初始化场景图 + ConceptNet/WordNet |
| HiKER-SGG | 层次化 KG + 初始场景图桥接 |
| CGR | 不同路径匹配 + 检索 + 选择性路由 |
| COACHER | 常识 KG + 图挖掘模块 |
9. 垂直领域应用
9.1 医疗领域
- KGNN(IJCAI 2020):药物相互作用预测
- 整合电子病历 + 医学 KG + KGE 推理 → 安全药物推荐
9.2 商业领域
- OpenBG(ICDE 2023):亿级多模态商业 KG + 视觉-语言基础模型预训练 → 商品分类预测
- KAPR(KBS 2022):多特征推理 + 动态策略网络 → 多步推理预测产品替代/互补关系
- 多种 KGE 技术 → 发现客户需求与产品的隐含关系
- 异常检测:KG 嵌入 + ML
9.3 信息安全领域
- MDATA + AMIE 规则学习 → 发现新网络中的知识
- 基于 TransH 的 KG 推理 → 自动识别攻击模式
9.4 其他领域(已知案例)
- 电商(阿里、京东)、餐饮娱乐(美团)、学者(AMiner)、中医药、天眼查(已在第 1 讲讲过)
10. 三类 KBQA 方法对比
| 方法 | 课件给出的优势 | 主要代价或边界 |
|---|---|---|
| 模板 | 查询响应快、准确率较高,可处理相对复杂的问题 | 模板设计成本高,且难覆盖用户真实表达 |
| 语义解析 | 能把复杂问题转成逻辑形式或查询 | 语义规则和训练数据的工程量较大 |
| 深度学习 | 减少人工模板和规则,学习过程自动化 | 早期通用模型主要处理简单、单边关系;复杂约束需要专门结构 |
11. 本讲小结
知识图谱应用
├── KBQA
│   ├── 模板:TBSL
│   ├── 语义解析:问题 → 逻辑形式 → 查询
│   ├── 深度学习:简单、多跳与时序模型
│   └── 预训练模型:知识嵌入、双向推理与领域问答
├── 推荐
│   ├── 交互图挖掘偏好
│   └── 图路径和元路径解释结果
├── 视觉与跨模态
│   ├── 图像概念链接外部知识
│   └── 沿场景图或知识图谱路径推理
└── 垂直领域:医疗 / 商业 / 信息安全