第五讲 · 非结构化知识抽取:NER、关系与事件
对应 PPT:第5讲 重点:NER/RE/EE 的方法演进,特别是序列标注、CRF、BiLSTM+CRF、远程监督。
1. 概述
1.1 非结构化数据回顾
- 数据结构不规则、不完整,没有预定义模型
- 包括:所有格式的办公文档、文本、图片、音频、视频
- 挑战:是当前知识图谱构建的技术瓶颈
1.2 三大子任务
- 实体识别(NER)
- 关系抽取(RE)
- 事件抽取(EE)
2. NER 方法演进
早期(1950s~1990s)    统计学习(1990s~2010s)    深度学习(2010s~)    当前热点(2020s~)
   ↓                         ↓                       ↓                    ↓
基于规则                HMM / CRF / MEMM          RNN-CRF / CNN-CRF     注意力/迁移学习/大模型
基于词典                                       BiLSTM-CRF              LLM-based
这条演进路线是:规则 → 词典 → 统计学习 → 深度学习 → 大模型。
3. 早期方法:基于词典与规则
思路
- 由领域专家手工编写规则或构造实体词典
- 将规则/词典与文本字符串匹配,识别命名实体
优缺点
| 优点 | 缺点 |
|---|---|
| 封闭领域中可做到高精度 | 需大量专家 + 领域知识 |
| 跨领域难以移植 | |
| 数据集增大,规则构建周期变长 |
4. 统计学习方法:HMM / CRF
4.1 核心思想
将实体识别转化为序列标注问题:当前标签的预测既与当前输入特征相关,也与上下文的预测标签相关。
4.2 三套标注体系
| 体系 | 标记 | 含义 |
|---|---|---|
| BIO | B-X / I-X / O | B=实体首词,I=实体内部,O=外部 |
| IO | I-X / O | 简化版(不区分 B/I) |
| BIOES | B-X / I-X / E-X / S-X / O | B=开始、I=内部、E=结束、S=单字实体、O=外部 |
B-ORG = Begin-Organization(组织名首词),I-ORG = Inside-Organization(组织名内部)。
4.3 特征抽取
| 特征类型 | 内容 |
|---|---|
| 单词级别特征 | 是否首字母大写、是否包含数字、词性(POS) |
| 词典特征 | 依赖外部词典(地名列表、组织名列表、姓氏等) |
没有统一原则,大多靠专家经验 + 实验调优。
4.4 特征抽取示例
文本:“谈到亚洲金融,董建华说”
| 词 | 词性 | 边界 | 姓氏 | 人名指示词 | 标签 |
|---|---|---|---|---|---|
| 谈 | V | B | N | Y | O |
| 到 | V | I | N | Y | O |
| 亚 | ns | B | N | N | B-location |
| 洲 | ns | I | N | N | I-location |
| 金 | N | B | Y | N | O |
| 融 | N | I | N | N | O |
| , | X | W | N | N | O |
| 董 | Nr | B | Y | N | B-Person |
| 健 | Nr | I | N | N | I-Person |
| 华 | Nr | I | N | N | I-Person |
| 说 | V | W | N | Y | O |
4.5 CRF(条件随机场)
条件随机场定义:
节点 的标签只依赖输入序列 和与 相邻的节点 。
线性 CRF(NER 用):假设标签序列是链式结构
取决于输入 和相邻的标签 。
CRF 公式:
- = 特征函数
- = 特征函数权值(训练学习)
- = 任意可能的标签序列(分母是归一化项)
预测:找 argmax 。
CRF 在所有候选标签序列上做全局归一化,预测也是对整条序列取 argmax,而不是每个 token 独立取最大概率。
4.6 HMM vs CRF 关键差异
| 维度 | HMM | CRF |
|---|---|---|
| 模型类型 | 生成式 | 判别式 |
| 建模假设与特征 | 对状态转移和观测作较强的条件独立假设 | 直接建模 ,可灵活使用重叠的输入特征 |
| 特征工程 | 难 | 灵活 |
| NER 效果 | 一般 | 更优 |
5. 深度学习方法:BiLSTM + CRF
5.1 总体框架
① 分布式表示(Embedding): 词 → 低维稠密实值向量
② 上下文编码(BiLSTM):   双向捕获上下文
③ 标签解码(CRF):         加入标签转移约束
       ↓
    输出最优标签序列
5.2 第 1 步:分布式表示(Word2Vec)
Word2Vec(Google, 2013) = 词向量模型,2 个变体:
- CBOW(Continuous Bag-of-Words):用上下文预测中心词
- Skip-gram:用中心词预测上下文
CBOW 示例:
“The quick brown fox jumps over the lazy dog” 输入
[quick, brown, jumps, over]→ 预测fox
CBOW 流程:
① one-hot 编码每个上下文词(V 维,V = 词表大小)
② × 共享的输入权重矩阵 W(V×N)→ 词向量(N 维)
③ 求平均 → 隐层向量(1×N)
④ × 输出权重矩阵 W'(N×V)→ 向量(1×V)
⑤ softmax → 概率分布
⑥ 与真实 one-hot 比较 → 交叉熵损失 → 反向传播更新 W 和 W'训练完成后,任意词的 one-hot × 矩阵 W = 它的词向量。
5.3 第 2 步:上下文编码(BiLSTM)
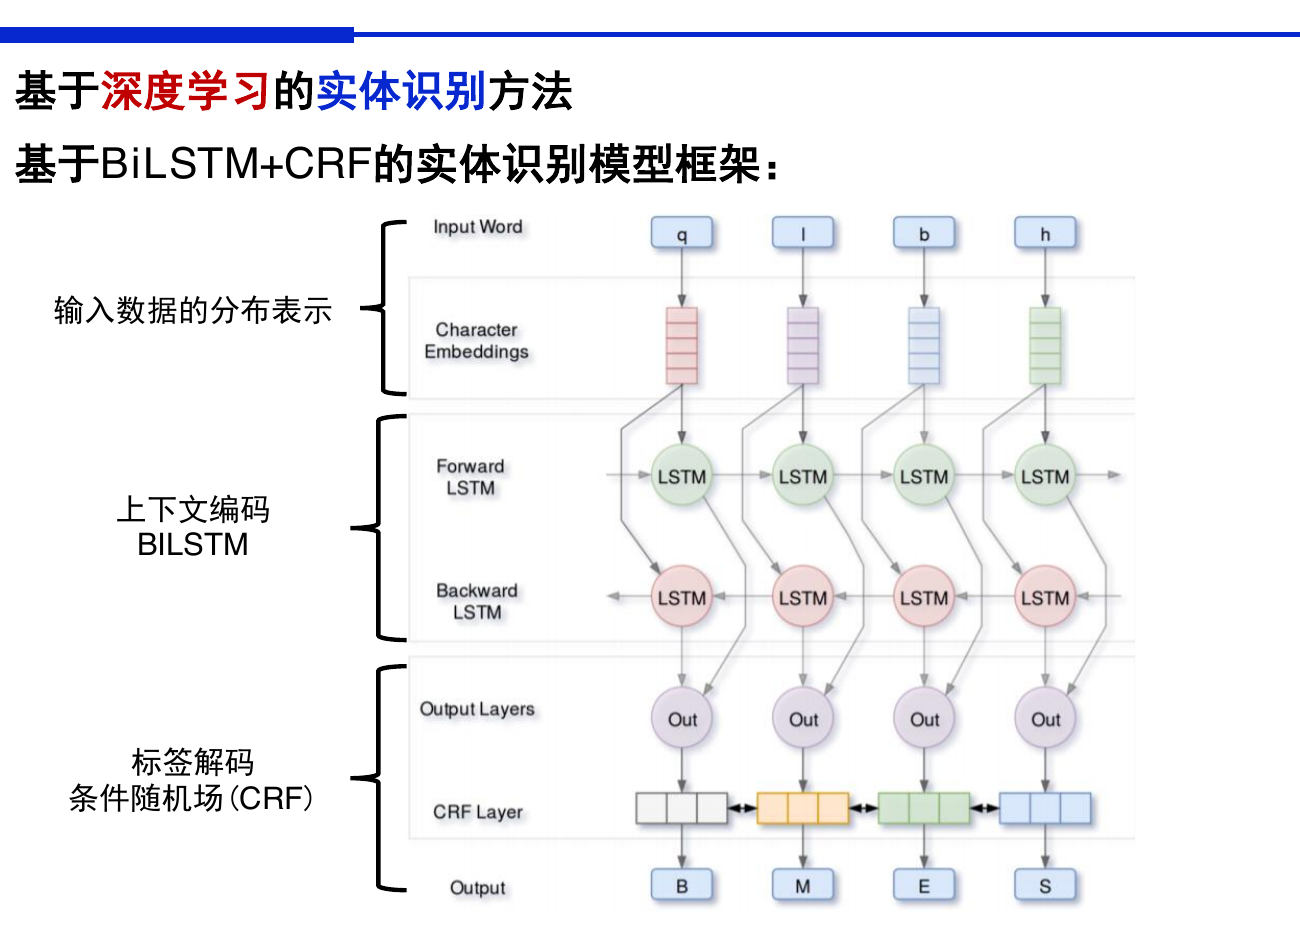
每个 token 同时读取左、右上下文,再由 CRF 在整条标签序列上解码。
LSTM(长短期记忆网络):
- 解决 RNN 的长程依赖 + 梯度消失问题
- 3 个门控:遗忘门、输入门、输出门
- 核心:细胞状态 沿时间线性传递
BiLSTM(双向 LSTM):
Pierre → Forward LSTM  → h_forward(Pierre)
Pierre ← Backward LSTM ← h_backward(Pierre)
对第 个 token,BiLSTM 合并的是同一位置的正向和反向状态:
课件的 Attention BiLSTM 关系分类模型用逐元素求和,即 。两种方式都合并同一 token 的两个方向,不能把不同 token 的状态相加。
双向 → 每个词既有左上下文也有右上下文信息。
5.4 第 3 步:标签解码(CRF)
为什么 BiLSTM 后还要加 CRF?
- BiLSTM 独立预测每个标签,不考虑标签之间的关系
- 预测可能不合法,如
B-PER → I-LOC:I-LOC不能跟在B-PER后面 - CRF 加约束:学习标签转移矩阵,让无效序列得分变低
BIO 中,I-X 前面应是同类型的 B-X 或 I-X;B-Y 表示新实体开始,可以直接跟在另一个实体后面。因此 B-PER → I-PER → B-LOC 可以是合法序列,实体之间不强制出现 O。
Pierre   loves   Paris
B-PER    O       B-LOC
   ↓
路径 "B-PER → O → B-LOC" 得分:31(合法)
路径 "B-PER → I-LOC → B-LOC" 得分:26(非法,CRF 压低)
5.5 BiLSTM+CRF 优势
| 方法 | 优势 | 劣势 |
|---|---|---|
| 只 CRF | 学习标签依赖 | 需手工定义大量特征模板 |
| 只 BiLSTM | 自动学特征 | 忽略标签依赖,输出可能非法 |
| BiLSTM+CRF | 自动学特征 + 学习标签依赖 | 较慢 |
BiLSTM-CRF 是理解序列标注式 NER 的经典基线;实际选型还要考虑预训练 Transformer、跨度分类和生成式方法。
6. 关系抽取(RE)方法
6.1 任务定义
从文本中抽取两个/多个实体之间的语义关系。通常在 NER 之后做。
例:[王思聪] 是万达集团董事长 [王健林] 的独子 → 王思聪 -父子关系→ 王健林
6.2 方法分类(3 大类)
| 方法 | 思路 | 优点 | 缺点 |
|---|---|---|---|
| 基于模板 | 专家写规则/模板 | 小规模快 | 难扩展、难移植 |
| 基于深度学习 | NER + RE 模型 | 主流 | 需大量标注 |
| 基于弱监督 | 远程监督 | 减少标注 | 有噪声 |
6.3 基于模板的方法
模板构造思路:
- 例:抽取”夫妻”关系
- 观察例句:
[姚明] 与妻子 [叶莉] 还有女儿 ...→ 模板1:[X] 与妻子 [Y] ...[徐峥] 老婆 [陶虹] 晒新写真→ 模板2:[X] 老婆 [Y] ...
- 用模板匹配新句子
6.4 基于深度学习的方法(2 大路线)
① 流水线方法(Pipelined):NER 和 RE 分离,RE 在 NER 结果上做。
| 模型 | 年份 | 特点 |
|---|---|---|
| CR-CNN | 2015 | 4 层:输入/卷积/池化/全连接,CNN + Ranking |
| Attention BiLSTM | 2016 ACL | BiLSTM + Attention,5 层:输入/Embedding/BiLSTM/Attention/Softmax |
② 联合抽取方法(Joint):NER 和 RE 在统一模型中共同优化。
经典工作:Miwa & Bansal 2016 ACL:词嵌入 + 序列层 BiLSTM + 依存层 BiLSTM(基于依赖子树)。
这个模型的序列层用 BiLSTM 做实体识别和上下文编码,依存层沿实体之间的依存子树判断关系。联合学习可以缓解 NER 错误向 RE 传播,但共享表示与联合解码也可能互相干扰,不保证消除误差。
流水线 vs 联合:
| 维度 | 流水线 | 联合 |
|---|---|---|
| 错误积累 | 有(NER 错 → RE 错) | 可缓解传播,仍可互相干扰 |
| 复杂度 | 低 | 高 |
| 效果 | 取决于上游质量 | 常能改善,不保证始终更优 |
6.5 基于弱监督的方法:远程监督
核心假设:
若两个实体在 KG 中存在某种关系,则包含这两个实体的句子均表达了这种关系。
例子:
- KG 里有
(乔布斯, 创始人, 苹果公司) - 句子”乔布斯是苹果公司的联合创始人和 CEO” → 自动标注为”创始人”关系训练正例
步骤:
① 从 KG 抽取存在目标关系的实体对
② 从非结构化文本中抽取含实体对的句子作为训练样例
③ 训练监督学习模型进行关系抽取| 优点 | 缺点 |
|---|---|
| 减少人工标注工作量 | 引入大量噪声(句子可能不真表达该关系) |
降噪方法(APCNNs, AAAI 2017):
- PCNNs:分段最大池化(Piecewise max-pooling),按实体位置分 3 段池化
- 输入:词向量(Word2Vec)+ 位置向量(当前词到目标实体的相对距离)
- 操作:卷积 + 分段最大池化 → 句子特征向量
- 句子级注意力:用注意力机制加权聚合多个样例句子的特征
- 多示例学习(Multi-Instance Learning):同一关系的样例句子组成”样例包”,关系分类在样例包特征上做
核心思想:用注意力让”表达关系的句子”权重高,让”噪声句子”权重低。
7. 事件抽取(EE)
7.1 任务定义
识别文本中关于事件的信息,结构化呈现(时间、地点、原因、参与者等)。
7.2 2 个子任务
① 识别事件触发词并判断事件类型
② 抽取事件元素并判断角色
7.3 流水线方法
DMCNN(Yubo Chen, ACL 2015):
第一阶段:触发词分类
  - DMCNN 判每个词是否触发词
  - 若是触发词 → 第二阶段

第二阶段:论元分类
  - 类似 DMCNN,识别该触发词对应的论元 + 角色
DMCNN 关键设计:
- Dynamic Multi-pooling:卷积后按触发词和候选论元位置切分成 3 部分,每部分 max pooling
- 为什么?避免”句子级最大池化”丢失触发词-论元之间的局部信息
MOGANED(EMNLP-IJCNLP 2019,触发词检测):
- 多阶图注意力网络:把句法图分成 3 个子图(along/rev/loop)
- Attention Aggregation:聚合各阶图表示
Implicit Event Argument Detection(ACL 2020):
- 解决”事件元素与触发词不在同一句子”的问题(隐式论元)
- 3 模块:BERT Encoder + Biaffine Role Scorer + Head-to-Span Expander
- 两步:先 head-word detection,再 head-to-span expansion
7.4 联合抽取方法
基于图信息聚合的联合事件抽取(EMNLP 2018):
- GCN 层:基于句法分析树,把句子变成有向图
- Joint Extraction 层:
- 触发词分类:self-attention + softmax
- 论元分类:对触发词和实体的表示拼接 + softmax
- 输出 = 第 j 个实体在第 i 个触发词事件中的角色
7.5 流水线 vs 联合
| 维度 | 流水线 | 联合 |
|---|---|---|
| 模型数 | 多个分类器 | 单一模型 |
| 误差传播 | 有 | 可缓解,但子任务仍可互相干扰 |
| 性能 | 取决于各阶段 | 常能改善,不是无条件更优 |
8. 方法演进索引
非结构化知识抽取
├── NER 方法演进
│   ├── 早期:规则/词典
│   ├── 统计:HMM / CRF(BIO/BIOES 标注)
│   │   ├── BIO:B-X(首词)、I-X(内部)、O(外部)
│   │   ├── BIOES:+ E-X(结束)、S-X(单字)
│   │   └── CRF:判别式 + 标签转移约束
│   └── 深度:BiLSTM+CRF
│       ├── ① Embedding(Word2Vec CBOW/Skip-gram)
│       ├── ② 上下文编码(BiLSTM 双向)
│       └── ③ 标签解码(CRF 加约束)
│
├── 关系抽取 RE
│   ├── 3 大方法
│   │   ├── 模板(小规模快,难扩展)
│   │   ├── 深度学习(流水线/联合)
│   │   └── 弱监督(远程监督)
│   ├── 流水线:CR-CNN / Attention BiLSTM
│   ├── 联合:Miwa 2016(缓解错误传播)
│   └── 远程监督
│       ├── 假设:KG 中有 R,句子都表达 R
│       ├── 优点:减少标注
│       └── 降噪:APCNNs(PCNNs + 注意力)
│
└── 事件抽取 EE
    ├── 2 子任务:触发词分类 + 论元角色分类
    ├── 流水线:DMCNN / MOGANED / Implicit Argument
    │   └── DMCNN 关键:Dynamic Multi-pooling
    └── 联合:GCN + Attention + Softmax