第六讲 · NER 前沿与 LLM 知识抽取
对应 PPT:第6讲 我在这一讲整理 NER 的 5 个扩展方向(Few/Zero-shot、Continual、Nested、Cross-Domain、Multi-Modal),以及课件所引论文对 LLM 知识抽取能力的实验结论。
1. NER 经典方法的 3 个组件
① 分布式输入表征(Embedding):词 → 低维稠密实值向量
② 上下文编码器:CNN / RNN / Transformer 捕捉上下文
③ 标注解码器:预测每个 token 的标签
2. NER 主流数据集(5 个)
| 数据集 | 实体类别数 | 特点 |
|---|---|---|
| CoNLL 2003 | 4 类(PER/LOC/ORG/MISC) | Reuters 新闻,最经典 |
| CoNLL++ | 4 类 | CoNLL 2003 的更干净版本,修了 ~5% 测试集标签错误 |
| WNUT 2017 | 6 类 | 社交媒体噪声数据 |
| Ontonotes v5 | 18 类(11 类型 + 7 值) | 大型、3 语言、200 万 token |
| Few-NERD | 8 粗 + 66 细 | 188,200 句子、491,711 实体,小样本 NER |
2.1 CoNLL 2003 SOTA
| 模型 | F1 | 关键创新 |
|---|---|---|
| ACE + document-context (Wang 2021) | 94.6 | 控制器搜索 embedding 串接方式 |
| LUKE (Yamada 2020) | 94.3 | 把 word 和 entity 作为不同 token 联合编码 |
| CL-KL (Wang 2021) | 93.85 | 检索并重排外部上下文,再做合作学习 |
这些 F1 是特定数据集和当时设定下的结果,用来理解方法演进,不是跨数据集的通用排名。本节的 ACE 指 Automated Concatenation of Embeddings,不是第三讲的 Automatic Content Extraction 评测。
2.2 3 种主流 Embedding 串接
- Classical word embeddings(Word2Vec、GloVe)
- Character-level features(针对特定任务的字特征)
- Contextualized embeddings(ELMo、Flair)
Flair 的工作流程:先把整个句子当作字符序列送入预训练的双向字符语言模型;对每个词,取正向 LM 在末字符前的状态和反向 LM 在首字符后的状态,拼接为上下文字符嵌入,再交给 BiLSTM-CRF 标注。
CVT + Multi-Task 混合使用有标注和无标注数据。有标注样本按标准监督学习训练;对无标注样本,只能看到受限输入视图的辅助预测器,去匹配看到完整输入的主模型预测。辅助模块与主模型共享中间表示,并与多任务学习结合。
ACE:神经结构搜索自动选最优串接方式(强化学习控制器)。
2.3 三大改进方向
| 方向 | 思路 | 代表工作 |
|---|---|---|
| ACE | 自动搜索最优 embedding 串接 | Wang 2021 |
| LUKE | 把实体也当作 token,用 Transformer 学 | Yamada 2020 |
| CL-KL | 检索外部文档作上下文 + 合作学习 | Wang 2021 |
3. NER 的 5 个扩展方向
3.1 Few/Zero-Shot NER
背景:
- 实际应用中目标实体类标注数据稀缺
- 人类能从 1-2 个例子就学会新概念,机器不行——这是 AI 短板
Few-NERD 数据集:
- 8 个粗粒度类型、66 个细粒度类型、188,200 个句子、491,711 个实体、4,601,223 个 token
- 3 个子任务:
- Few-NERD (SUP):标准 NER
- Few-NERD (INTRA):在各粗粒度类别内部拆分细粒度类型,训练和测试仍共享粗类别
- Few-NERD (INTER):按粗粒度类别跨集合拆分,测试可遇到训练未覆盖的粗类别
Zero-Shot NERC(ACL 2021):
- 方法:用实体类的自然语言描述代替标注样本
- 解决”训练/测试类不一致”导致 not-an-entity 类不明确的问题
- 训练:观察到的类;测试:未见过的类
- 例:描述”人类建造的结构:基础设施、街道、桥梁” → 模型识别”Shantou Harbour”为 Facility 类
SpanNER(EMNLP 2021):
- 把 NER 拆成两个子任务:
- 跨度检测(Span Detection)——类别无关,token 采样缓解类别不平衡
- 实体类推理(Type Inference)——基于类别描述的注意力机制
- 论文在小样本、零样本和领域迁移三类实验中共用这一框架;不等于对任意新数据都保证提升
关键洞察:传统 NER 把每个类当作 one-hot 向量,无法捕捉标签的语义含义;引入类别描述可以为迁移到新类提供语义信号。
3.2 Continual NER(持续学习)
背景:
- 现实场景中不断出现新的实体类型
- 重新标注旧数据代价高或不可能(存储/安全限制)
- 不能”全打碎重训”——灾难性遗忘问题
3 种让模型胜任多任务的方法:
| 方法 | 思路 | 局限 |
|---|---|---|
| 多任务学习/联合训练 | 在新旧任务并集上重训 | 旧数据可能拿不到、随任务增多成本飙升 |
| 微调 | 用小学习率更新(部分/全部)参数 | 简单微调会影响旧任务性能 |
| 迁移学习/特征抽取 | 复用预训练模型的特征提取 | 通用特征未必覆盖新任务特有信息 |
ExtendNER(AAAI 2021):
- 持续学习框架
- 用知识蒸馏(teacher → student)巩固旧知识
- KL 散度损失: 让学生模型输出接近教师
- 关键:只用新类型标注的新数据训练
3.3 Nested NER(嵌套)
问题:实体可以嵌套——“霍格沃兹校长阿不思·邓布利多”中”霍格沃兹”、“校长”、“阿不思·邓布利多”都是实体,且互有包含。
传统序列标注(BIO)无法处理嵌套 → 需要分层标注。
课件介绍的 ACL 2021 方法:
- 多级编码方案:按实体的深度分多层
- 在该论文的课件实验中,从最内部的实体开始识别(内 → 外)效果更好
- 用 3 层 BiLSTM 编码 + CRF 解码
- 数据集:ACE2004、ACE2005、GENIA
课件所引实验结论:在该论文的实验设置中,“内部优先”优于“外部优先”,不能直接外推到所有嵌套 NER 模型和数据集。
3.4 Cross-Domain NER
动机:现有 NER 基准的 2 个问题:
- 目标数据集与源数据集过于相近——会降低迁移评测的区分度
- 源/目标实体类差距过大——会增加迁移难度
CrossNER(AAAI 2021)数据集:
- 5 个领域:politics / natural science / music / literature / AI
- 每个领域有专门实体类
- 提供领域相关语料库用于领域自适应预训练(DAPT)
论文中的观察:
- 在课件所引 CrossNER 实验中,DAPT 优于直接使用通用预训练
- 在该实验设置中,用“含领域专业实体的子集语料”配合更具挑战性的预训练策略可进一步提升结果
领域专属 NER(ACL 2021):
- 专门领域(生物医学、法律)实体复杂
- 思路:用全局共指关系 + 局部依赖关系通过 GNN 显式连接实体提及
3.5 Multi-Modal NER
背景:现实中文本经常伴随图像(推文、商品页),视觉信息能辅助实体识别。
**UMGF(Unified Multimodal Graph Fusion)**是课件重点展开的模型,UMT 是对比基线之一。UMGF 把文本词和检测到的视觉对象都建成图节点,加入模态内边和模态间边,堆叠图融合层交互信息,最后为每个词生成注意力加权的多模态表示并用 CRF 解码。目标视觉引导让与当前词相关的对象区域参与消歧,而不是把整张图的全局向量复制给每个词。课件实验使用 Twitter-2015 和 Twitter-2017。
课件在这两个基准上比较时,BERT-CRF 优于 BiLSTM-CRF,多模态方法整体优于对应纯文本基线,UMGF 优于 UMT。这些是该实验设定下的结果,不应外推为所有多模态数据上的固定排名。
4. 大模型(LLM)在知识抽取中的应用
4.1 提出的 4 个核心问题
- 少样本 IE 任务中,LLM 能否真正超过 SLM?
- 更多标注数据能否提升 LLM 和 SLM 的能力?
- 经济/时间代价上,哪类模型更好?
- LLM 和 SLM 是否分别适合处理不同类型样本?
4.2 评估设置
小模型(SLM):RoBERTa-large(抽取)、T5-large(生成)
- 4 种方法:微调 FT、FSLS、KnowPrompt、UIE
大模型(LLM):CODEX(code-davinci-002 / text-davinci-003)
- 4 种 ICL(In-Context Learning)设置:
- 基础 ICL
- ICL + Auto CoT(生成推理链)
- ICL + demo 筛选(embedding 相似)
- ICL + Self-ensemble
任务:NER、RE、ED(事件检测)
4.3 论文实验结论
“Large Language Model Is Not a Good Few-shot Information Extractor, but a Good Reranker for Hard Samples!”
结论 1:LLM 不是好的少样本 IE 工具
- 1-shot 下:LLM 比 SLM 表现好
- 5-10 shot 下:LLM ≈ SLM
- 更多标注数据后:SLM > LLM(因为 SLM 可以微调)
- 该实验中,LLM 的时间和金钱开销高于所比较的 SLM
这些判断只限于论文当时的模型和设定:LLM 主要是 code-davinci-002、text-davinci-003,SLM 主要是 RoBERTa-large、T5-large,对比任务为 NER、RE 和 ED。课件的耗时图表只能支持“该实验中 LLM 的时间和金钱开销更高”,不足以推出跨模型、跨平台的固定倍数;ED 的优劣也只适用于当时的数据集和提示/微调设定。
结论 2:LLM 是好的少样本重排器(reranker)
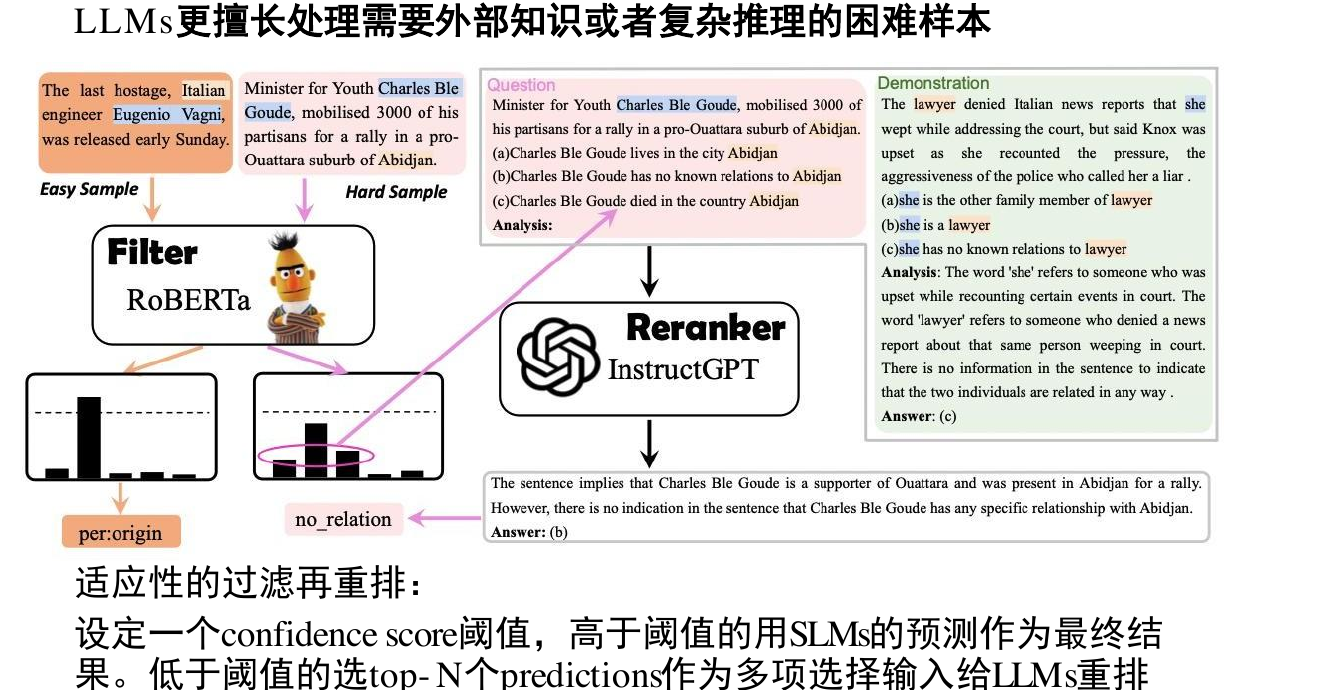
高置信样本直接采用小模型结果,低置信样本才交给 LLM 在 Top- 标签中重排。
Filter-then-Rerank 范式:
① SLM 作为过滤器:移除不可能标签,保留 Top-N 候选
② LLM 重排这 N 个标签:输出最终答案
   → 把 N 个候选改写成"选择题"形式给 LLM
   → 例:"<头实体>和<尾实体>具有<label>关系吗?"
小模型的置信度定义为
- 时直接采用 SLM 的 top-1 预测;
- 时保留 top- 候选,把开放式抽取改写成多项选择,再由 LLM 重排;
- ensemble 和 rerank 是两个模块,不能把集成带来的收益全部算给 LLM。
重排实验的范围是三个任务、三个数据集、九种 -shot 设置:NER 用 FewNERD 的 ,RE 用 TACREV 的 ,ED 用 ACE05 的 。幻灯片报告无 ensemble 时平均提升 2.4 个 F1 点,加入 ensemble 后提升 2.1 个 F1 点。
优势:
- 减少标签范围(多项选择),降低 LLM 任务难度
- 让 LLM 用”熟悉的形式”做 IE
- SLM 和 LLM 能力互补
4.4 整体策略总结
| 场景 | 推荐 |
|---|---|
| 标签空间明确、有可用标注 | 先评估 SLM 微调的效果与成本 |
| 极少标注 | 可把 LLM ICL 作为对比,结论取决于具体任务 |
| SLM 低置信候选 | 评估 Filter-then-Rerank,只让 LLM 处理少量疑难样本 |
5. 行业知识图谱构建工具
| 资源 | 用途 |
|---|---|
| KnowLM | 知识增强的开源大语言模型框架(浙大 ZJUNLP) |
| InstructionKGC | 指令驱动的自适应知识图谱构建(DeepKE/example/llm) |
| 行业 KG 综述 | https://mp.weixin.qq.com/s/iVIoaZxhS1EyC2etRnBf4Q |
6. 编程练习
Resume NER 数据集(8 类实体:BIO 标注):
- 国籍(CONT)、教育背景(EDU)、地名(LOC)、人名(NAME)
- 组织名(ORG)、专业(PRO)、民族(RACE)、职称(TITLE)
推荐模型:BiLSTM+CRF
7. 主题索引
NER 前沿 + LLM 抽取
├── NER 经典 3 组件
│
├── 主流数据集
│   ├── CoNLL 2003 / CoNLL++(新闻,4 类)
│   ├── WNUT 2017(社交媒体)
│   ├── Ontonotes v5(大型,18 类)
│   └── Few-NERD(小样本专用)
│
├── NER 衍生 5 方向
│   ├── Few/Zero-Shot NER
│   │   ├── Few-NERD(粗+细粒度)
│   │   ├── Zero-Shot NERC(类别描述)
│   │   └── SpanNER(跨度+类推理)
│   ├── Continual NER(持续学习)
│   │   └── ExtendNER(知识蒸馏)
│   ├── Nested NER(嵌套)
│   │   └── 内→外多层编码
│   ├── Cross-Domain NER
│   │   └── CrossNER(5 领域+DAPT)
│   └── Multi-Modal NER
│       └── UMGF(多模态图融合,UMT 为基线)
│
└── LLM 在知识抽取
    ├── 论文实验:更多标注时 SLM 更能利用微调
   └── Filter-then-Rerank 范式
        ├── SLM 当过滤器
        ├── LLM 当重排器
        └── confidence score 选困难样本