第四讲 · 半结构化知识抽取
对应 PPT:第4讲 主要内容:百科类抽取(DBpedia)、Web 包装器、Web Table 抽取
1. 什么是半结构化数据
半结构化数据:用**标签(tag)**对数据进行结构划分或分离语义元素的数据。和结构化数据相比,没有严格的数据结构和关系定义。
- 包括:HTML、JSON、XML、NoSQL 数据库
- 标签划分了页面元素的层次(
<table>,<div>,<h1>) - 优点:扩展性强、灵活性好
- 缺点:结构可变,模板可能随时改
半结构化 vs 结构化 vs 非结构化
| 类型 | 结构 | 例子 | 抽取方法 |
|---|---|---|---|
| 结构化 | 严格 schema | 关系数据库 | D2R(DM/R2RML) |
| 半结构化 | 标签+自由 | HTML/JSON/XML | 包装器 / 模板 / 实体链接 |
| 非结构化 | 无结构 | 文本 | NER/RE/EE |
2. 百科类知识抽取:DBpedia 框架
2.1 背景
- Wikipedia 是最大的半结构化知识源之一
- DBpedia = Wikipedia 知识图谱化,从 Wikipedia 抽取结构化数据,发布为 RDF
2.2 DBpedia 总体框架
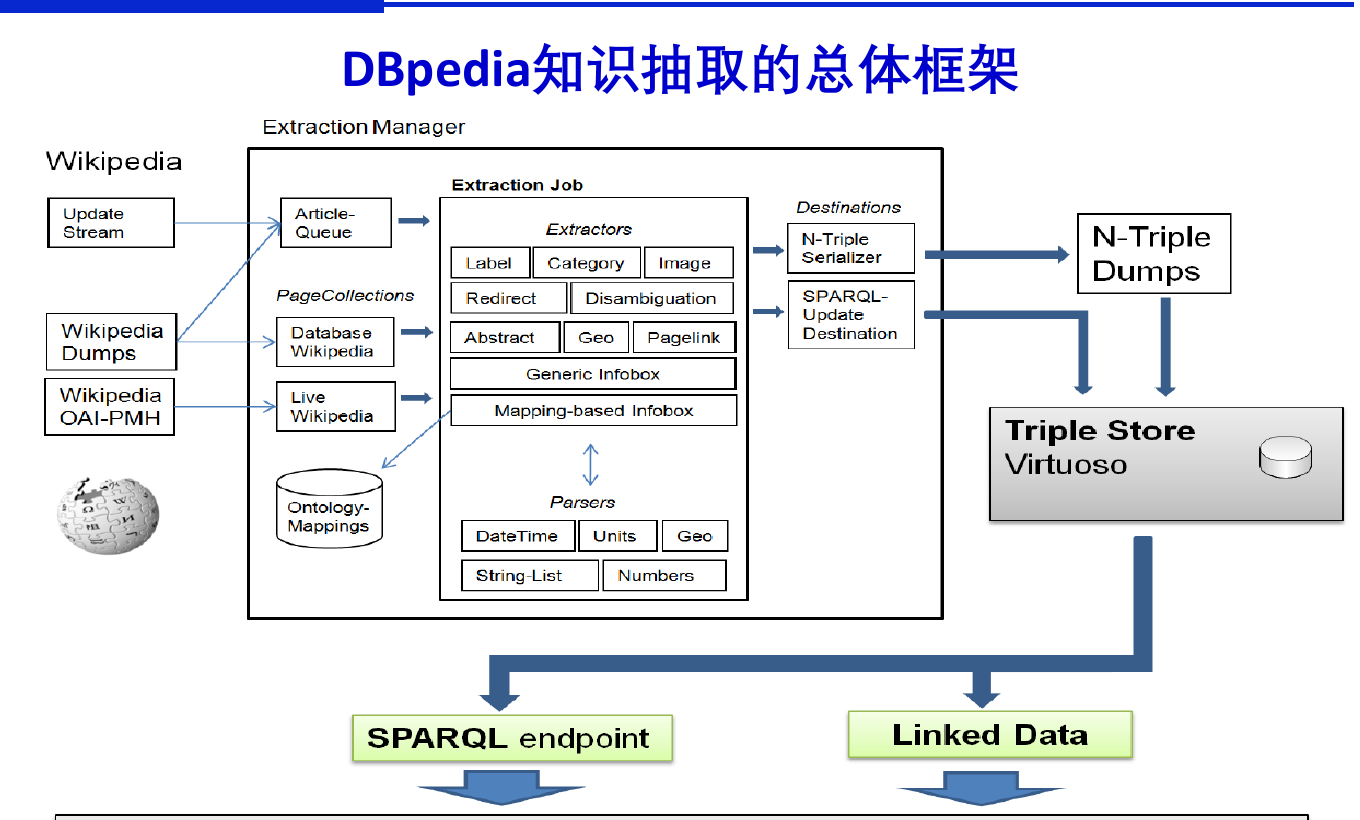
页面集合先经过不同提取器与解析器,再被统一序列化为 RDF 数据。
页面集合(Page Collections)         目标数据(RDF 三元组)
  ├─ 本地 Wiki 文章                       ↑
  └─ 远程 Wiki 文章                       │
                                          │
        提取器(Extractors)→  解析器(Parsers)→ 三元组
(特定类型 Wiki 标记) (类型判断/转换)- 页面集合:本地 + 远程 Wikipedia 文章
- 提取器(Extractors):把特定类型的 Wiki 标记转成三元组
- 解析器(Parsers):判断数据类型、不同单元间转换值
- 目标数据:存储或序列化为 RDF 三元组
2.3 DBpedia 抽取的 12 类信息
| # | 信息 | 含义 | 例子 |
|---|---|---|---|
| 1 | 标签(Labels) | 词条标题 → 实体名 | ”蒂姆·伯纳斯-李” → rdfs:label |
| 2 | 摘要(Abstract) | 词条第一段 | 长文本描述 |
| 3 | 跨语言链接 | 不同语言版词条互链 | en: ↔ zh: |
| 4 | 图片(Image) | 词条中的图片链接 | File:Sir_Tim_Berners-Lee.jpg |
| 5 | 重定向(Redirects) | 同义词条关联 | ”TimBL” → “蒂姆·伯纳斯-李” |
| 6 | 消歧(Disambiguation) | 同名歧义实体的内部链接 | ”苹果”:公司/水果/报纸/电影/艺人 |
| 7 | 外部链接 | 词条 → 外网 | 论文/官网 |
| 8 | 页面链接(Pagelinks) | 词条 → 其他 Wiki 词条 | 蕴含实体间关系 |
| 9 | 主页(Homepage) | 公司/机构的官网 | 北航词条中计算机学院主页 |
| 10 | 分类(Categories) | 词条所属类别 | 可用于构建本体 |
| 11 | 地理坐标 | 经纬度 | 城市/地标 |
| 12 | 信息框(Infobox) | 词条的结构化属性 | 最重要:作为实体的属性 |
这几类信息的用途容易混淆:
- Infobox 是 Wikipedia 右侧的属性表,最重要的结构化知识源
- Pagelinks 蕴含实体间关系(链入 = 有关联)
- Categories 可用于构建本体(分类层级 = 本体的 subclass)
- Disambiguation 是消歧任务的关键数据源
- Redirects 是共指消解的关键数据源
Wikipedia 分类可以帮助建立概念层次,但它并不天然等于严格本体,仍需要清洗。Redirects 处理别名,Disambiguation 处理同名不同实体,两者不要混用。
3. 包装器(Wrapper)——Web 网页数据抽取的核心
3.1 什么是包装器
包装器(Wrapper)是一种将数据从 HTML 网页中抽取出来,并将其结构化的软件。
- 同一网站页面通常用少量模板编码
- 包装器 = 一组”抽取规则”(XPath / CSS 选择器 / 正则),定位并抽取目标数据
3.2 包装器生成的 3 种方法
| 方法 | 类型 | 核心思路 | 优点 | 缺点 |
|---|---|---|---|---|
| 手工方法 | 人工 | 人工查看 HTML,写 XPath/CSS 选择器 | 准确率高 | 慢、难维护、不能扩展 |
| 包装器归纳 | 监督学习 | 标注样本 → 学习 XPath 规则 → 泛化 | 比手工快 | 需标注、跨模板泛化差 |
| 自动抽取 | 无监督学习 | 聚类相似页面 → 自动学模板 | 无需标注 | 准确率低 |
从手工、监督到无监督,人工成本逐步降低,自动化程度逐步提高。
3.3 手工方法
- 步骤:
- 打开 Chrome → F12(开发者工具)
- Elements 标签看 HTML
- 找到目标元素 → 右键 → Copy XPath
- 把 XPath 喂给爬虫,循环跑
- 例子:“万维网”标题的 XPath:
//*[@id="mw-content-text"]/div[1]/p[1]/a[1]
3.4 包装器归纳(4 步)
① 网页清洗(Tidy 工具)→ 规范 HTML
② 网页标注 → 给目标数据加 Label
③ 包装器空间生成 → 生成 XPath 集合 + 归纳规则
④ 包装器评估 → 准确率 + 召回率归纳示例:
- 标注两个相同类型元素的 XPath:
- A:
//*[@id="mw-content-text"]/div[1]/table[4]/tbody/tr[2]/td[2] - B:
//*[@id="mw-content-text"]/div[1]/table[4]/tbody/tr[3]/td[2]
- A:
- 归纳后:
//*[@id="mw-content-text"]/div[1]/table[4]/tbody/*/td[2] - 把
tr[2]、tr[3]泛化为*(任意行)——这是监督学习的归纳偏置。
评估规则:
- 选准确率更高的(包装器 A 优于 B)
- 召回率相同时选准确率高的
3.5 自动抽取(无监督)
- 思路:同一网站页面用少量模板,通过学习网页的重复模式找模板
- 步骤:
- 包装器训练:聚类相似网页 → 一组相似网页 → 一个包装器;不需要先验知识和人工标注
- 包装器应用:把目标网页与训练样本比较 → 分类 → 选对应包装器
三类方法分别依赖人工规则、标注样本和页面结构聚类。
4. 网络表(Web Table)抽取
4.1 什么是 Web Table
- Web Table = 网络中内嵌的表格(HTML
<table>) - 特点:使用便利灵活
- 应用:电商、百科、微博、腾讯文档、Wikipedia 等
4.2 数量和价值
- 全球电子表格活跃用户 >40 亿
- 2019 年口径:Wikipedia 52 万篇文章中可抽取 323 万+ 张表
- 有价值信息占比小:141 亿 HTML 表中只有 1.54 亿(1.1%) 是高质量
后一组是 Cafarella 等人 2008 年 WebTables 工作的口径。两组数字不能共用一个年份,但都在说明:网络表数量很大,真正承载高质量关系数据的比例很低。
4.3 网络表分类:4+2 个维度
| 维度 | 类型 | 描述 |
|---|---|---|
| 内容 | 关系(relational) | 描述一系列实体和其属性 |
| 实体(entity) | 描述一个特定实体(学生表、老师表) | |
| 矩阵(matrix) | 三维数据集(标题+行+列) | |
| 其它 | 日历、清单等 | |
| 布局 | 导航(navigational) | 用作网页内容导航 |
| 格式化(formatting) | 用作展示信息 |
实体表 vs 关系表(数据库类比):
- 实体表:存一个对象的属性(Student 表:stuId、stuName、age)
- 关系表:存对象间多对多关系(StudentCourse 表:stuId、courseId)
4.4 网络表的元素(7 个)
| 元素 | 含义 |
|---|---|
| Tp | 表网页题目 |
| Tc | 表题注 |
| TH | 表标题(列头) |
| TE | 表实体(行/单元) |
| T[:j] | 表列 |
| T[i:] | 表行 |
| T[i,j] | 表单元 |
4.5 网络表相关任务
| 任务 | 层级 | 说明 |
|---|---|---|
| 网络表抽取 | 底层 | 从网页中识别、分类、存储表(表语料库构建) |
| 网络表阐释 | 底层 | 表内容 → RDF 三元组 |
| 网络表搜索 | 上层 | 找特定的表 |
| 网络表增广 | 上层 | 用表增强 NLP |
| 知识库增广 | 上层 | 用表补充 KG |
| 问答 | 上层 | 表上做 QA |
可以分成 2 个底层任务(抽取、阐释)和 4 个上层应用。
4.6 网络表抽取的 3 个子任务
| 子任务 | 目标 | 特征 | 方法 |
|---|---|---|---|
| 关系表分类 | 预测表是否含关系数据 | 表大小、标签 | 规则 / 分类器(Cafarella 2008) |
| 标题检测 | 识别列头行 | 类似表元数据 | 复用关系表特征 |
| 表类别分类 | 按预定义分类法分类 | 语法+语义 | 规则 / 深度神经网络 |
5. 网络表阐释
5.1 目标
把表的隐含语义显式表达成 RDF 三元组。
5.2 过程(3 步)
① 候选实体生成:单元格字符串 → 知识库候选实体集合
② 实体链接:字符串 → 知识库中具体实体
③ 实体消歧:候选集合多于一 → 选唯一
5.3 实体链接的影响因子(2 个)
| 因子 | 含义 |
|---|---|
| 提及重要性(mention importance) | 每个字符串本身的重要性 |
| 语义相关度(semantic relatedness) | 不同节点之间的语义相关度 |
5.4 实体消歧
- 用 PageRank 算法整合两个影响因子 → 选得分最高的实体作为链接
- PageRank 完成后,删除其他候选实体和相关边,更新图中的边权值
完整的表语义阐释还要继续做关系与类型解释:先恢复题目、题注、列头、行和单元格,再生成候选实体、完成消歧,最后利用列头和同列类型确定谓词并生成三元组。例如“姚明|上海|2.26 米”只有在列头被解释为“人物|出生地|身高”后,才能可靠生成事实。
6. PageRank 算法(重要基础)
6.1 思想
重要性(importance)评价网页(实体)。这是一个递归过程:页面从指向它的页面接收权重,再把自己的权重分给它所指向的页面。
6.2 物理意义
- 想象用户在网上随机浏览
- 一个网页的 rank = 随机游走达到稳态后,浏览者处于该页面的长期概率
- 高质量页面的链接比低质量页面的链接贡献更大
6.3 算法步骤
① 初始化:rank = 1/N(N 个实体,每个 rank = 1/N)
② 权重更新:每个实体的 rank = Σ 来自指向它的实体的 rank 贡献
   例:E 被 C 和 D 指向
     - C 有 3 个外链 → C 把 1/3 rank 贡献给 E
     - D 有 2 个外链 → D 把 1/2 rank 贡献给 E
③ 处理"死胡同":无外链的实体把 rank 平均分给图中所有其他实体
④ 迭代到收敛(实践中加衰减系数加速)
课件的五节点例子中,出边为:
A → B, C
B → A, C, D
C → A, D, E
D → A, E
E 无出边
初始时五个节点都是 。按课件规则,E 把权重平均分给其余四个节点,每个得 。一轮更新为:
五个结果之和约为 1,与课件图中的 0.28、0.15、0.22、0.18、0.17 一致。
6.4 关键规则
- 课件对无外链节点的处理:该实体的 rank 平均分给图中其他实体
- 物理直觉:用户”找不到目标”时会”随机跳到别处”
- 实践中:用阻尼系数
d(通常 0.85)控制跳转概率:PR(p) = (1-d)/N + d * Σ PR(q)/L(q)
标准实现通常把 dangling node 的权重均匀分给全部 个节点,并加上随机跳转项。考试若明确给出课件的“分给其他节点”规则,就按题面计算。
6.5 PageRank 在 KG 中的应用
- 实体消歧:用 PageRank 整合 mention importance + semantic relatedness → 选唯一实体
- 图节点重要性:评估哪个实体/概念”更重要”
7. 作业中的两个问题
- 包装器归纳法中可以使用哪些有监督模型? 答:决策树、SVM、CRF、BiLSTM-CRF、序列标注模型等。
- 大模型能否实现包装器? 答:可以,LLM(如 GPT-4)能根据 HTML + 抽取需求直接生成结构化数据。是否合适取决于页面模板、校验要求、调用规模和延迟预算:固定模板下传统包装器通常更稳定、成本更低;页面差异较大时 LLM 更灵活,但仍需结构约束和结果校验。
课件还布置了两项实践:以大作业小组为单位提交领域本体模型和有向图可视化;针对小组领域的开放网页手工构造包装器,同时提交原始网页与实体、关系、属性抽取结果。
8. 方法脉络
半结构化知识抽取
├── 什么是半结构化数据
│   └── 标签划分+无严格 schema
│
├── 百科类抽取(DBpedia 框架)
│   ├── 页面集合 → 提取器 → 解析器 → RDF
│   └── 12 类抽取信息
│       ├── Labels(实体名)
│       ├── Abstract(摘要)
│       ├── 跨语言链接
│       ├── Image / Redirects
│       ├── Disambiguation(消歧关键)
│       ├── External / Pagelinks(蕴含关系)
│       ├── Homepage / Categories(可构本体)
│       ├── Geo / Infobox(属性表,最重要)
│
├── Web 网页数据抽取
│   ├── 包装器 = 抽取规则(XPath/CSS)
│   └── 3 大方法
│       ├── 手工(人工 XPath)
│       ├── 包装器归纳(监督)
│       └── 自动抽取(无监督聚类)
│
└── Web Table
    ├── 4 类内容(关系/实体/矩阵/其他)
    ├── 2 类布局(导航/格式化)
    ├── 6 大任务
    │   ├── 2 底层:抽取、阐释
    │   └── 4 上层:搜索、增广、KG 增广、问答
    ├── 抽取 3 子任务(关系表分类/标题检测/表类别)
    └── 阐释 = 实体链接 + 消歧(PageRank)