第三讲 · 知识抽取总论:从数据到三元组
对应 PPT:第3讲 回答:知识抽取做什么?数据源有几种?典型任务是什么?行业评测体系?结构化数据怎么抽?
1. 知识抽取是什么
1.1 定义
知识抽取是自动化构建大规模知识图谱的重要技术,从不同来源、不同结构的数据中提取知识并存入知识图谱。
数据源:结构化(数据库、链接数据)、半结构化(网页表格、列表、HTML)、非结构化(纯文本)
1.2 起源
- 20 世纪 70 年代后期出现于 NLP 研究领域
- 把多个文本碎片的信息合并,将非结构化数据 → 结构化数据(模式、实体关系或 RDF 三元组)
1.3 在技术架构中的位置
应用层    语义搜索 / 智能问答 / 辅助决策
服务层    知识存储 / 知识检索 / 知识推理
支撑层    NLP / 知识抽取 / 知识表示 / ML / DL / 图数据库
         知识融合 / 知识众包 / 知识建模 / 大模型
数据层    非结构化 / 半结构 / 结构化 / 多媒体结构 / 众包
   ↑                                    ↑
   └──── 知识抽取就在这里(数据→知识) ──┘
知识抽取 = 连接数据层和知识层的桥梁
2. 三类数据源
| 数据类型 | 定义 | 例子 | 主要处理难点 | 方法 |
|---|---|---|---|---|
| 结构化 | 严格 schema,二维表 | 关系数据库、链接数据 | 把表、列、主外键映射到图谱 schema | D2R(DM/R2RML) |
| 半结构化 | 自描述,结构+内容混杂 | HTML、JSON、XML、NoSQL | 识别标签、模板和重复页面结构 | 包装器、模板 |
| 非结构化 | 无预定义模型 | 文本、PDF、Word、音视频 | 从上下文中识别实体、关系和事件 | NLP:NER/RE/EE |
课件用 YAGO 说明三类数据会在同一项目里合流:Wikipedia 正文是非结构化数据,分类和信息框是半结构化数据,WordNet 提供结构化的词汇与概念体系,YAGO2 又融合 GeoNames 的地理信息。课件所引版本的量级为 1000 万个实体、1.2 亿个三元组,这是特定版本的统计,不是 YAGO 所有版本的固定数字。
3. 知识抽取的 3 个子任务
3.1 实体识别(NER)
- 从文本检测命名实体,分类到预定义类别
- 类别:人物、组织、地点、时间、日期、字符值、金额值
- 例:「王思聪是万达集团董事长王健林的独子」→
王思聪(人)、万达集团(组织)、王健林(人)
3.2 关系抽取(RE)
- 在 NER 基础上判断实体间关系
- 两步:
- 判断实体对是否有关系(二分类)
- 判断属于哪种关系(多分类)
- 也可一步:把”无关系”当特殊类别
- 例:
王思聪 -父子关系→ 王健林
3.3 事件抽取(EE)
- 识别事件信息,结构化呈现
- 例:恐怖袭击新闻 → 时间、地点、目标、受害人
事件抽取相关术语:
| 术语 | 含义 | 例子 |
|---|---|---|
| 事件描述(Event Mention) | 描述事件的词组或句子 | ”昨天 Apple 发布了 iPhone 16” |
| 事件触发(Event Trigger) | 表明事件出现的主要词汇 | ”发布”(触发”产品发布”事件) |
| 事件元素(Event Argument) | 事件的重要信息 | 发布者=Apple、发布时间=昨天、产品=iPhone 16 |
| 语义角色(Argument Role) | 元素在句子中的语义角色 | 施事者、受事者、时间、地点 |
辨析:触发词 ≠ 实体。触发词是动词/名词,标志事件;实体是具体人/事/物。
3.4 三者关系
事件抽取
  └── 触发词识别 + 事件元素识别
关系抽取
  └── 实体识别 + 关系分类
实体识别
  └── 最底层任务
工业 pipeline:NER → RE → EE;学术:联合抽取(joint extraction)
4. 三项代表性行业评测
4.1 MUC(Message Understanding Conference)
| 维度 | 内容 |
|---|---|
| 主办 | 美国 DARPA |
| 时间 | 1987~1998 |
| 推动 | NER、共指消解 |
| 成就 | F1 ~90%,定下知识抽取评价体系 |
4.2 ACE(Automatic Content Extraction)
| 维度 | 内容 |
|---|---|
| 时间 | 1999~2008 |
| 关系 | 融合 MUC、细化分类 |
| 任务 1 | 实体检测与跟踪(5 类:人/组织/设施/地缘/位置) |
| 任务 2 | 关系检测与表征(5 大类 24 小类:角色/部分整体/位于/邻近/社会) |
| 任务 3 | 事件检测与表征(5 类:交互/移动/转移/创建/销毁) |
4.3 KBP(Knowledge Base Population)
| 维度 | 内容 |
|---|---|
| 时间 | 2009~(TAC 评测) |
| 关系 | ACE 升级,目标”填充知识库” |
| 任务 1 | 实体发现与链接(EL:link 到 KG 节点) |
| 任务 2 | 槽填充(Slot Filling)(填实体属性) |
| 任务 3 | 事件跟踪 |
4.4 三者关系
MUC (1987~1998) → ACE (1999~2008) → KBP/TAC (2009~至今)
   基础定义            细化任务           知识库填充
三者的侧重点可以概括为:MUC 奠定任务形式,ACE 扩展实体与关系类型,KBP 面向知识库补全。
5. 网页数据采集基础(爬虫)
5.1 流程(4 步)
① 取得目标 URL
② 提交 HTTP 请求
③ 解析 HTTP 响应
④ 存储解析结果
5.2 HTTP 请求/响应
请求:
| 字段 | 内容 |
|---|---|
| 请求方式 | GET(取资源)、POST(提交) |
| 请求 URL | 资源唯一地址 |
| 请求头 | User-Agent、Host、Cookies |
| 请求体 | 额外数据(表单) |
响应:
| 字段 | 内容 |
|---|---|
| 响应状态 | 200 成功、301 跳转、404 找不到、502 服务器错误 |
| 响应头 | Content-Type、Content-Length、Set-Cookies |
| 响应体 | HTML、图片二进制等 |
5.3 解析工具对比
| 工具 | 定位方式 | 使用方式 | 适合场景 |
|---|---|---|---|
| XPath | 用路径表达式选择 DOM 节点,可按层级、属性和文本过滤 | 需要理解文档树和 XPath 语法 | HTML/XML 结构明确、需要精确定位节点 |
| BeautifulSoup | 按标签、属性和树关系查找节点 | Python 对象接口,便于逐步遍历和清洗 | 页面结构不规整、快速编写抽取脚本 |
| PyQuery | 使用 CSS 选择器和类似 jQuery 的遍历方法 | Python 中沿用 jQuery 风格 API | 熟悉前端选择器、希望用 CSS 语法处理 HTML |
XPath 适合明确路径和性能要求,BeautifulSoup / PyQuery 写起来更直接。
5.4 数据存储
- 文本:JSON、XML、CSV
- 关系型数据库:MySQL、PostgreSQL
- 二进制:图片、视频、音频直接存
6. 面向结构化数据的知识抽取(D2R)
核心问题:关系数据库怎么变成 RDF / OWL 本体?
6.1 抽取原理:5 组对应关系
| 关系数据库 | RDF / OWL |
|---|---|
| 表(Table) | 类(Class) |
| 列(Column) | 属性(Property) |
| 行(Row) | 资源/实例(Resource/Instance) |
| 单元(Cell) | 属性值(Property Value) |
| 外键(Foreign Key) | 指代(Reference / ObjectProperty) |
6.2 W3C RDB2RDF 标准(2012)
| 标准 | 全称 | 特点 |
|---|---|---|
| DM | Direct Mapping | 自动、规则固定、不灵活 |
| R2RML | RDB to RDF Mapping Language | 可定制、支持 SQL 视图、灵活 |
6.3 DM 直接映射规则
| 数据库元素 | 映射为 |
|---|---|
| 表 | RDF 类 |
| 表的列 | RDF 属性 |
| 每一行 | 一个资源(创建 IRI) |
| 单元格的值 | Literal 值 |
| 外键 | 新三元组,宾语为被引用行的 IRI |
IRI 生成规则:
- 主语 IRI = 前缀 + 表名 + 主键列名 + 主键值
- 例:
<.../People/ID/7>
- 例:
- 谓词 IRI = 前缀 + 表名 + 列名
- 例:
<.../People/fname>
- 例:
- 外键列会生成关系三元组:
- 谓词 IRI 描述外键关系,例如
<.../People/ref-addr>; - 宾语 IRI 指向被引用表中的具体行,由被引用表名、主键列名和主键值构成,例如
<.../Addresses/ID/18>。
- 谓词 IRI 描述外键关系,例如
注意:DM 不为 NULL 值生成三元组。
例如 People(ID=7, fname="Bob", addr=18) 的 addr 外键指向 Addresses(ID=18, city="Cambridge"),可得:
<.../People/ID/7> rdf:type <.../People> .
<.../People/ID/7> <.../People/fname> "Bob" .
<.../People/ID/7> <.../People/ref-addr> <.../Addresses/ID/18> .
<.../Addresses/ID/18> <.../Addresses/city> "Cambridge" .
外键对应的宾语是被引用行的 IRI,不是把数字 18 当作普通字符串。
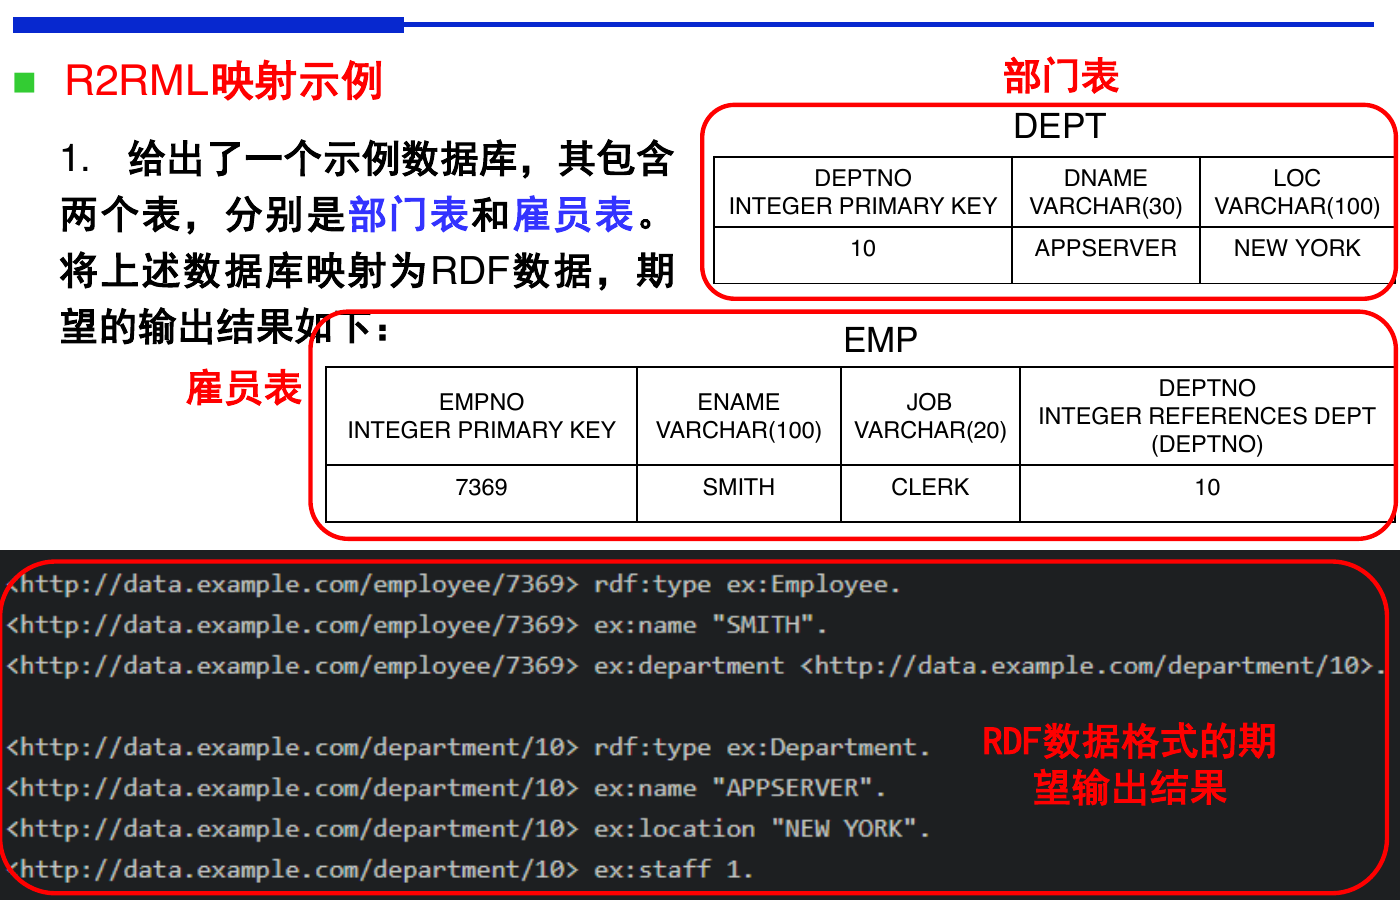
6.4 R2RML 映射
- 逻辑表(Logic Table) = 数据库中的表、视图或 SQL 查询
- 三元组映射(Triples Map) = 一个逻辑表 → 一组 RDF 三元组
- 包含:
- 主语映射(主语模板 = IRI)
- 谓语-宾语映射(谓词模板 + 宾语模板/引用)
优点:可自定义类名、属性名、URI 前缀;支持多表 join;支持 SQL 视图。
逻辑表提供行,Subject Map 生成资源,Predicate-Object Map 把列值或外键变成事实。
课件的 DEPT 和 EMP 例子可写成下面这份最小映射:
@prefix rr: <http://www.w3.org/ns/r2rml#> .
@prefix ex: <http://example.com/schema/> .

<#DeptMap> a rr:TriplesMap ;
  rr:logicalTable [ rr:tableName "DEPT" ] ;
  rr:subjectMap [
    rr:template "http://example.com/dept/{DEPTNO}" ;
    rr:class ex:Department
  ] ;
  rr:predicateObjectMap [
    rr:predicate ex:name ;
    rr:objectMap [ rr:column "DNAME" ]
  ] .

<#EmpMap> a rr:TriplesMap ;
  rr:logicalTable [ rr:tableName "EMP" ] ;
  rr:subjectMap [
    rr:template "http://example.com/employee/{EMPNO}" ;
    rr:class ex:Employee
  ] ;
  rr:predicateObjectMap [
    rr:predicate ex:department ;
    rr:objectMap [
      rr:parentTriplesMap <#DeptMap> ;
      rr:joinCondition [
        rr:child "DEPTNO" ;
        rr:parent "DEPTNO"
      ]
    ]
  ] .
rr:child 读取当前雇员行的外键,rr:parent 在部门表中找同值主键,rr:parentTriplesMap 再把雇员连到对应部门资源。
| 选择 | Direct Mapping | R2RML |
|---|---|---|
| 是否手写映射 | 不需要 | 需要 |
| 是否能改类名、属性名与 IRI | 基本不能 | 可以 |
| 是否能用视图或 SQL | 不强调 | 可以 |
| 适用场景 | 快速得到结构忠实的 RDF | 面向业务语义的可控映射 |
6.5 D2R 工具对比
| 工具 | 能导出 RDF | 支持推理 | 开源 | 备注 |
|---|---|---|---|---|
| D2RQ | ✅ | ❌ | ✅(DERI+惠普) | 最老牌,部分支持 R2RML |
| Mastro | ✅ | ✅(带推理机) | ❌ 商业 | 多数据库支持 |
| Ultrawrap | ✅ | ✅ | ❌ 商业 | 编译器+服务器,SPARQL 速度 = SQL |
| Ontop | ❌(虚拟 RDF 图) | ✅ | ✅(GitHub) | 主流,SPARQL 翻译为 SQL |
各工具的定位:
- D2RQ = 老牌、轻量、无推理
- Mastro = 商业 + 推理
- Ultrawrap = 商业 + 高性能
- Ontop = 开源主流、不导出真实 RDF,只在查询时动态生成
6.6 OBDA 范式(新概念)
OBDA = Ontology-Based Data Access,基于本体的数据访问。
- 企业已有大规模关系数据库
- 不重建知识图谱,用 SPARQL 直接查询关系数据库
- 底层:R2RML + 推理机
- 工具:Mastro、Ontop 都属于 OBDA 系统
OBDA 的意义在于:不迁移原始数据,也能通过本体访问传统关系数据库。
工具表中的“能否导出 RDF”和“能否让用户用 SPARQL 看见虚拟 RDF 图”是两件事。D2RQ 可以把 Web 或 SPARQL 请求即时改写为 SQL,也可导出 RDF;Mastro 和 Ultrawrap 提供映射、查询与推理能力;Ontop 用 R2RML 暴露虚拟 RDF 图,在查询时把 SPARQL 翻译成 SQL,不以离线生成整库 RDF 为目标。
7. 抽取流程索引
知识抽取总论
├── 知识抽取定义
│   └── 连接数据层和知识层的桥梁
│
├── 三类数据源
│   ├── 结构化(数据库)→ D2R
│   ├── 半结构化(HTML/JSON)→ 包装器
│   └── 非结构化(文本)→ NLP
│
├── 3 个子任务
│   ├── NER(人/组织/地点/时间…)
│   ├── RE(实体对 + 关系)
│   └── EE
│       ├── Event Mention
│       ├── Trigger("发布")
│       ├── Argument
│       └── Argument Role
│
├── 3 项代表性评测
│   ├── MUC (1987~1998)
│   ├── ACE (1999~2008):5 实体/24 关系/5 事件
│   └── KBP (2009~):EL + 槽填充 + 事件跟踪
│
├── 爬虫(前置)
│   ├── 流程:URL→请求→解析→存储
│   ├── 请求方式:GET/POST
│   ├── 响应状态:200/301/404/502
│   └── 解析工具:XPath / BS4 / PyQuery
│
└── 结构化数据抽取
    ├── 5 个对应:表/列/行/单元/外键 → 类/属性/实例/值/指代
    ├── W3C 标准:DM(自动)vs R2RML(可定制)
    ├── DM 规则:主语=前缀+表+主键+值,谓词=前缀+表+列
    ├── R2RML:逻辑表+三元组映射
    ├── 工具:D2RQ / Mastro / Ultrawrap / Ontop
    └── OBDA:不迁移数据,SPARQL 查 DB