第二讲 · 知识表示:从符号、本体到语义网
对应 PPT:第2讲 后续的抽取、融合和推理都依赖”知识怎么写”,我在这一讲梳理几种主要表示方法及其关系。
1. 知识表示概述
知识表示 = 知识的符号化和形式化过程,是用机器表示知识的可行性、有效性方法。 把人类知识编码成计算机能存储、能处理、能推理的符号集合。
发展脉络
| 时间 | 流派 | 关键贡献 |
|---|---|---|
| 1934 | 产生式(Post) | 因果规则 |
| 1960 年前 | 一阶谓词逻辑 | 形式化推理 |
| 1966 | 语义网络(Quillian) | 联想记忆模型 |
| 1970s | 框架(Minsky) | 结构化对象 |
| 1980s | 描述逻辑 | 本体推理 |
| 1998 | RDF(W3C) | 语义网数据模型 |
| 2004 | OWL | 本体语言 |
| 2000s+ | 属性图 | 工业图数据库 |
| 2013+ | 表示学习(TransE) | 向量化 |
2. 一阶谓词逻辑(FOPL)
三元素
- 个体词:具体/抽象个体或变量(姚明、上海、x、y、z)
- 谓词:刻画个体性质/关系(“是学生”、“出生于”、“大于”)
- 量词:全称量词 ∀(任意)+ 存在量词 ∃(存在)
表示举例
出生于(姚明, 上海)            — 二元谓词
身高(姚明, 2.26)              — 属性谓词
出生于(x, 中国) → 中国人(x) — 课堂式推断规则示意,不是等价定义谓词的元数 = 连接几个个体。一元 = 性质,多元 = 关系。
最后一条只用来说明如何用谓词写推断规则,不是对现实国籍的普遍断言;出生地本身不足以确定国籍。
优缺点
| 优点 | 缺点 |
|---|---|
| 严密性:演绎推理结果正确 | 无法表示不确定性(没有概率) |
| 自然性:接近自然语言 | 缺乏组织原则,知识库管理困难 |
| 通用性:通用演算和推理规则 | 组合爆炸,规模一大就慢 |
需要会解释:为什么有了谓词逻辑,还需要语义网络和产生式?谓词逻辑表达能力强但组织性差,不适合直接组织大规模知识库。
3. 语义网络(Semantic Network)
起源
- 1966 年 Quillian 研究人类联想记忆提出;
- 心理学模型 → AI 知识表示方法。
结构
- 有向图:节点 = 概念,边 = 概念间语义关系
- 边类型:is-a、part-of、has、agent、location…
表示举例
"鸟" ISA 动物;"鸟" HAS 翅膀;"鸟" CAN 飞
"鸵鸟" ISA 鸟  →  鸵鸟 CAN 飞  ✗ 错的(鸵鸟不会飞)
优缺点
| 优点 | 缺点 |
|---|---|
| 联想性:符合人类联想记忆 | 非严格性:无公认公理 |
| 易用性:直观 | 处理效率低:图结构检索慢 |
| 结构性:组织复杂语义 | 无法表示量化、复杂逻辑 |
语义网络可以看作图形式的 FOPL 子集,和一阶谓词逻辑之间较容易转换。
4. 产生式系统(Production System)
起源
- 1934 年 E. Post 提出;心理学家认为人脑对知识的存储就是产生式;
- 用规则序列形式描述问题求解的思维模式。
两种基本结构
① 事实(Fact)
- 确定性事实 = 三元组 (对象, 属性, 值) 或 (对象1, 关系, 对象2)
- 例:
乔布斯的性别 = 男
- 例:
- 不确定性事实 = 四元组 (对象, 属性, 值, 置信度)
- 例:
手机特性是防水的可能性 = 0.9
- 例:
② 规则(Rule)
- 确定性规则:
P → Qx 是 y 的老师 → y 是 x 的学生x 出生于 z ∧ y 出生于 z → x 和 y 是同乡
- 不确定性规则:
P → Q (置信度)x 导演电影 y ∧ x 的国籍是英国 → 电影 y 的语言是英语 (0.8)
系统结构(3 部件)
┌──────────┐    ┌──────────┐    ┌──────────┐
│  数据库   │ ←→ │  推理机   │ ←→ │  规则库   │
│ (事实)    │    │ (控制)    │    │ (规则)    │
└──────────┘ └──────────┘ └──────────┘- 数据库:初始事实、中间结果、最终结论
- 规则库:所有相关规则
- 推理机:
- 按策略选规则与数据库匹配
- 匹配多条时冲突消解
- 执行规则后件
两种推理方向
| 方向 | 别名 | 思路 | 适用 |
|---|---|---|---|
| 正向推理 | 数据驱动、前向链 | 事实 → 规则 → 结论 | 已知事实,求所有可能结论 |
| 反向推理 | 目标驱动、反向链 | 目标 ← 规则 ← 事实 | 已知目标,验证可行性 |
正向推理例子(动物识别:目标 = “A 是猎豹?”):
规则库:
  R1: 有毛发 → 哺乳动物
  R2: 吃肉 → 食肉动物
  R3: 哺乳动物 ∧ 食肉动物 ∧ 黄褐色 ∧ 暗斑点 → 猎豹

数据库:
  A 有毛发 ✓ → 触发 R1 → 数据库新增"哺乳动物"
  A 吃肉 ✓ → 触发 R2 → 数据库新增"食肉动物"
  A 黄褐色 ✓,A 暗斑点 ✓ → 触发 R3 → "A 是猎豹"
优缺点
| 优点 | 缺点 |
|---|---|
| 自然性:符合 IF-THEN 思维 | 效率低(规则多时匹配慢) |
| 模块性:规则独立,易增删 | 不适合结构化知识 |
| 不确定性:可加置信度 | 难以维护规则间一致性 |
| 可解释性强 | 规则冲突难消解 |
产生式是专家系统的规则表示方式;专家系统通常由知识库、推理机和综合数据库组成。
5. 框架(Frame)
起源
- 1975 年 Minsky 在论文 “A Framework for Representing Knowledge” 中提出;
- 灵感来自视觉感知:人看到新场景时用”框架”去匹配。
结构
框架 = 带**槽位(slot)和侧面(facet)**的数据结构:
框架名: 鸟类
  ISA: 动物
  槽1: 翅膀
      值: 有
      继承: 默认
  槽2: 飞行能力
      值: 能
      继承: 默认
  槽3: 体色
      值: 默认(灰)
关键机制
- 继承:子框架继承父框架的槽值
- 鸵鸟继承”鸟”的”翅膀=有”,但可重定义”飞行能力=不能”——解决语义网络的”鸵鸟会飞”问题
- 匹配:新场景和框架匹配,填槽
- 侧面:每槽多个侧面(值类型、默认值、继承规则)
优缺点
| 优点 | 缺点 |
|---|---|
| 结构性:知识组织成结构化单元 | 缺乏形式化语义 |
| 继承性:支持默认值和例外 | 难以处理动态变化 |
| 自然性:符合人类认知 | 不适合过程性知识 |
对比记忆:语义网络 = 平面的图;框架 = 带结构的”对象模板”。
6. 描述逻辑(Description Logic,DL)
定位
- 一阶谓词逻辑的可判定子集(为本体推理设计)
- 1980s 提出,是 OWL、Protégé 的逻辑基础
- 解决 FOPL 不可判定 + 语义网络无严格语义的中间路线
核心构件
| 构件 | 含义 | 例子 |
|---|---|---|
| 概念(Concept) = 类 | 对象的集合 | 人物、学生 |
| 角色(Role) = 属性/关系 | 二元关系 | 有孩子、教授课程 |
| 个体(Individual) | 具体实例 | 姚明、知识图谱课 |
| 构造算子 | 构造复杂概念 | 合取 ⊓、析取 ⊔、非 ¬、存在 ∃、全称 ∀ |
表示示例
| 自然语言 | DL 形式 |
|---|---|
| ”人” | Person |
| ”有孩子的男人” | Man ⊓ ∃hasChild.Person |
| ”有至少 3 个孩子的人” | Person ⊓ ≥3 hasChild |
| ”母亲” | Woman ⊓ ∃hasChild.Person |
TBox vs ABox
- TBox(Terminology Box):模式层——定义概念和角色
Mother ≡ Woman ⊓ ∃hasChild.Person
- ABox(Assertion Box):实例层——具体个体的断言
Mother(Alice),hasChild(Alice, Bob)
TBox 记录类定义,ABox 记录类的实例,分别对应概念层和实例层。
推理任务(DL 核心价值)
| 任务 | 含义 | 例子 |
|---|---|---|
| 概念可满足(Satisfiability) | 概念能否有实例 | 若已声明 Man ⊓ Woman ⊑ ⊥,则二者交集不可满足 |
| 概念包含(Subsumption) | A 是否包含 B | Mother ⊑ Woman |
| 实例检测(Instance Checking) | 个体是否属于概念 | Mother(Alice) 是否成立 |
| 一致性(Consistency) | ABox 是否矛盾 | 在 Man 与 Woman 已声明不相交时,Alice 同属二者会矛盾 |
优缺点
| 优点 | 缺点 |
|---|---|
| 可判定性:算法保证终止 | 表达力弱于 FOPL |
| 形式化语义 | 难处理不确定性 |
| 支持自动推理 | 实现复杂 |
| OWL 标准化 |
7. 本体(Ontology)
定义
- 起源于哲学(“存在的本质”)
- AI 视角:本体是特殊类型的术语集,具有结构化特点,更适合计算机处理
- 作用:把领域知识用共享的、形式化的、明确的概念集描述出来
本体的构成(5 元组)
本体 O = (C, R, F, A, I)
  C = 概念集(Class)
  R = 关系集(Relation)
  F = 函数集(Function)
  A = 公理集(Axiom)
I = 实例集(Instance)- 函数是特殊关系:前 个元素能唯一确定第 个元素,如
Father-of(x,y)。 - 属性仍然是建模要素,但在这份课件的五元组定义中,它属于关系语义,不能用来替换 Function。
关系类型
| 关系 | 含义 | 例子 |
|---|---|---|
| part-of | 部分与整体 | 翅膀 part-of 鸟 |
| kind-of / subClassOf | 继承 | 鸟 kind-of 动物 |
| instance-of | 实例与类 | 姚明 instance-of 体育人物 |
| attribute-of | 属性 | 年龄 attribute-of 人 |
本体 vs 知识图谱
| 维度 | 本体 | 知识图谱 |
|---|---|---|
| 层 | 概念层 / 模式层 | 概念层 + 实例层(包含本体) |
| 内容 | 类、关系、属性、公理 | 大量实例三元组 |
| 规模 | 通用本体数千概念,领域更少 | 实例可达数十亿 |
| 推理 | 描述逻辑推理 | 本体推理 + 图结构推理 + 表示学习 |
本体给出 schema,实例数据填充具体事实,因此可以把 KG 写成“本体(schema)+ 实例(data)”。
课件用四个词限定“什么才算本体”:共享(shared)、概念化(conceptualization)、明确(explicit)和形式化(formal)。只有个人私有分类、没有共享语义和形式约束的目录,不一定构成严格意义上的本体。
Protégé 是课件中的本体建模工具。可以在其中建立 Class 层次、Object Property、Data Property 和 Individual,再用 HermiT 等推理机检查一致性。LLM 可以辅助生成或补全本体,但仍需要用类型、公理和人工审核约束结果。
8. RDF(Resource Description Framework)
定位
- W3C 推荐标准
- KG 的最基本数据模型
- 用三元组 (Subject, Predicate, Object) 描述资源
三个组成
- 资源(Resource):用 URI 标识任何事物
- 例:
http://www.w3.org/People/Berners-Lee/card#i
- 例:
- 属性(Property):资源的特征或关系
- 陈述/语句(Statement):一个三元组 = 一个事实
数据模型
- 本质是有向标记图
- 节点 = Subject 或 Object(URI 资源 + literal + blank node)
- 边 = Predicate(有方向)
表示方式
| 方式 | 例子 |
|---|---|
| 三元组 | (ex:Beijing, ex:locatedIn, ex:China) |
| RDF/XML | <rdf:Description rdf:about="ex:Beijing"><ex:locatedIn rdf:resource="ex:China"/></rdf:Description> |
| Turtle | ex:Beijing ex:locatedIn ex:China . |
| N-Triple | <ex:Beijing> <ex:locatedIn> <ex:China> . |
命名空间(Namespace)
@prefix ex: <http://example.org/> .
@prefix rdf: <http://www.w3.org/1999/02/22-rdf-syntax-ns#> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .
@prefix owl: <http://www.w3.org/2002/07/owl#> .
@prefix xsd: <http://www.w3.org/2001/XMLSchema#> .- rdf::RDF 核心词汇
- rdfs::RDF Schema(类、属性、子类、子属性)
- owl::Web 本体语言
- xsd::XML Schema 数据类型
RDF Schema(RDFS)核心词汇
| 词汇 | 含义 | 例子 |
|---|---|---|
rdfs:Class | 声明一个类 | ex:Person rdf:type rdfs:Class |
rdf:type | 声明实例属于类 | ex:姚明 rdf:type ex:人物 |
rdfs:subClassOf | 子类 | ex:体育人物 rdfs:subClassOf ex:人物 |
rdfs:subPropertyOf | 子属性 | ex:身高 rdfs:subPropertyOf ex:属性 |
rdfs:domain | 属性定义域 | ex:身高 rdfs:domain ex:人物 |
rdfs:range | 属性值域 | ex:身高 rdfs:range xsd:decimal |
rdfs:label | 标签 | ex:姚明 rdfs:label "姚明"@zh |
rdfs:comment | 注释 | ex:姚明 rdfs:comment "中国篮球运动员"@zh |
语义网技术栈
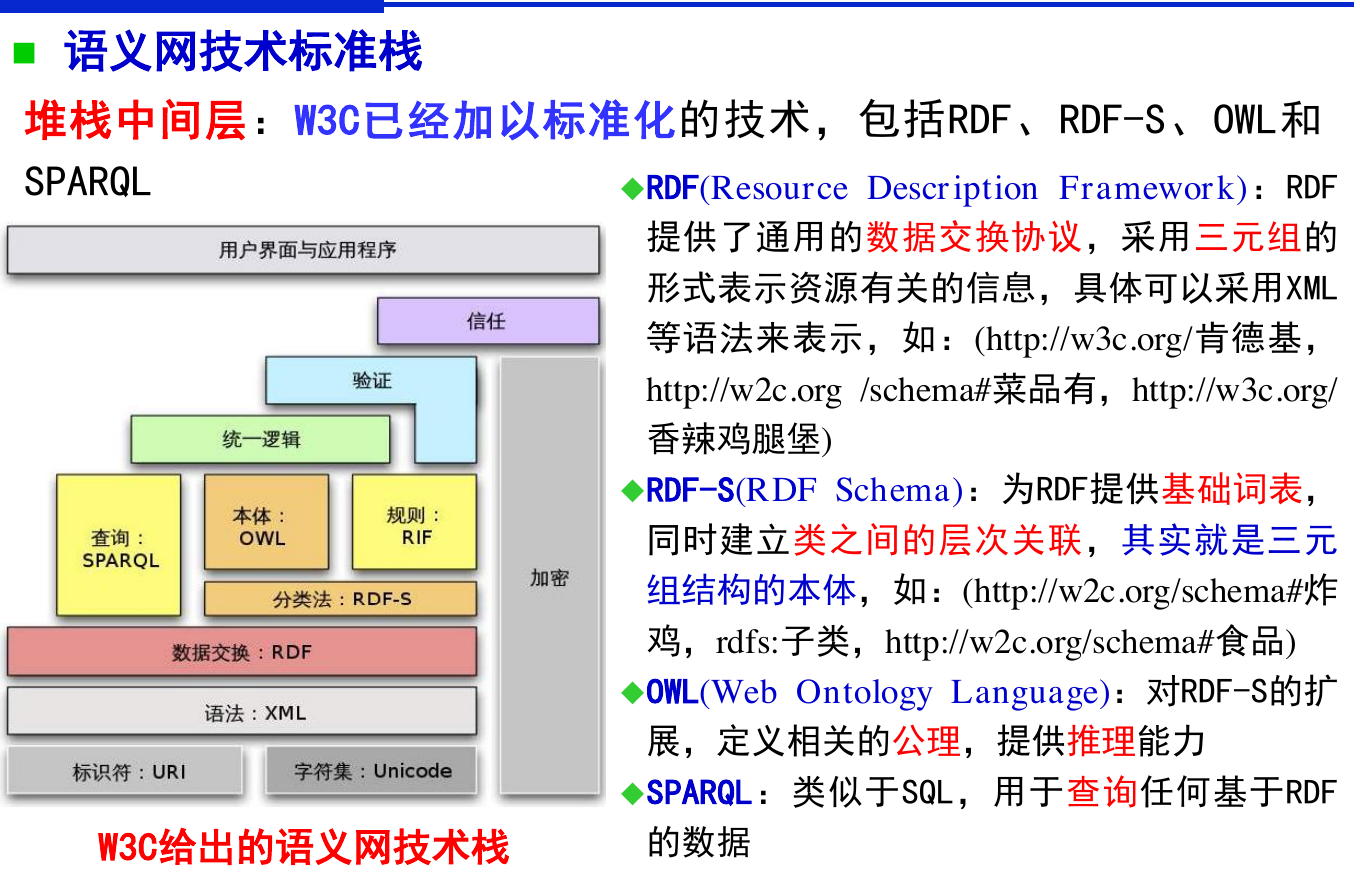
全局标识和文档语法在底层,向上依次增加图事实、模式、公理、查询与可信应用。
| 层次 | 负责什么 |
|---|---|
| URI / IRI | 给网络资源全局标识 |
| XML、XML Schema | 提供文档语法和数据类型 |
| RDF | 用主语—谓语—宾语表达图事实 |
| RDFS | 定义类、属性、定义域、值域和子类层次 |
| OWL | 增加等价、不相交、互逆和基数等公理 |
| SPARQL | 用图模式匹配查询 RDF 数据 |
课件顶层还列出 RIF、加密、证明、信任和用户界面等能力。它们讨论规则怎样交换、推理结果怎样证明、来源是否可信,不是新的知识数据模型。
RDF 局限性 → 引出 OWL
RDF/RDFS 表达不了:
- 类的不相交(DisjointWith)
- 属性的特征(传递、对称、函数性)
- 基数约束(最小/最大)
- 枚举类
→ OWL 解决。
9. OWL(Web Ontology Language)
定位
- W3C 推荐标准
- 在 RDF 之上,基于描述逻辑
- 弥补 RDF 表达能力不足
OWL 1 与 OWL 2
OWL Lite、OWL DL 和 OWL Full 是 OWL 1 的三个子语言,不能把后续版本 OWL 2 当作排在 OWL Full 后面的“第四档”。本讲重点是 OWL 2 的三个 Profile:
| OWL 2 Profile | 主要目标 | 适用场景 |
|---|---|---|
| OWL 2 QL | 基于本体的数据查询 | 将本体查询改写到关系数据库 |
| OWL 2 EL | 概念术语描述与本体推理 | 大型、层次深的术语体系 |
| OWL 2 RL | 规则化的可扩展推理 | 推理复杂度控制在多项式时间 |
OWL 1 中,OWL Lite 和 OWL DL 保留了可判定的描述逻辑语义,OWL Full 允许更自由地混用 RDF 和 OWL,但不保证推理可判定。
OWL 核心构造
@prefix ex: <http://example.org/> .
@prefix owl: <http://www.w3.org/2002/07/owl#> .
@prefix rdf: <http://www.w3.org/1999/02/22-rdf-syntax-ns#> .

ex:男人 owl:disjointWith ex:女人 .
ex:配偶 rdf:type owl:SymmetricProperty .
ex:祖先 rdf:type owl:TransitiveProperty .
ex:身高 rdf:type owl:FunctionalProperty .
ex:hasTeacher owl:inverseOf ex:hasStudent .
互逆属性的正确词汇是小写开头的 owl:inverseOf。描述逻辑中的 、、 等概念表达式需要转成 OWL 对应的 RDF 结构,不能直接写进 Turtle 主谓宾位置。课件“对称性”示例旁的 owl:TransitiveProperty 声明的是传递性;配偶关系应使用 owl:SymmetricProperty。
OWL 推理机
- HermiT、Pellet、FaCT++
- 自动做:概念分类(subsumption)、一致性检查、实例分类、属性推理
10. SPARQL 与 JSON-LD
SPARQL 是 RDF 查询语言,不是另一套知识模型。课件的商品例子先用 RDF 记录华为 FreeBuds Pro 2 的品牌和功能,再用 OWL 规则推出“同品牌商品”和“同功能商品”。查询这两类关联商品可以写成:
PREFIX schema: <http://item.org/schema#>
PREFIX item: <http://item.org/>

SELECT DISTINCT ?item
WHERE {
  { ?item schema:同功能商品 item:Haiwei_FreeBuds_Pro2 . }
  UNION
  { ?item schema:同品牌商品 item:Haiwei_FreeBuds_Pro2 . }
}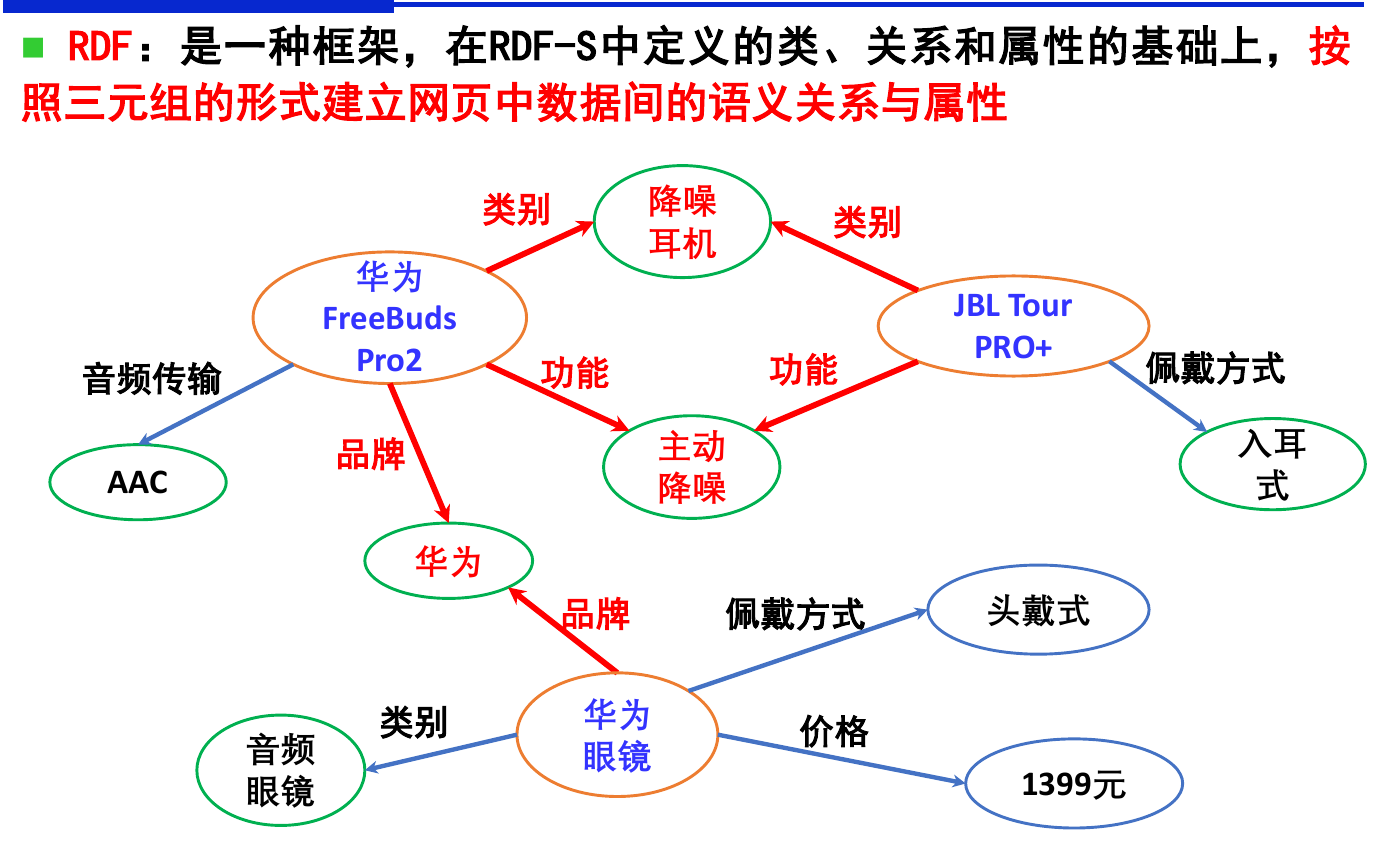
URI 标识商品,RDF 写事实,RDFS/OWL 规定语义,SPARQL 查询推理后的关联。
JSON-LD 则用 @context 把普通 JSON 字段链接到共享词汇,用 @id 标识资源:
{
  "@context": "https://schema.org",
  "@id": "https://example.org/people/1",
  "@type": "Person",
  "name": "李明",
  "jobTitle": "知识工程师"
}
它保留 JSON 的开发体验,同时可以解释为 RDF 有向图。
11. 属性图(Property Graph)
定位
- 和 RDF 并列的另一套 KG 数据模型
- 图数据库(Neo4j、JanusGraph、OrientDB)的标准模型
- 工业界更常用
三要素
- 节点(Node):实体,有类型标签 + 属性键值对
- 边(Relationship):定向、有类型 + 属性键值对
- 属性(Property):键值对,节点和边都可以有
示例
// 节点
(姚明:Person {姓名:"姚明", 身高:2.26, 出生年份:1980})
(上海:City {名称:"上海"})

// 边
(姚明)-[:出生于 {时间:1980}]->(上海)
属性图 vs RDF
| 维度 | 属性图 | RDF |
|---|---|---|
| 节点/边的原生属性 | 节点和边均可原生携带键值属性 | 无原生边属性;陈述元数据需额外建模 |
| 标准化 | 无 W3C 标准(de facto Neo4j) | W3C 标准 |
| 推理支持 | 弱(无内置描述逻辑) | 强(OWL) |
| 工业落地 | 主流(Neo4j 用户多) | 学术 / 政府 / 出版业多 |
| 查询语言 | Cypher(Neo4j) | SPARQL(W3C) |
| 数据规模 | 千亿级(JanusGraph) | 万亿级(专用三元组库) |
| Schema 灵活性 | 灵活,不强制 | OWL 严格,RDF 自由 |
RDF 更强调标准化与互操作,属性图更贴近图数据库的工程使用;两者可以转换,但原生建模方式不同。
RDF 的”中间节点表示属性”
<姚明> <身高> _:b1 .          ← blank node
_:b1 <数值> "2.26" .
_:b1 <单位> "米" .
属性图直接:
(姚明 {身高: "2.26 米"})这个例子表现的是两种原生模型的差异:属性图直接写键值对,RDF 通过额外三元组表达复合值。
12. 知识表示学习(KRL)— 概念引入
为什么需要
传统表示痛点:
- 稀疏性:one-hot,百万实体 = 百万维
- 语义鸿沟:符号相似 ≠ 语义相似
- 难以融入 DL:符号不能直接喂给神经网络
目标
- 实体/关系表示成稠密低维实值向量
- 向量之间有语义距离(cosine 距离近 = 语义相似)
- 可直接用于神经网络下游任务
经典代表:TransE(2013)
- 核心假设:h + r ≈ t(头实体 + 关系 ≈ 尾实体)
- 例:
Vec(姚明) + Vec(出生于) ≈ Vec(上海) - 损失函数:让正样本距离小、负样本距离大
对正确事实“姚明出生于上海”,训练希望
尽可能小;对“姚明出生于北京”等错误候选,希望同一距离更大。只拉近正例而不构造负例,向量可能全部塌缩在一起。
课件还列出实数向量或张量、复数空间、高斯分布和流形空间四类表示。它们分别便于一般数值计算、表达对称/反对称关系、表达不确定性,以及建模非线性几何。TransE 只是其中最容易理解的起点。
13. 各表示方法对比总结
| 表示方法 | 形式 | 优点 | 缺点 | 适用 |
|---|---|---|---|---|
| 一阶谓词逻辑 | 符号 + 量词 | 严密、自然、通用 | 无不确定性、组织性差、组合爆炸 | 形式化推理、小规模 |
| 语义网络 | 有向图 | 直观、联想、结构化 | 非严格、效率低、无法量化 | 早期 AI、NLU |
| 产生式 | IF-THEN 规则 | 自然、模块化、可解释、不确定性 | 效率低、难维护 | 专家系统、规则引擎 |
| 框架 | 槽-侧面结构 | 继承、默认值、结构化 | 缺乏形式化语义 | 视觉、对象识别 |
| 描述逻辑 | DL 语法 | 可判定、形式化、OWL 基础 | 表达力受限 | 本体推理 |
| 本体 | 5 元组 | 共享、明确、形式化 | 构建成本高 | 领域知识建模 |
| RDF | 三元组 | 标准化、灵活、可融合 | 无属性、表达弱 | 语义网、数据交换 |
| OWL | DL + RDF | 强表达、可推理 | 复杂、性能差 | 复杂本体建模 |
| 属性图 | 节点+边+属性 | 工业实用、查询高效 | 无 W3C 标准、推理弱 | 图数据库应用 |
| 表示学习 | 向量 | 可融 DL、语义平滑 | 不可解释、需训练 | DL+KG 融合 |
14. 表示方法关系
知识表示
├── 发展时间线
│   ├── 1934 产生式 → 1960 年前 FOPL → 1966 语义网 → 1975 框架
│   ├── 1980s 描述逻辑 → 1998 RDF → 2004 OWL
│   ├── 2000s+ 属性图 → 2013+ 表示学习
│
├── 传统表示(5 种)
│   ├── 一阶谓词逻辑 FOPL
│   ├── 语义网络
│   ├── 产生式(IF-THEN 规则)
│   ├── 框架(槽+侧面+继承)
│   └── 描述逻辑(FOPL 可判定子集)
│
├── 本体
│   └── 5 元组(C,R,F,A,I)
│
├── 标准化表示(3 套)
│   ├── RDF(三元组+命名空间+RDFS)
│   ├── OWL(OWL 2 QL/EL/RL)
│   ├── SPARQL / JSON-LD
│   └── 属性图(Neo4j/Cypher)
│
└── 表示学习
    └── 向量/复数/高斯/流形;h+r≈t