第一讲 · 知识图谱概述
对应 PPT:第1讲 我在这一讲先回答 4 个问题:为什么要有 KG / KG 是什么 / KG 怎么来的 / KG 怎么造怎么用。
1. 为什么需要知识图谱
1.1 信号 → 数据 → 信息 → 知识
| 层级 | 是什么 | 例子 |
|---|---|---|
| 信号 | 传感器测量的物理量,信息的物理载体 | 电流、电压、温度 |
| 数据 | 信号被存储/显示出来的内容 | 文本”226”、连续温度值 |
| 信息 | 数据 + 解释,带语义 | ”姚明身高 2.26 米” → “姚明很高” |
| 知识 | 被验证、正确、被相信的有价值信息 | ”中国的首都是北京” |
关键区分:
- 数据 = 字面量;
- 信息 = 理解后的数据;
- 知识 = 验证过的信息。
课件用 Jim Gray 所说的“第四范式”交代背景:科学研究在实验观察、理论建模和计算仿真之外,还可以从海量数据中挖掘规律。知识图谱不是否定数据驱动,而是把可复用的事实、概念和规则显式组织起来,与统计学习互补。
1.2 感知智能 vs 认知智能
- 深度学习擅长”感知”(看、听、识别);
- 知识是”认知”(理解、推理、决策)的燃料;
- 例:“特朗普住哪?“——纯 DL 答不出;引入”美国总统住白宫”这条常识即可推理。
1.3 知识驱动 vs 数据驱动
| 维度 | 知识驱动 | 数据驱动 |
|---|---|---|
| 依赖 | 预定义规则和逻辑 | 从数据中学模式 |
| 擅长 | 结构化、定义明确的任务 | 复杂、非结构化任务 |
| 代表 | 专家系统、规则系统、KG | 深度学习、大模型 |
大模型幻觉的根因之一是知识不全/不准;KG 给机器外挂结构化、可推理的知识库。
2. 知识图谱的定义
知识图谱是一种用有向图模型来描述知识和建模世界万物之间的关联关系的技术方法,由节点和边组成。
- 2012 年 Google 在搜索引擎中首次提出”Knowledge Graph”;
- 以图数据结构描述概念、实体及其关系,更接近人类认知形式。
3. 基本概念
3.1 三元组(KG 最基本单位)
知识图谱中的实体关系事实常记作 (头实体, 关系, 尾实体),即 (h, r, t)。RDF 三元组则写作 (Subject, Predicate, Object):
- Subject:被描述的资源;
- Predicate:关系或属性;
- Object:可以是另一个资源/实体,也可以是字符串、数值、日期等字面量(literal)。
因此,只有 Object 也是资源/实体时,才适合把 Subject 和 Object 对应为“头实体”和“尾实体”;属性事实的 Object 往往只是字面量。
例:
(北京航空航天大学, 成立于, 1952年)
(北京航空航天大学, 教职工人数, 4266)
(北京航空航天大学, 学生人数, 37000)
3.2 概念层与实例层
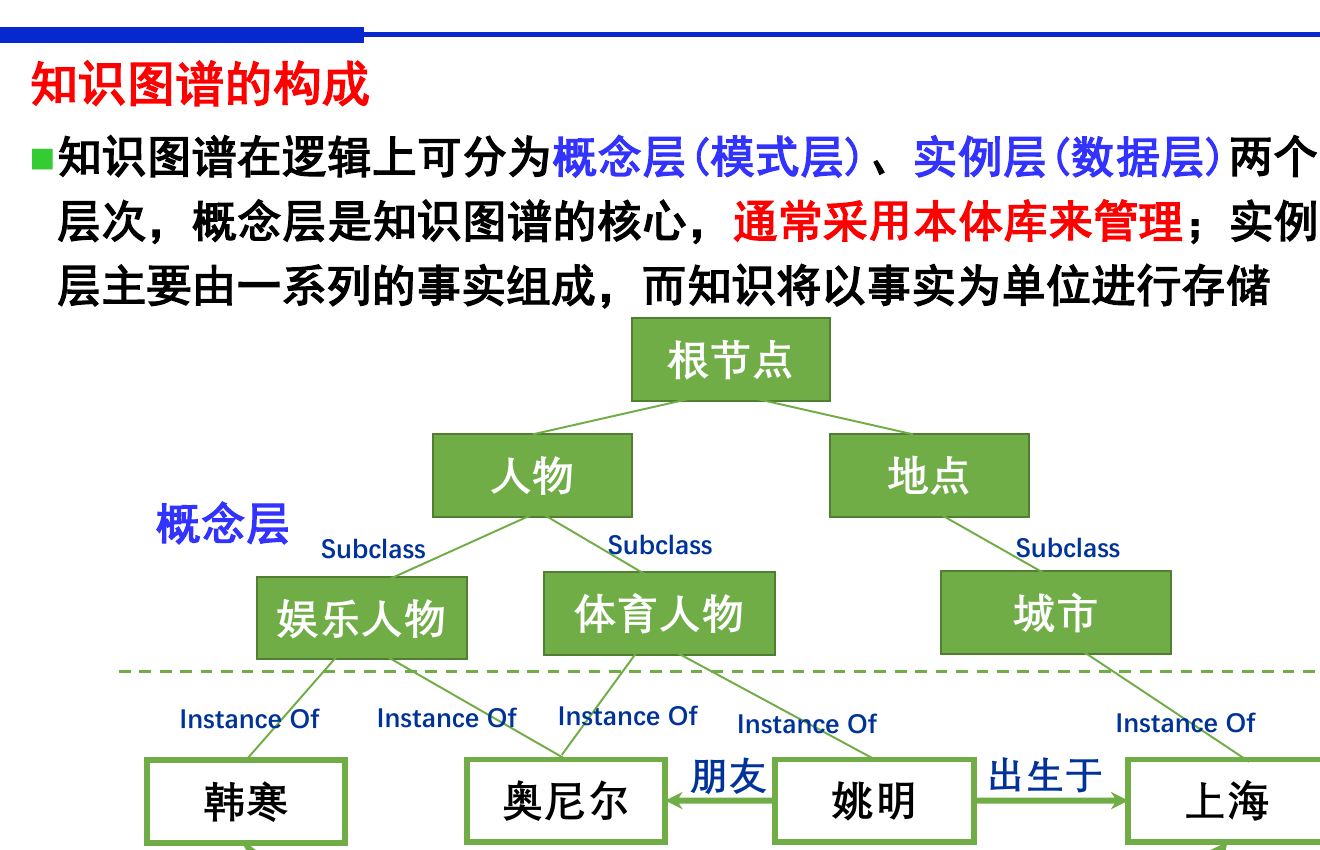
概念层规定有哪些类和关系,实例层保存具体实体与事实,type 把两层连起来。
| 层 | 内容 | 作用 | 例子 |
|---|---|---|---|
| 概念层 / 模式层 | 抽象的”类”、本体、本体间关系 | 定义 schema,约束实例 | 体育人物、娱乐人物、城市 |
| 实例层 / 数据层 | 真实实体 + 实体间关系 | 记录具体事实 | 姚明、韩寒、上海 |
连接关系:
- 概念层之间用 Subclass(体育人物 Subclass 人物);
- 概念↔实例用 Instance Of / Type(姚明 Type 体育人物);
- 实例之间用 Relation(姚明 出生于 上海)。
为什么要分两层:
- 概念层约束实例层,防”姚明属于水果”;
- 支持基于概念层次的推理(姚明属于体育人物,体育人物是人物的子类,因此姚明也属于人物);
- 本体可独立复用和扩展。
模式层不只是分类表,还是实例事实的语义约束。例如先声明“体育人物”是“人物”的子类,bornIn 的两端应是人物和地点,再存入“姚明出生于上海”。这样既能检查类型,也能沿 subClassOf 和 type 做继承推理。
3.3 节点的层次化表示
领域(Domain/Topic)    人物、自然、文化…
   └─ 概念(Concept)   体育人物、娱乐人物…
        └─ 实体(Entity/Instance)   姚明、韩寒…
3.4 节点类型
| 类型 | 含义 | 例子 |
|---|---|---|
| 实例(Instance) | 真实实体 | (姚明,出生地,上海市) |
| 字符串(String) | 文本值 | (北京大学,学术传统,兼容并包、思想自由) |
| 数值(Number) | 数字 | (北京市,面积,1.641万)、(姚明,身高,2.26米) |
| 时间(Date) | 日期 | (姚明,出生年份,1980年) |
3.5 边类型
| 类型 | 连接什么 | 例子 |
|---|---|---|
| Subclass(子类) | 本体之间 | (体育人物,Subclass,人物) |
| Type(类型) | 实体 ↔ 本体 | (姚明,Type,体育人物) |
| Relation(关系) | 实体之间 | (姚明,出生于,上海)、(姚明,朋友,奥尼尔) |
属性图中,实体间关系是边,标量属性是节点或边上的键值对;RDF 则统一用谓词表示关系和属性,简单属性的宾语可以直接是字面量。
4. 发展历史(6 个阶段)
| 阶段 | 时间 | 核心 | 关键人物/事件 |
|---|---|---|---|
| 专家系统(ES) | 1970s | 知识库 + 推理机,人工写规则 | MYCIN(医疗) |
| 本体(Ontology) | 1980 | 结构化术语集,概念间关系 | 哲学起源 → AI |
| 万维网(WWW) | 1989 | 文档靠超链接互联 | Tim Berners-Lee |
| 语义网(Semantic Web) | 1998 | 给网页加机器可读语义 | W3C 后续推进规范 |
| 链接数据(Linked Data) | 2006 | URI 标识万物 + RDF 互联 | 语义网落地 |
| 知识图谱 | 2012~ | Google 正式命名 KG | YAGO/DBpedia/Wikidata 等百花齐放 |
知识工程 vs 知识图谱
| 维度 | 知识工程 | 知识图谱 |
|---|---|---|
| 构建 | 人工 | 自动 + 众包 |
| 数据量 | 数万~数十万 | 数十亿~数百亿 |
| 表示 | 一阶逻辑/产生式/描述逻辑 | RDF/属性图/分布式表示 |
| 任务 | 逻辑推理 | 检索 + 推理,赋能搜索/问答/推荐 |
KG vs 传统知识库 vs 数据库
| 类型 | 主要任务 | 备注 |
|---|---|---|
| 数据库 | 数据处理 | 表结构、强 schema |
| 传统知识库 | 知识处理 | 重推理、量小 |
| 知识图谱 | 知识应用 | 量大、含语义、可推理、形式灵活 |
KG 不替代数据库,KG 是更高层的语义层。
5. 典型知识图谱
5.1 通用 KG vs 领域 KG
| 维度 | 通用 KG | 领域 KG |
|---|---|---|
| 知识来源 | Wikipedia/众包 | 行业/企业内部数据 |
| 规模化 | 渐进 | 快速大规模 |
| 表示 | 三元组事实型 | 复杂本体 + 规则 |
| 质量 | 开放域 + 容忍度 | 抽+人工审核、质量高 |
| 融合 | 提升质量 | 多源融合扩展 |
| 应用 | 搜索/问答 | 决策/业务管理(重推理) |
| 举例 | DBpedia、Yago、百度、谷歌 | 电商、医疗、金融、农业、安全 |
互补:通用提供基础 → 行业复用+加深 → 回流补充通用。
5.2 代表项目
| 名称 | 类别 | 核心特点 | 关键记忆点 |
|---|---|---|---|
| WordNet | 早期词典 | 1985 普林斯顿,按”词义”组织,词义簇 synset | 词义聚类 |
| ConceptNet | 常识 | MIT OMCS,多语言、开放常识 | 词-词关系多 |
| BabelNet | 跨语言 | YAGO 思路 + 多语言 Wiki + 机器翻译 | 最大多语言百科 |
| Wikidata | 众包 | 免费开放、多语言、机器可编辑、三元组 | 维基数据 |
| YAGO | 融合 | WordNet 词汇 + Wikipedia 分类 | WordNet+Wiki |
| DBpedia | 早期 | KG 版的 Wikipedia | 结构化抽取 Wiki |
| Freebase | 众包 | 开放共享、协同构建、链接数据库 | 众包先驱 |
| Schema.org | 词汇标准 | 本体,覆盖人/组织/地点/时间/医疗/商品 | 互联网本体标准 |
| NELL | 自动抽取 | 互联网挖掘自动抽三元组 | Never-Ending Learning |
| OpenKG | 中文社区 | 18 个领域中文 KG | 中文 KG 联盟 |
| cnSchema | 中文标准 | OpenKG 发起、中文本体标准 | 中文版 Schema.org |
| OpenBase.AI | 中文众包 | 类似 Wikidata,中文为主,机+人协同 | 中文 Wiki |
5.3 行业代表
- 阿里巴巴电商 KG:用户需求 ↔ 商品特性,提升搜索/推荐;
- 美团大脑:挖掘人-店家-商品关联,餐饮娱乐决策;
- AMiner(清华):学者-论文关联,KDD 2020 时间检验奖;
- 中医药 KG:医案抽取,临床知识;
- 天眼查:商业情报,挖掘公司/负责人隐式关系。
可以按各项目的来源和用途区分:WordNet-词典,ConceptNet-常识,Wikidata-众包,YAGO-多源融合,DBpedia-维基百科结构化,Freebase-众包先驱,NELL-自动抽取,OpenKG-中文开放联盟。
课件把搜索、问答和推荐作为三类典型应用:搜索从返回关键词相关网页,扩展到直接索引人物、机构和地点;问答把问题链接到实体和关系后查询或推理;推荐则可以沿演员、导演、类型等关系找候选。实际系统通常把图特征与协同过滤、排序模型结合,而不是用 KG 取代其他方法。
6. 技术流程(4 个关键问题)
6.1 整体架构
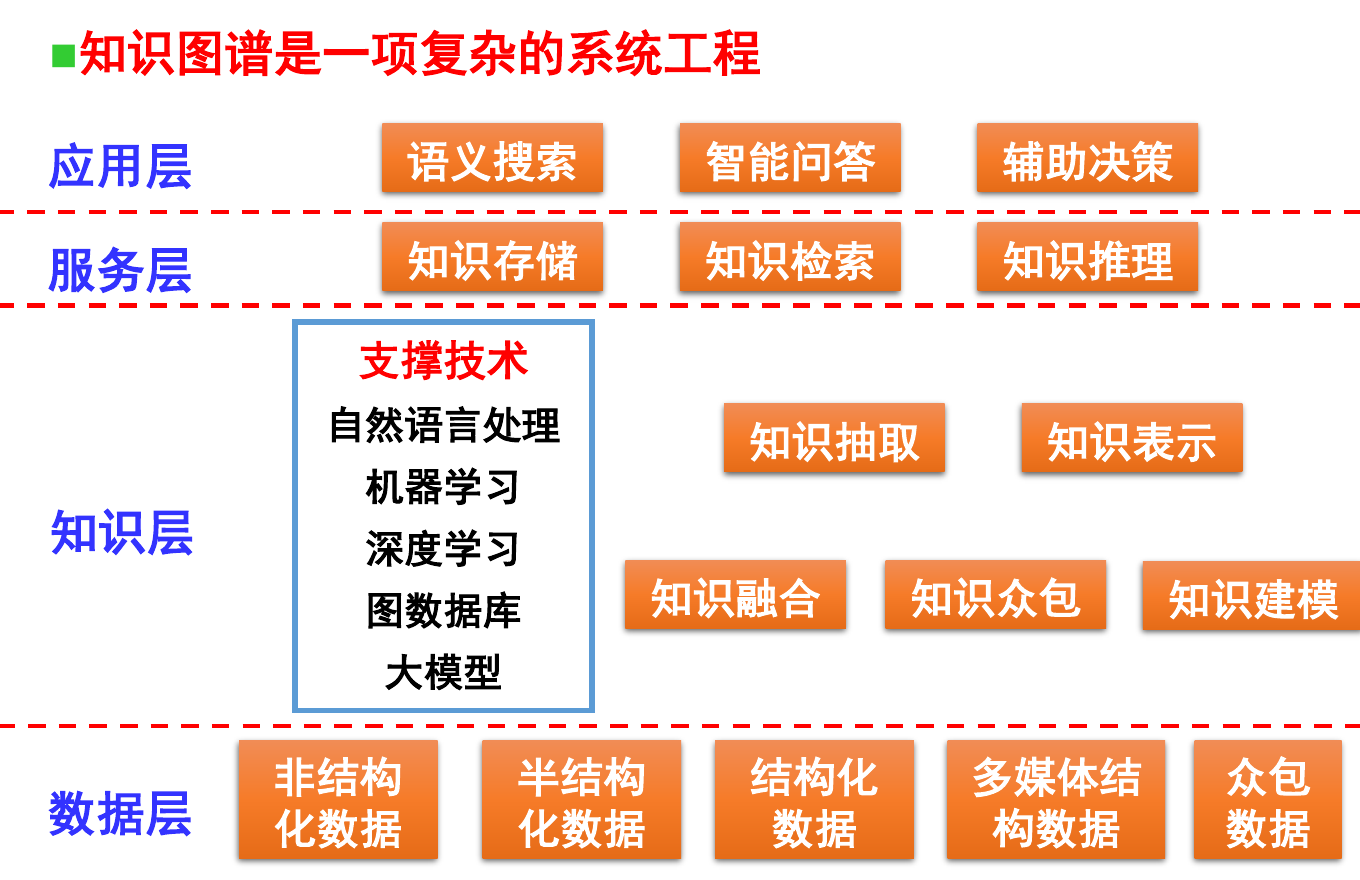
先定义语义,再抽取事实、融合指称,最后用存储和推理引擎提供服务。
应用层    语义搜索 / 智能问答 / 辅助决策
服务层    知识存储 / 知识检索 / 知识推理
支撑层    NLP / 知识抽取 / 知识表示 / ML / DL / 图数据库
         知识融合 / 知识众包 / 知识建模 / 大模型
数据层    非结构化 / 半结构 / 结构化 / 多媒体结构 / 众包
6.2 四个关键问题(4 个动词)
| 关键问题 | 解决什么 | 主流方法 |
|---|---|---|
| 知识表示 | 知识怎么”写”成机器能懂的符号 | RDF / 属性图 / OWL / 表示学习 |
| 知识抽取 | 怎么从数据里把知识挖出来 | 实体识别 / 关系抽取 / 事件抽取 |
| 知识融合 | 多源 KG 怎么合并成一个 | 实体对齐 / 消歧 / 共指 |
| 知识服务 | 怎么用知识 | 补全 / 推理 / 语义检索 / 问答 |
6.3 4 个问题展开
① 知识表示
- 本体:类集、属性集、关系集、词汇集;
- 实体:实体间关系 + 描述术语;
- 事件:实体关联 + 发生时间;
- 基本描述框架:W3C 的 RDF = 主谓宾三元组。
② 知识抽取
- 结构化数据 → D2R 工具:Triplify、D2RServer、OpenLink、SparqlMap、Ontop;
- 文本数据 → 实体识别 + 关系抽取;
- 关系抽取方法演进:特征模板 → 核函数监督 → 远程监督 → 联合抽取 → LLM。
③ 知识融合
- 模式层:新本体融入已有本体;
- 数据层:实体指称、属性、关系、类别融合;
- 实体消歧:同名实体不同含义(“苹果”公司 vs 水果);
- 共指消解:不同命名指同一实体(“北航” = “北京航空航天大学”)。
④ 知识服务
- 本体推理:基于描述逻辑,对概念/关系补全;
- 课件示例规则:
(X,出生于,Y) ∧ (Y,属于国家,Z) ⇒ (X,国籍,Z); - 在这条规则和“姚明出生于上海、上海属于国家中国”两个示例事实下,可推出“姚明国籍中国”;
- 这只是课件用来演示规则推理的例子,不是通用事实:现实中不能仅凭出生地确定国籍。
- 课件示例规则:
- 图结构推理:实体间路径 + 周围图结构预测关系;
- 表示学习推理:实体/关系嵌成向量,h + r ≈ t(TransE);
- 知识检索:语义搜索,给出精确答案 + 相关推荐;
- 辅助决策:KG 嵌入分析/推荐流程。
用课件的菜谱领域例子,四步可以连成一条线:
- 根据饮食领域和问答、检索等场景建立菜品、食材、步骤等本体;
- 从结构化、半结构化和非结构化数据中抽出实体、关系和属性;
- 对齐“土豆—马铃薯—洋芋”、“西红柿—番茄”等不同指称;
- 把融合后的知识交给存储、查询和推理引擎,用 SPARQL 等接口回答“酸辣土豆丝需要花椒吗”。
这个流程需要迭代:出现新数据或本体不足时,会回到表示、抽取和融合阶段。课件还给出一个最小规则推理:北航有 4266 名教职工和 37000 名学生,在“学校总人数 = 教职工数 + 学生数”规则下得到 。
6.4 知识存储两条路线
- 三元组库(Semantic Web 出身):存 RDF,代表 Apache Jena、OpenLink Virtuoso;
- 图数据库(数据库出身):存属性图,代表 Neo4j、JanusGraph、OrientDB;
- 核心区别:属性图让节点和边原生携带键值属性;RDF 的基本模型是三元组,陈述的时间、来源或置信度需要通过具体化、命名图或 RDF-star 等方式表示。
KG 不替代数据库:图模型规定如何组织语义,数据库系统仍负责索引、持久化、并发和查询执行。
7. 本讲结构
知识图谱概述
├── 为什么需要知识
│   ├── 信号→数据→信息→知识
│   ├── 感知 vs 认知
│   ├── 大模型幻觉根因
│   └── 知识驱动 vs 数据驱动
├── 基本概念
│   ├── 节点=实体/概念,边=关系/属性
│   ├── 三元组 (h, r, t)
│   ├── 概念层(Subclass/Type)+实例层(Relation)
│   ├── 节点类型:实例/字符串/数值/时间
│   └── 边类型:Subclass/Type/Relation
├── 发展历史
│   ├── 专家系统(70s)→本体→万维网→语义网
│   ├── →链接数据→KG(2012 Google)
│   └── KG vs 知识工程 vs 数据库
├── 典型项目
│   ├── 通用:WordNet/ConceptNet/YAGO/DBpedia/Wikidata/Freebase/NELL/BabelNet
│   ├── 中文:OpenKG/cnSchema/OpenBase
│   └── 领域:阿里电商/美团/AMiner/中医药/天眼查
└── 技术流程(4 关键问题)
    ├── 知识表示 → RDF/属性图/OWL
    ├── 知识抽取 → 实体/关系/事件
    ├── 知识融合 → 实体对齐/消歧/共指
    └── 知识服务 → 推理/检索/问答