大作业 · NaVILA 论文复现
项目任务
源目录保留了 NaVILA 实验报告 PPT 和演讲稿,没有一份独立的教师题面。根据实际提交,项目任务是复现 NaVILA 足式视觉语言导航的官方评估链路,并对开环、闭环和低比特量化设置进行比较;不是从零重新训练 NaVILA。
查看复现过程与实验结果
实际完成内容
- 配置独立的
navila-eval环境; - 安装 PyTorch、Habitat-Sim、Habitat-Lab、VLN-CE、NaVILA 和 Flash-Attention 等依赖;
- 准备 Matterport3D 场景与 R2R-VLNCE 任务配置;
- 下载基于 Llama-3-8B 的 8 帧预训练权重;
- 在 Habitat 中运行 R2R 评估,保存日志和视频;
- 在官方开环基线上,增加闭环控制和 4-bit 量化两组对比。
Habitat-Sim 负责三维场景渲染,Habitat-Lab 提供任务与智能体逻辑;Matterport3D 提供室内三维场景,R2R-VLNCE 则规定语言指令、起终点和评估 episode。
指标口径
| 指标 | 含义 | 趋势 |
|---|---|---|
| SR | 最终进入目标附近,并主动输出 stop 的比例 | 越高越好 |
| SPL | 同时衡量成功率与路径效率 | 越高越好 |
| OS | 过程中曾进入目标 3 m 范围的比例 | 越高越好 |
| NE | 最终位置到目标的直线距离 | 越低越好 |
| nDTW | 实际轨迹与人类参考轨迹的相似程度 | 越高越好 |
| 平均步数 | 高层模型下达中层动作的平均次数 | 效果相当时越少越好 |
SR 回答“最终是否完成”,OS 回答“是否曾经到过”,NE 回答“最后还差多远”,SPL 和 nDTW 则分别检查路径效率与指令遵循,不能只挑一个数字判断模型好坏。
三组实验结果
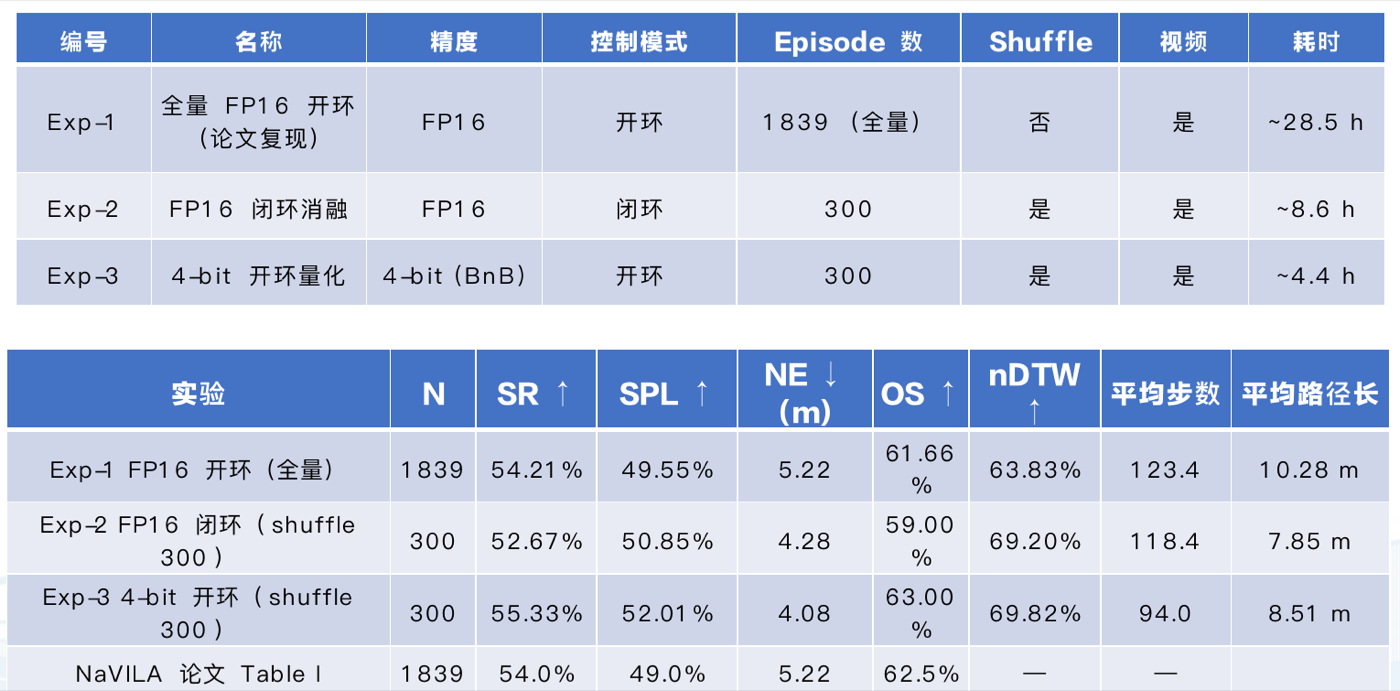
| 实验 | 数量 | SR | SPL | NE | OS | nDTW | 平均步数 | 平均路径长 | 耗时 |
|---|---|---|---|---|---|---|---|---|---|
| Exp-1:FP16 开环全量 | 1 839 | 54.21% | 49.55% | 5.22 m | 61.66% | 63.83% | 123.4 | 10.28 m | 约 28.5 h |
| Exp-2:FP16 闭环,shuffle | 300 | 52.67% | 50.85% | 4.28 m | 59.00% | 69.20% | 118.4 | 7.85 m | 约 8.6 h |
| Exp-3:4-bit 开环,shuffle | 300 | 55.33% | 52.01% | 4.08 m | 63.00% | 69.82% | 94.0 | 8.51 m | 约 4.4 h |
| 论文 Table I | 1 839 | 54.0% | 49.0% | 5.22 m | 62.5% | — | — | — | — |
Exp-1 的 SR、SPL、NE、OS 与论文 Table I 接近,说明当前代码、数据和配置基本跑通了官方评估链路。指标接近并不能单独证明环境与论文完全一致。
Exp-2 每次只执行一个 Habitat 步,随后重新观察和决策。相对全量开环基线,闭环组的 SPL、NE、nDTW 和平均路径更好,但 SR 略低。由于 Exp-2 只是 shuffle 后的 300 个 episode,而 Exp-1 是 1 839 个全量 episode,这些差异只能作为课程实验观察,不能直接当作严格的算法优劣结论。
Exp-3 使用 bitsandbytes NF4 运行时量化,只量化 LLM;SigLIP 视觉编码器和投影器仍为 FP16。这不是论文采用的 AWQ W4A16。300 个 episode 上没有观察到明显精度损失,并把运行显存降到约 7 GB,支持“低显存运行可行”,但不能据此声称 4-bit 比 FP16 更聪明。
完整架构和依赖排查见第十讲 · 实验课:NaVILA 复现与 VLA 小车部署。