第八讲 · 具身智能、VLA 与 SimLingo
对应 PPT:具身智能专题(前半)+ 第六讲《视觉-语言-动作模型 VLA》 我在这一讲把前面的符号、模糊、连接、行为和感知方法放进具身智能系统中,再介绍 VLA(视觉-语言-动作)模型。NaVILA 的完整复现和小车部署放在第十讲实验课。
1. 第一人称智能与 POMDP
1.1 第三人称 vs 第一人称智能
可以从第三人称与第一人称的差别理解具身智能:
| 第三人称智能 | 第一人称智能(具身) | |
|---|---|---|
| 核心问题 | 「这是什么?」(识别) | 「下一步该怎么做?」(决策) |
| 典型输入 | 静态图像、标签、语料 | 连续观测、历史状态、目标、约束 |
| 怎么认识「盒子」 | 有人告诉我「这是盒子」 | 亲身体验——可以打开、可以装东西 |
| 优势 / 局限 | 语义强、数据丰富 / 缺动作后果 | 决策考虑身体、时间、风险、反馈 |
著名的 1963 年「两只猫」实验:两只小猫绑在同一转盘装置上看同样画面,主动猫能自己走动(视觉变化由自己行为引起),被动猫只能被带着走。结果主动猫学会正常行走,被动猫却失去了视觉引导行走能力。这个实验说明,视觉经验需要与自身动作产生的反馈联系起来。ChatGPT 是典型的「第三人称智能」(Sutton 批评它「与你互动时完全不会学习」),具身智能则强调第一人称交互。
1.2 POMDP
具身智能通常被表述为 POMDP(部分可观测马尔可夫决策过程)。为什么是「部分可观测」而非普通 MDP?因为这是具身的根本约束:机器人的摄像头只能看到局部,真实世界的完整状态永远看不全。MDP 看完整状态 ,具身只能看观测 ,真实 藏在背后。
POMDP 用七元组 定义: 真实状态(不可完全观测)、 动作(离散 / 连续)、 观测(相机 / 深度 / 触觉 / 语言指令)、 转移(身体与环境耦合的动力学)、 观测概率函数、 奖励(成功 / 碰撞 / 能耗 / 安全多目标加权)、 折扣。目标同 RL:。
具身场景下的四个难点:① 部分可观测(目标可能暂时不可见);② 接触不确定(摩擦 / 形变 / 遮挡 / 延迟放大误差);③ 长时程依赖(当前动作影响数十步后);④ 跨 embodiment 泛化(换相机 / 夹爪 / 底盘策略还能用吗)。
1.3 具身智能的能力栈
| 层 | 干什么 | 对应本课 |
|---|---|---|
| 目标与约束 | 语言指令、成功判据、安全边界 | VLA 的 Language |
| 感知与表征 | RGB-D / 触觉 / 力觉 / 场景图 | 第七讲光流、视觉编码 |
| 记忆与世界模型 | 时序记忆、对象持久化、地图先验 | 第五讲 RNN/LSTM/Transformer |
| 规划与推理 | 任务分解、因果判断、长时程搜索 | 符号主义 + LLM |
| 技能与策略 | 导航、抓取、操作、全身运动控制 | 第六讲 RL/ILC |
| 控制与执行 | 轨迹跟踪、阻抗控制、急停 | 传统控制 + 神经网络控制 |
在这张表里,具身智能不是单独一种算法,而是由感知、记忆、规划、策略和控制等模块组成的系统。
2. 从模块化到端到端:自动驾驶范式变革
课件以自动驾驶引出 VLA,先列出自动驾驶分级 L0–L5:
| 级别 | 名称 | 动态驾驶任务 DDT | 失效接管与运行范围 |
|---|---|---|---|
| L0 | 无驾驶自动化 | 驾驶员完成横向和纵向控制,系统最多提供警告或瞬时辅助 | 驾驶员负责接管 |
| L1 | 驾驶辅助 | 系统持续执行横向或纵向控制中的一项,驾驶员完成其余部分并监控环境 | 驾驶员负责接管 |
| L2 | 部分驾驶自动化 | 系统同时执行横向和纵向控制,驾驶员仍需持续监控 | 驾驶员负责接管 |
| L3 | 有条件驾驶自动化 | 系统在 ODD 内完成 DDT | 接到请求时,由接管准备用户接管 |
| L4 | 高度驾驶自动化 | 系统在限定 ODD 内完成 DDT | 系统在 ODD 内完成失效处置 |
| L5 | 完全驾驶自动化 | 系统在所有可驾驶道路条件下完成 DDT | 系统完成失效处置,不受限定 ODD 约束 |
SAE J3016 的 L0–L5 主要描述动态驾驶任务与失效接管的分工。L2 / L3 的变化在于环境监控与接管机制,不直接等于法律责任转移;事故责任仍取决于司法辖区、产品设计和实际使用状态。
传统四段式技术栈:感知 → 预测 → 规划 → 控制。它有三个局限:① 模块串联会造成链式误差传递,后续模块很难修正前面模块的误判;② 依赖人工规则,长尾场景难以穷举;③ 面对 OOD 场景时泛化不足。
端到端方法:用统一神经网络把原始传感器数据直接映射到动作,减少人工设计的中间接口。它可以减少信息损耗并简化架构,VLA 则在视觉输入之外继续加入语言指令。
3. VLA:视觉-语言-动作模型
VLA(Vision-Language-Action):融合视觉、语言、动作的统一智能模型,从感知到决策端到端学习。三个词:Vision(基础输入,摄像头图像)、Language(关键高层输入,解析指令 / 目标)、Action(最终输出,转向 / 加速控制)。核心思想:用语言指导视觉理解,直接输出动作——区别于普通端到端(图像→动作),VLA 多了语言这个高层指导信号。
语言输入的作用:① 提供任务目标(「直行」「左转」,避免无意义探索);② 提供抽象语义(「前方施工绕行」「小心行人」);③ 通过更换指令适应不同任务。它把人类意图转换成模型可处理的条件信息。
课件把整体画成四层、五个功能部件:① 输入层接收图像和文本指令;② 编码层里,视觉编码器把图像变成视觉 Token,语言编码器把指令变成语言 Token;③ 融合层用 Cross-Attention 交互视觉和语言信息;④ 输出层 / 动作头预测动作。按功能部件数,就是输入、视觉编码、语言编码、融合、输出五块。
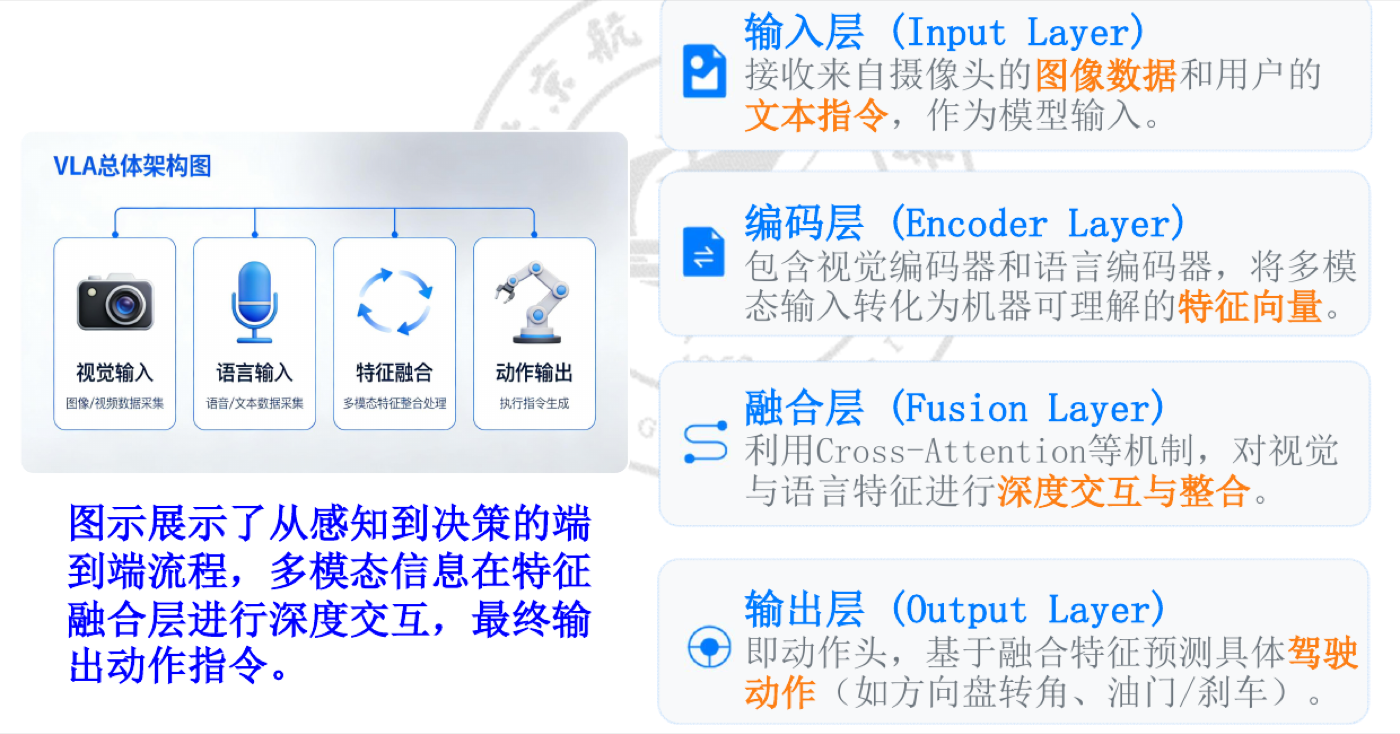
关键技术:
- 视觉编码器:主流 ViT(图像切 Patch、线性投影 + 位置编码、送 Transformer 自注意力,即第五讲 Transformer 的应用,「词」换成「图像块」);还有 SigLIP。
- 语言编码器(LLM Backbone):Llama / Vicuna 等 LLM 当「大脑」,理解指令 + 常识推理。
- Cross-Attention 融合:用第五讲的 Q/K/V,让语言特征作为 Query 读取视觉特征图中的相关区域。例如指令「红色的车」会使注意力更多分配到对应视觉区域。融合后,视觉 Token 与语言 Token 组成统一序列,再由 Transformer 解码器生成动作。
动作头(连续 vs 离散):连续头 = MLP 回归直接输出连续控制量(方向盘 / 油门,精确平滑);离散头 = MLP + Softmax 从预定义集合选(直行 / 左转,可解释、易与规则系统结合)。
两种训练方式:行为克隆用人类「图像-指令-动作」三元组做监督学习,实现简单,但受演示数据覆盖范围限制;强化学习通过环境交互和奖励优化策略,但训练成本、稳定性和安全约束更复杂。课件将现状概括为以行为克隆为主、强化学习辅助。
4. 典型 VLA 模型
时间线 RT-1(2022) → RT-2(2023) → OpenVLA(2024) → Pi0(2024):
- RT-2(Google DeepMind):先利用互联网文本与图像数据获得视觉语言知识,再把这部分数据与机器人示范轨迹联合训练,将动作表示成可由语言模型预测的 token。互联网预训练有助于处理未见物体和新任务,但机器人动作并不是只靠互联网数据学出来的。
- OpenVLA(2024):开源 VLA(预训练模型 + 训练代码 + 评估基准),降门槛、促协同。
- Pi0(Physical Intelligence):面向多种机器人平台的通用 VLA 基础模型。它不是时间线上首个 VLA,但特点是用混合专家(MoE)Transformer 架构 + 流匹配(Flow Matching) 生成平滑连续动作。
- Pi0.5:处理 Pi0 的「知识干扰」(动作模块梯度反传破坏 VLM 预训练知识)。课件列出三项改动:① 用梯度截断隔离知识;② 先预测高层子任务,再生成低层动作;③ 使用异构数据协同训练。课件给出的效率对比是比 Pi0 快 7.5 倍,关注点是在端到端训练动作的同时保留语言和常识能力。
5. VLA 在自动驾驶 + SimLingo 实战
VLA 的位置:① 替代规划模块(感知 → VLA → 控制);② 替代整个端到端(原始数据 + 语言指令 → VLA → 控制动作)。输入:多摄像头 360° + BEV 鸟瞰图(多视角转统一鸟瞰视角、增强空间理解)+ 多样文本任务。输出:直接控制量(高效但风险高)/ 轨迹预测(未来位置点序列,易集成、可解释、安全)。
SimLingo(CVPR 2025 Spotlight、CARLA Challenge 2024 冠军):纯视觉闭环自动驾驶(仅摄像头、无 LiDAR/Radar)、1B 参数。架构 InternViT-300M + Qwen2-0.5B → 路径路点(横向)+ 速度路点(纵向),LoRA 微调(只训练 2.72% 参数)。三任务协同:驾驶(输出路点)+ Commentary(自然语言描述驾驶行为、提可解释性)+ VQA(场景问答、增强语义)。
**Action Dreaming(语言-动作对齐)**用于缓解语言描述与实际动作不一致的问题:合成多样化指令 → 为每条指令生成对应理想轨迹 → 联合训练两者 → 用指令跟随成功率验证。课件给出的结果是,指令跟随成功率从 28.2% 提升到 72.9%。轨迹指标包括 ADE(平均位移误差)和 FDE(终点位移误差);开环评估在离线数据集上比对,闭环评估则让车辆在 CARLA 中根据预测继续行驶。
5.1 课件复现:离线开环评估
课件给出的复现链路是:克隆 SimLingo 与 setup_carla 仓库,建立 Conda 环境并应用项目补丁,下载模型权重与约 3.2 GB 的单段验证数据,再用软链接把数据放到程序约定的位置。这里做的是开环评估:模型逐帧预测未来轨迹,再与数据集里的真实轨迹比较,车辆并没有在 CARLA 中因预测结果继续行驶。
课件对闭环硬件需求有两处不同口径:一页写“至少 16 GB 显存”,下一页又写“12 GB 显存 + CARLA”。这两条在课件内部冲突,只能把它们视为不同配置或未统一的记录,不能据此承诺一个确定的最低显存门槛。
课件展示的一组 160 帧结果为:
| 指标 | 均值 | 中位数 | 标准差 | P90 |
|---|---|---|---|---|
| ADE | 0.0618 m | 0.0364 m | 0.0809 m | 课件未列出 |
| FDE | 0.1699 m | 0.0720 m | 0.3134 m | 3.07 m |
不过这组 FDE 数字本身不自洽:FDE 是非负量;若 P90 真为 3.07 m,就意味着至少约 10% 的样本不小于 3.07 m,仅这部分对均值的贡献就至少约 0.307 m,不可能同时得到 0.1699 m 的均值。因此 3.07 m 这项应视为课件待核的统计或排版记录,不要拿它和其他实验做定量结论。
雨天路口案例里,模型生成的语义描述与预测轨迹方向一致。这个单个定性样例只能说明两项输出在该场景下没有明显矛盾,不能据此证明模型已经普遍完成语言—动作对齐。预测也没有体现湿滑路面的制动距离和打滑风险,实际闭环系统仍需车辆动力学与安全约束。
本地大作业目录还保留了另一份 105 帧开环汇总图:ADE 均值 0.0428 m、中位数 0.0166 m、标准差 0.1009 m、P90 0.0985 m;FDE 均值 0.1322 m、中位数 0.0339 m、标准差 0.4634 m、P90 0.2883 m。它是另一份数据导出的独立产物,不能和课件的 160 帧结果拼成同一组,也不能据此声称已完成真实车辆或 CARLA 闭环验证。
6. NaVILA:足式视觉语言导航(实验课)
实验课介绍的 NaVILA(机器人顶会 RSS 收录)是一套面向四足 / 人形等足式机器人的端到端**视觉语言导航(VLN)**系统。
NaVILA 将高层视觉语言理解与底层运动控制解耦:高层 VLA 模型 VILA 处理单视角图像和语言指令,生成自然语言形式的路径点指令(如「向前走 2 米然后左转」);底层运动策略再把路径点转换成关节运动。它对应能力栈中「规划推理」与「控制执行」的分层。
VILA 三模块:视觉编码器(图像 → 视觉词元)+ 投影层(下采样、映射到语言空间)+ LLM(视觉词元和文本词元一起自回归生成)。处理视频时按固定间隔均匀采样帧,借序列并行训练最多支持 1024 帧。
训练数据:以 YouTube 上 2000 条第一人称巡游视频为起点,用熵采样处理成 20000 条导航轨迹;用 MASt3R 算法估计相机位姿提取分步动作,用 VLM 生成字幕、再由 LLM 重述,为每条轨迹生成自然语言导航指令。
课件列出的特点包括:① 从人类日常巡游视频学习高层导航能力;② 高层自然语言路径点接口可以跨机体复用;③ 展示了强光、透明障碍物等困难场景下的导航结果。这里的跨机体复用不等于整套系统零适配:底层运动策略仍需匹配新机器人的运动学、动力学、传感器与动作空间。
实验技术细节:仿真用 Habitat-Sim(渲染)+ Habitat-Lab(任务逻辑),3D 场景用 Matterport3D(MP3D),导航任务用 R2R_VLNCE 数据集,模型权重基于 Llama-3-8B。在当时 NaVILA/VILA 集成的 transformers 版本与输入管线中,默认路径按单图处理;项目补丁扩展了多帧输入与注意力相关实现,用于连续 8 帧的视频画面。这不是说 transformers 库本身普遍只能处理单图。
7. 与前面内容的关系
可以把前面的内容放进同一条系统链路:
控制问题要让系统在不确定环境里达成目标。符号主义用规则表示经验,模糊逻辑用隶属度处理模糊概念,连接主义从数据中学习映射,ILC 和强化学习利用反馈改进动作,光流提供运动感知。具身智能和 VLA 把这些能力组织到同一个系统中,并通过高层决策与底层运动控制完成任务。因此,具身智能可以看作一个广义控制问题。
下一讲:智能系统的安全与伦理;第十讲再进入 NaVILA 复现与 VLA 小车部署。