第九讲 · 智能系统安全与伦理
对应 PPT:安全专题 前八讲讨论了具身智能体怎样感知、决策和行动。我在这一讲换一个角度:当这些能力进入自动驾驶等真实系统后,需要怎样识别、评估和约束风险。
背景:智能算法的系统性风险来源多、难预测、难监管,包括基础安全技术缺陷、智能硬件漏洞和 AI 供应链复杂性。开源框架同样可能存在风险,例如课件列出 2020 年 360 公司披露的 TensorFlow 24 个安全漏洞。
1. 从 AI 全栈看系统性风险
课件先用华为 AI 全栈说明:一个智能系统不是“只有模型”,而是从应用一直延伸到芯片的完整链条。
| 层级 | 课件中的代表 | 主要职责 |
|---|---|---|
| 应用使能 | HiAI、ModelArts、预集成方案 | 向业务提供服务、API 与开发流程 |
| AI 框架 | MindSpore,也可使用 TensorFlow、PyTorch、PaddlePaddle | 表达计算图,完成训练、推理与端边云协同 |
| 芯片使能 | CANN | 提供算子库、算子开发与调度能力 |
| AI 芯片 | 终端、Ascend Mini、Ascend Max | 在端、边、云执行实际计算 |
MindSpore 在框架层提供统一 API、自动微分、自动并行、自动调优和计算图表达,并面向 Ascend、GPU、CPU 适配端—边—云部署。分层带来了开发效率,也扩大了攻击面:框架漏洞、第三方代码、模型文件、算子库、设备运行时和接口链路,任何一层出问题都可能传导到最终动作。
1.1 Ascend 310 推理 SoC
课件以面向推理的 Ascend 310 为例拆开芯片内部:
- AI Core 执行矩阵、向量和标量等计算密集算子;
- AI CPU 执行不适合放在 AI Core 上的复杂算子;
- Control CPU 负责芯片整体运行,任务调度器 TS 负责向 AI Core 分配任务;
- DVPP 负责图像、视频解码和格式、精度等预处理;
- 片上 Buffer、L2 Cache 与外部 DDR 为计算提供分层存储;
- PCIe、网口、USB、GPIO、UART、I2C、SPI 等接口连接主机、传感器与执行设备。
因此,“模型被攻击”只是安全问题的一部分。视觉预处理错误会改变模型输入,任务调度或算子实现错误会改变推理过程,接口与内存漏洞则可能泄露数据或让结果被篡改。
1.2 一次物体识别推理怎样流动
课件给出的 Ascend 310 物体识别链路可以压缩成三段:
- 采集与预处理:摄像头的压缩视频流经 PCIe 进入 DDR;DVPP 读取、解码和预处理,再把图像帧写回 DDR。
- 推理:任务调度器 TS 指挥 DMA 把数据和权重预加载到片上 Buffer,配置 AI Core 执行;AI Core 读取特征图与权重并写回中间结果。
- 输出:AI Core 完成后通知 TS;若还有任务则继续调度,最后由 TS 把识别结果报告给 Host。
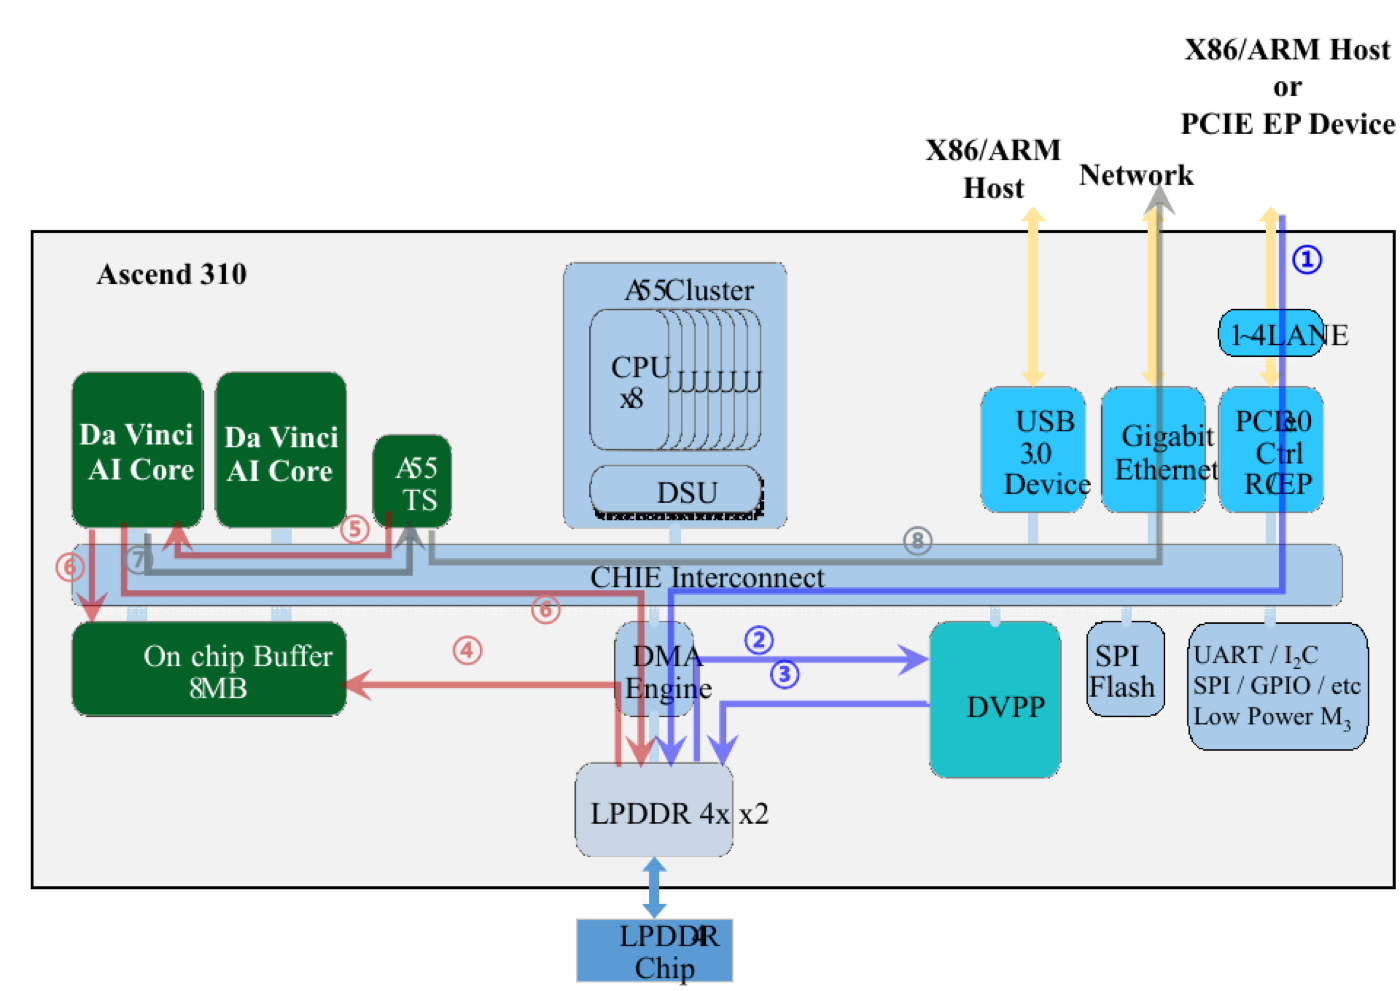
沿这条数据流,风险边界也变得具体:输入可能被对抗扰动,模型在存储、管理和共享时可能被窃取或植入后门,框架与算子可能存在供应链漏洞,设备和通信接口也可能遭到攻击。再叠加具体行业知识后,系统同时形成技术与专业领域壁垒,监管很难只检查一个“模型准确率”就判断它是否安全。
1.3 从政策、标准到工具
安全不能只靠模型开发者“自觉”。课件把治理生态分成政策法规、标准组织和评测工具三层。课件时间线里有几处把讨论、政治协议和正式法规混在了一起,校正后应这样理解:
- 欧盟机器人民事法律议会决议通过于 2017 年,2016 年是委员会阶段;EU AI Act 在 2023 年达成政治协议、2024 年正式生效,2025 年通用人工智能行为准则则是帮助合规的自愿工具;
- 美国 2019 年的是 American AI Initiative;AI 权利法案蓝图发布于 2022 年 10 月;2025 年 Transparency in Frontier Artificial Intelligence Act 是加州 SB 53,不能写成美国联邦法;
- 中国路线列出 2017 年《新一代人工智能发展规划》、2023 年《生成式人工智能服务管理暂行办法》和 2025 年智能社会发展与治理标准化相关指南;
- 标准化工作还包括 ISO/IEC 的 AI 安全与治理标准体系,以及课件列出的 2019 年中国人工智能学会 AI 与安全专委会、2023 年《人工智能安全标准化白皮书》等组织与成果。
治理最终还要落实为能执行的工具:ART 提供对抗攻击与防御算法,Foolbox 用统一接口测试模型鲁棒性,AdvBox 面向多框架生成和评测对抗样本,启智·重明则把数据、算法和系统安全评测组织成平台。政策规定“应当安全”,标准规定“按什么口径量”,工具负责“实际怎样测”。
2. 全局框架:安全风险的「冰山模型」
课件用一座冰山组织 AI 安全风险:
- 内生风险(水下,内在机理):源于 AI 算法自身的缺陷,通常不易直接察觉。三方面:鲁棒性、隐私性、透明性。
- 衍生风险(水上,生成内容):AI 在应用中对外部社会造成的影响,浮在水面看得见。三方面:公平性、有害性、可靠性。
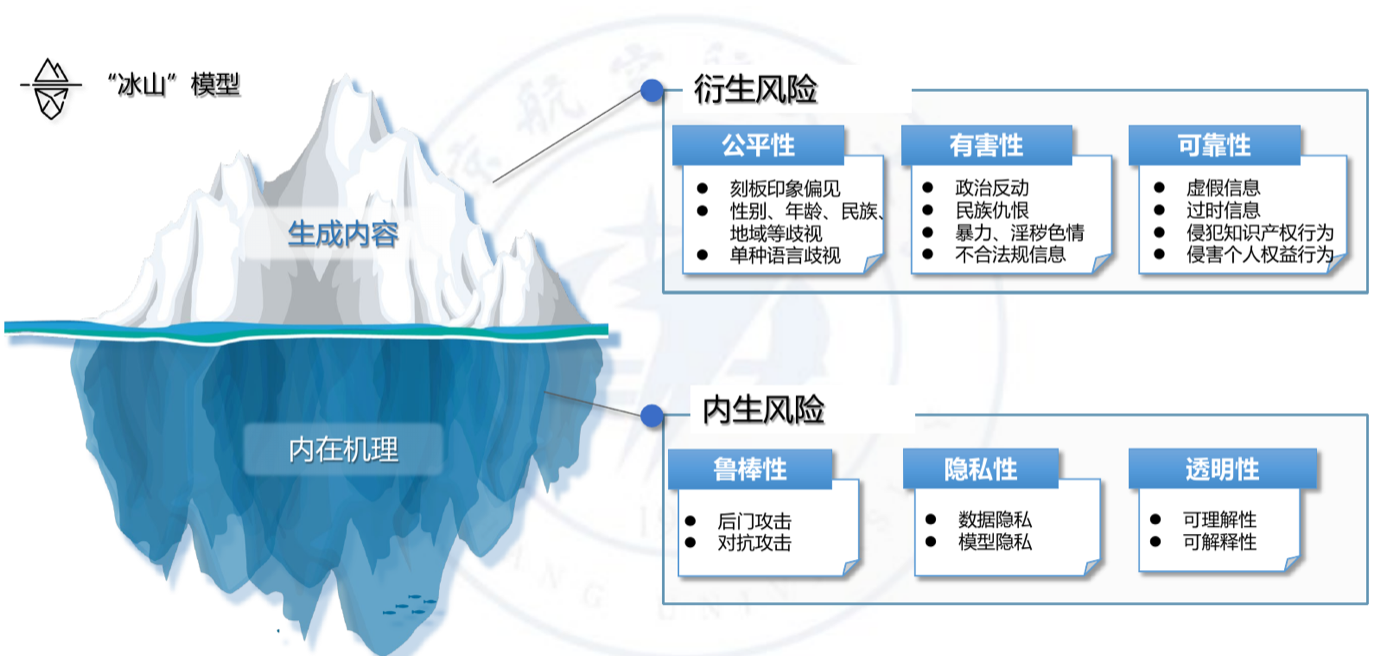
简化来看,内生风险关注模型机理,衍生风险关注模型应用后对社会产生的影响。
3. 衍生风险(水上):对社会的影响
① 公平性风险:因模型偏差或滥用,对特定群体产生歧视性决策。例:AI 把非白人种族与负面形象关联;Waymo 身份验证系统仅因医生名字「听起来像中东名字」就把他误识别为恐怖分子;大数据杀熟。根源往往是训练数据本身带偏见。
② 有害性风险:模型生成恶意或违背伦理的内容。课件列出聊天机器人对自杀倾向作出危险回应的案例,以及 DeepFake(深度伪造) 在假视频、电信诈骗、伪造医学影像和战争图片中的滥用。这类技术不只是生成错误内容,还可能被用来伪造证据和操纵舆论。
③ 可靠性风险:模型生成难以信任的内容。三种表现是:错误 / 虚假输出,例如大模型幻觉产生不存在的参考文献;输出不一致,即与上下文或自身结论矛盾;谄媚性输出(Sycophancy),即为了迎合用户而放弃更可靠的判断。课件还用一次自动化操作导致 AWS 服务长时间中断的案例说明,扩大模型自主权限前必须增加验证和回退机制。
4. 内生风险(水下):模型自身的机理缺陷
下面分别讨论鲁棒性、隐私性和透明性。
4.1 鲁棒性与对抗样本
鲁棒性风险:模型面对输入噪声、扰动或非理想环境时无法保持性能,例如雾天图像可能影响行人识别,对抗补丁也可能使目标漏检。其中一类典型问题是对抗攻击 / 对抗样本(Adversarial Examples)。
对抗样本是在原始输入上加入精心设计的扰动,使模型改变预测结果。Szegedy 等人在 2013 年系统报告了神经网络的对抗样本现象;课件里的「熊猫 + 微小扰动 → 长臂猿」示意图来自 Goodfellow、Shlens 与 Szegedy 后续的工作。以无目标攻击为例,设 是原始样本 的正确类别,并假设模型原本将 判为 ,要寻找扰动 使
也就是在扰动预算内让模型改变分类。研究中还观察到一些对抗样本可以跨模型迁移,说明问题不只发生在单个固定模型上;但攻击是否成功取决于模型、数据、攻击预算与威胁模型,不能据此断言所有 DNN 输入都一定可被同一种方式攻击。
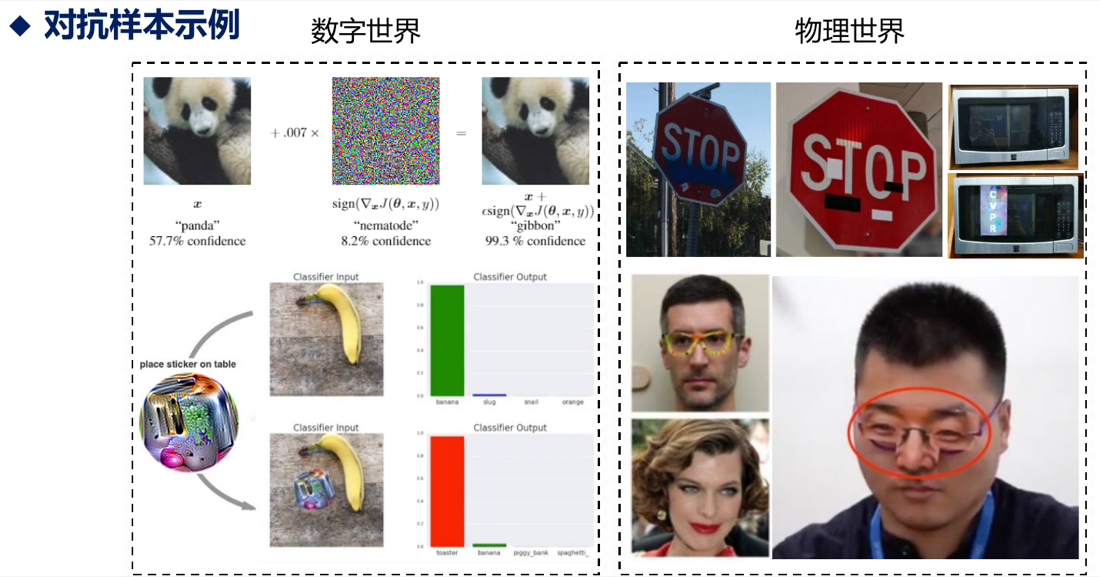
课件把数字 / 物理和白盒 / 黑盒放在同一张表里,但它们其实是两个独立维度:
| 维度 | 类别 | 含义 |
|---|---|---|
| 实施域 | 数字攻击 | 直接修改输入数组中的像素或特征 |
| 实施域 | 物理攻击 | 用打印、贴纸、三维物体或光投影影响真实传感器 |
| 攻击者知识 | 白盒攻击 | 已知模型结构、参数或梯度 |
| 攻击者知识 | 黑盒攻击 | 只能查询模型,或利用代理模型与迁移性 |
因此,数字攻击和物理攻击都可能采用白盒或黑盒设定。物理攻击还要额外承受拍摄、光照、视角、距离和自然噪声带来的变换。
物理世界对抗样本须在真实拍摄、光照和角度变化下生效,分为二维打印图案或贴纸、三维打印物体或对抗性眼镜框,以及对抗光投影。课件列出的案例包括路牌和车辆上的对抗补丁,使视觉模型无法正常识别目标。这类攻击会直接影响自动驾驶等依赖视觉输入的系统。除对抗样本外,还有数据投毒、模型后门、模型窃取和框架攻击等手段。
4.2 隐私性 + 三类隐私攻击
隐私性风险:模型在训练、部署、使用中泄露隐私,包括训练数据隐私和模型本身隐私。例:早期 GPT-2 被恶意前缀诱导后可能输出训练数据里的真实姓名、邮箱、手机号。课件列出三类经典攻击:
- 成员推断攻击(Membership Inference):给定一条记录和对模型的黑盒访问,判断这条记录是否在训练集里——能推断「某人病历是否被用于训练某医疗模型」。
- 模型反演攻击(Model Inversion):给定模型和辅助信息,反向恢复输入的机密信息——从人脸识别模型反推还原训练用的人脸。
- 模型窃取攻击(Model Stealing):无任何先验知识,只靠公开 API 黑盒访问,就复制出一个高相似的模型——偷走别人花大价钱训练的模型。
4.3 透明性 / 可解释性
可解释性风险:人类难以理解模型为什么做出某个决策(黑盒)。例:一个医疗诊断 AI 给出「季节性感冒」却说不出为什么,医生不敢信。可解释性是 AI 在医疗、自动驾驶等高风险领域落地的信任前提。可解释性方法:特征重要性、SHAP(算每个特征对预测的贡献)、热力图 / 激活图 / 注意力机制(看模型在「看」图像哪块区域)、可视化。
CNN 的纹理偏置:部分在 ImageNet 上训练的 CNN 更偏向利用纹理而不是形状,例如把「猫形状 + 大象纹理」的合成图判成大象。后续研究也指出,偏置强弱会随训练数据和训练方法变化。纹理偏置可能帮助解释某些分布变化下的失效模式,但不能直接推出它就是对抗样本的成因,更不能据此判断 CNN 普遍不可靠。
5. 防范 + 评估
防范技术(多层次体系):① 基于数据(提升训练数据质量、从源头增强鲁棒);② 基于模型(改进推理 / 结合外部参考补局限);③ 基于训练策略(调整训练目标确保输出与人类期望对齐,即大模型 RLHF 对齐思路,呼应第六讲 PPO)。
鲁棒性不能只看“加一点噪声后准确率掉了多少”,课件给出几种可计算视角:
-
最差决策边界距离:求使预测发生改变的最小扰动
越小,样本离错误决策越近;
-
-噪声敏感度:限制 ,统计预测翻转率或输出变化,观察模型对给定强度噪声有多敏感;
-
神经元敏感度:比较扰动前后内部神经元激活的变化,定位模型里最容易被扰动放大的环节;
-
综合鲁棒性框架:同时覆盖决策边界、内部神经元和最终输出,并在多种攻击、自然噪声和物理扰动下交叉测试。
单个指标只照亮一个切面。完整基准还应同时考察功能性、可靠性、效率和可维护性,避免一个模型“对抗准确率很高”,却因推理太慢、运行不稳定或无法持续维护而不适合真实系统。
评估体系(全周期):量化评测「一个 AI 到底安不安全」。从数据 / 模型、离线 / 在线、动态 / 静态、微观 / 宏观多维度,覆盖训练阶段(数据集评测)→ 验证阶段(算法评测)→ 测试阶段(功能 / 性能 / 安全测试)。北航参与的具体平台是启智·重明(AISafety) 深度学习安全评测平台(「重明鸟」取自神话神鸟,双瞳、能避灾害,寓意火眼金睛识别 AI 安全隐患)。
6. AI 的「电车难题」
课件最后留下一个开放的伦理问题——AI 的电车难题。经典电车难题里,一辆失控电车冲向 5 个人,你可以扳道岔让它转向另一条只有 1 个人的轨道。放到自动驾驶上,对应的是:事故不可避免时,系统该如何权衡车内乘客与车外行人的安全? 这里至少涉及两个问题:
- AI 应该如何解决道德困境——道德能不能、该不该被编码进算法?由谁来定?
- AI 的安全性和任务能力之间如何平衡——更安全往往意味着更保守、能力受限;如何在「能干活」和「不闯祸」之间取舍?
这两个问题没有统一答案,但系统设计者必须明确责任边界、价值取舍与可审计机制。
7. 本讲小结
AI 安全 = 系统链路 + 冰山模型
  系统链路:应用 / 框架 / CANN / 芯片,风险可在任一层进入并向下游传导
  水下 内生风险(机理缺陷的根子):鲁棒性 / 隐私性 / 透明性
    └ 对抗样本:在扰动预算内改变预测,可跨模型迁移,也可在物理世界实施
    └ 隐私三攻击:成员推断 / 模型反演 / 模型窃取
  水上 衍生风险(对社会的危害):公平性 / 有害性 / 可靠性
    └ DeepFake、大模型幻觉、谄媚性输出
  治理:政策法规 / 标准体系 / ART、Foolbox、AdvBox、重明等工具
  防范:数据 / 模型 / 训练策略三层 + 可计算鲁棒指标 + 全周期评测
  伦理问题:自动驾驶中的电车难题
这部分补充了智能系统从模型到硬件、供应链和社会影响的风险边界。下一讲进入实验课,记录 NaVILA 复现与 VLA 小车部署方案。