第七讲 · 感知基础:光流
对应 PPT:光流专题 前六讲都在讨论「怎样决策、怎样控制」,但有个前提一直被默认:机器人得先看懂环境在怎么动。光流(Optical Flow) 是 OODA 闭环里「感知」一环的核心工具,也是下一讲视觉导航的基础。
1. 光流是什么
定义:光流是空间运动物体在观察成像平面上、像素运动的瞬时速度。某个真实物体在动,它在画面上对应的像素会从这一帧的位置挪到下一帧,光流就是描述「每个像素朝哪个方向、移动多快」的速度场。
对二维平面,任一点的光流是一个矢量 ,叫光流矢量: = 水平方向速度分量, = 垂直方向速度分量。直觉:坐在行驶的车里往窗外看,近处的树飞快向后掠过、远处的山缓缓移动——每个点「掠过」的方向和速度就是光流。
按「算多少个点」分两类:稀疏光流(只挑画面里少数特征明显的点算并跟踪,省算力,代表 LK 法);稠密光流(算每个像素的运动,通常映射到 HSV 颜色空间可视化——颜色表方向、深浅表速度,信息全但费算力,代表 Farneback 法)。
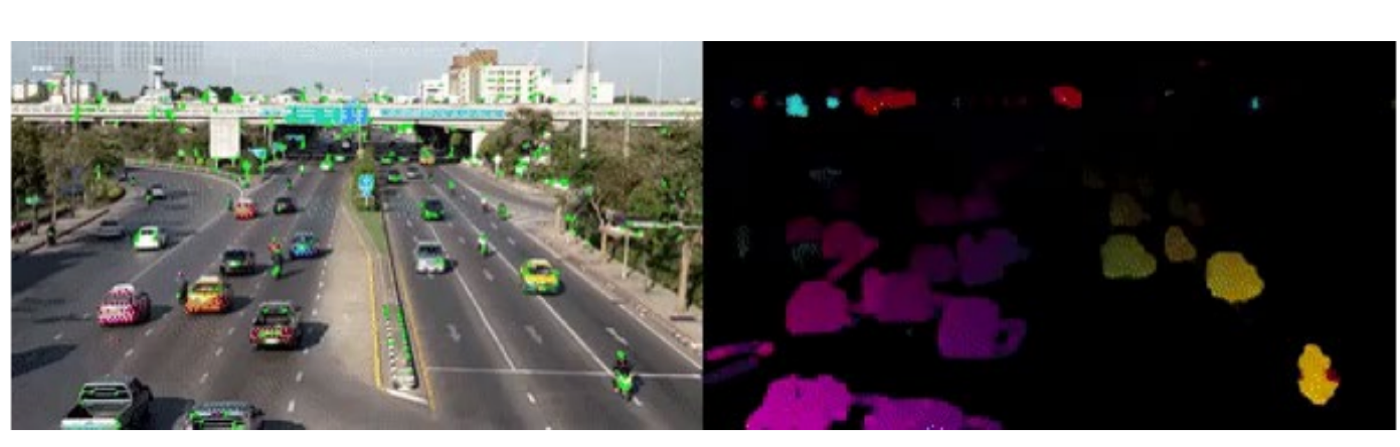
2. 两条基本假设 + 核心约束方程
光流要从「两帧图像」反推「每个像素的速度」,必须先立两条假设:
- 假设一:亮度恒定。 同一物体点在相邻两帧之间,亮度(灰度值)基本不变。
- 假设二:时间持续性(小运动)。 时间变化很短,像素位置不会剧烈跳变。
推导核心约束:设 时刻位于 的像素亮度是 ,到 时刻挪到 。由假设一(亮度恒定):
由假设二(小运动),右边泰勒展开只留一阶项:
代回消去 、整个除以 ,注意 、,记 、、,得到光流基本约束方程:
这个方程是光流估计的基础,但 都能从图像直接算出时,仍然是一个方程对应两个未知数 ,无法唯一求解。这就是孔径问题。因此还需要额外约束,不同算法的主要区别就在于怎样补充约束。
3. 第一代:Lucas-Kanade 法(传统稀疏)
LK 法(1981,Bruce Lucas 和 Takeo Kanade)是最经典的稀疏光流算法。它补约束的办法叫空间一致性假设:一个像素点周围一小块邻域( 窗口)内的所有像素,光流值都一样。
怎样补足方程:单个像素只能列 1 个方程(欠定)。假设窗口里 个像素共享同一个 后,每个像素都贡献一个方程,于是得到 个方程和 2 个未知数,可用最小二乘法求解。写成矩阵 ( 是各点梯度堆叠、、 是各点 ):
只要 可逆就能解。
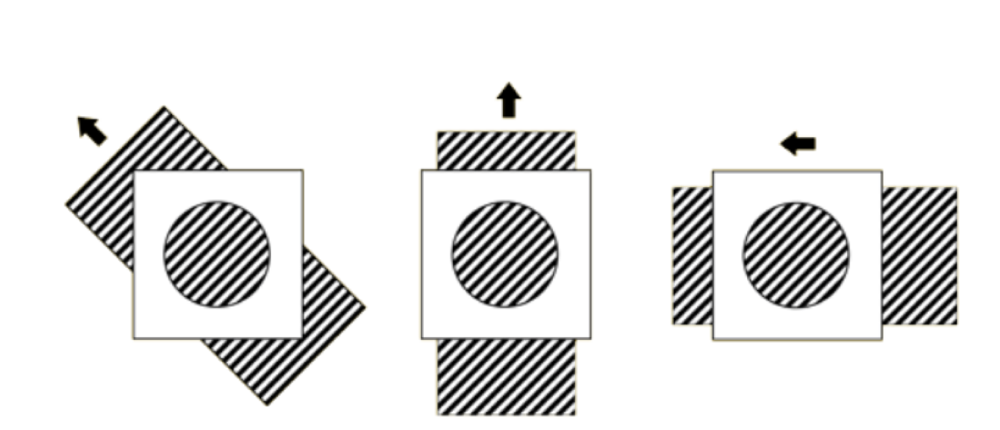
孔径问题(Aperture Problem):当 不可逆或条件数很差时,光流无法稳定地唯一求解。直觉是——从一个小圆孔里看一组移动的斜条纹,「沿垂直于条纹方向移动」和「斜着移动」看起来可能一样,分不清真实方向。窗口里若只有一条直边,像素梯度近似共线, 会退化。角点在两个方向上通常都有明显梯度,因此结构张量往往满秩、条件更好;但它不保证任何窗口都可逆,实际仍要检查两个特征值及其条件数。
金出武雄有句名言:「像外行一样思考,像专家一样实践」——思考时敢于回归本质、不被惯例束缚,实践时用专业能力把大胆想法落地。
4. 第二代:Farneback 法(传统稠密)
Farneback 法(2003,Gunner Farneback)是经典的稠密光流算法。思路是用二次多项式拟合局部图像:每像素邻域的灰度近似为
其中 对称矩阵、 向量、 标量,系数由加权最小二乘拟合邻域得到(把局部明暗近似成光滑二次曲面)。利用「同一像素相邻帧外观不变」:设位移 ,则 ,两帧多项式系数对应相等,推出光流:
直觉:两帧各拟合一个二次曲面,比较系数差异(尤其一次项 的变化)反推位移;对每个像素都算得稠密光流。
5. 第三代:FlowNet(深度学习)
前两代是手工设计(人工推假设、列方程求解)。深度学习思路——让卷积神经网络从大量数据里自己学「两帧图像 → 光流」这个映射(正是连接主义的思想)。
FlowNet 是第一个用 CNN 预测光流的工作,两种结构:FlowNetSimple(把两张图直接叠在一起输入网络);FlowNetCorr(先对两张图分别卷积提特征,再用一个「相关」操作合并匹配)。
关键结构收缩 + 扩张:前期用池化聚合大区域信息(看得广)但分辨率降低(变糊);后期用扩张路径(refinement) 恢复分辨率,把扩张的特征图与前期高分辨率低层特征图融合——既保留粗糙图的高层语义、又找回低层的局部细节;重复 refine 四次,最后双线性上采样恢复原始大小。
FlowNet2 不只是“把网络做大”,而是把不同专长的网络串起来:先以 FlowNetC 处理两帧特征匹配,再堆叠两个 FlowNetS 逐级修正;针对普通网络容易忽略的小位移,又设计 FlowNet-SD——使用更小的卷积核和 stride 保留细粒度变化,并在反卷积层之间加入卷积层,让小位移光流更平滑。大位移与小位移由不同子网络分工,再统一融合。
工具箱:OpenCV 的 cv2.calcOpticalFlowPyrLK()(LK 稀疏)、cv2.calcOpticalFlowFarneback()(Farneback 稠密);深度学习光流可用 MMFlow。
6. 从运动估计到 KCF 目标跟踪
模糊系统优化专题的末尾还补了一页 KCF(Kernelized Correlation Filter) 目标跟踪。它和光流都处理视频中的运动,但任务不同:光流估计像素怎样移动,KCF 则拿着上一帧的目标模板,在新一帧里寻找最匹配的位置。
先分清相关与卷积。离散互相关可写成
相关计算时不翻转模板,适合直接衡量“像不像”;卷积则会先翻转一个信号再滑动。进入频域后,相关对应
其中横线表示复共轭。KCF 把目标周围的循环平移样本一起训练成相关滤波器,再用核技巧表达非线性相似度;循环结构使大量候选位置可以在傅里叶域一次并行计算,所以能以很高速度完成在线跟踪。
7. 本讲小结
光流 = 像素在画面上运动的瞬时速度 (u,v)
  地基:两假设(亮度恒定 + 小运动)→ 核心约束 Ix·u + Iy·v + It = 0
       但一个方程两个未知数,解不出(孔径问题)
  三代算法各补「缺失的约束」:
    LK 法     —— 邻域光流一致 → 超定方程组、最小二乘解(稀疏、靠角点)
    Farneback —— 二次多项式拟合局部图像、比较两帧系数(稠密)
    FlowNet   —— CNN 从数据直接学映射,FlowNet2 分工处理大小位移
  跟踪补充:KCF 用核化相关滤波器快速寻找目标位置
光流对应 OODA 闭环中的感知环节。下一讲介绍具身智能和 VLA,说明视觉、语言与动作如何进入同一个模型;第十讲再看 NaVILA 复现与部署。