第六讲 · 行为主义:迭代学习控制与强化学习
对应 PPT:第五讲《迭代学习与强化学习控制》+ 具身智能专题(强化学习部分) 符号主义先写规则,连接主义需要样本答案;我在这一讲讨论没有标准答案时怎样从反馈中学习。ILC 使用上一轮的误差,强化学习则使用环境给出的奖励。
0. 两类从反馈中学习的方法
迭代学习控制(ILC) 针对重复性任务,用上一轮误差改进这一轮动作;强化学习(RL) 针对一般决策任务,根据环境奖励调整策略。
课件先把“迭代学习”放在更大的学习地图里。按目标可分为拟合类学习(从样本逼近输入输出关系)、决策类学习(在动作间选择)和生成类学习(学习数据分布并产生新样本);按信息来源又可分为监督学习、无监督学习和交互式学习。ILC 属于利用重复任务误差的迭代控制,RL 则是典型的交互式决策学习。这样看,两者都“反复变好”,但收到的学习信号并不是一回事。
可以用重复跑赛道理解 ILC:传统反馈是在偏离后再修正,而 ILC 会记录上一圈同一位置的误差,在下一圈提前加入前馈补偿。
1. 迭代学习控制 ILC
定义(Uchiyama 1978 提出,Arimoto 1984 开创):基于经验积累、逐步改进——对每轮执行后数据归纳处理、反馈优化策略,在「执行→学习→调整」重复中提升性能。三个特点是:① 面向重复性任务(焊接、装配、巡逻等);② 利用跨轮数据逐步改进;③ 可以不依赖精确的参数模型,但收敛仍取决于任务重复性、初始条件、学习律与扰动等假设。
传统反馈与 ILC 的区别:
- PID 根据当前和历史误差在单次任务内反馈修正;对象动态与控制器设计可能带来相位滞后,但不能笼统说 PID 永远滞后,也不能说它无法达到零稳态误差。
- ILC 额外使用上一轮同一位置的数据形成跨轮补偿。在任务可重复、初始状态一致且学习律满足收敛条件时,跟踪误差可以逐轮减小;是否收敛到零还取决于模型、扰动和实现条件。
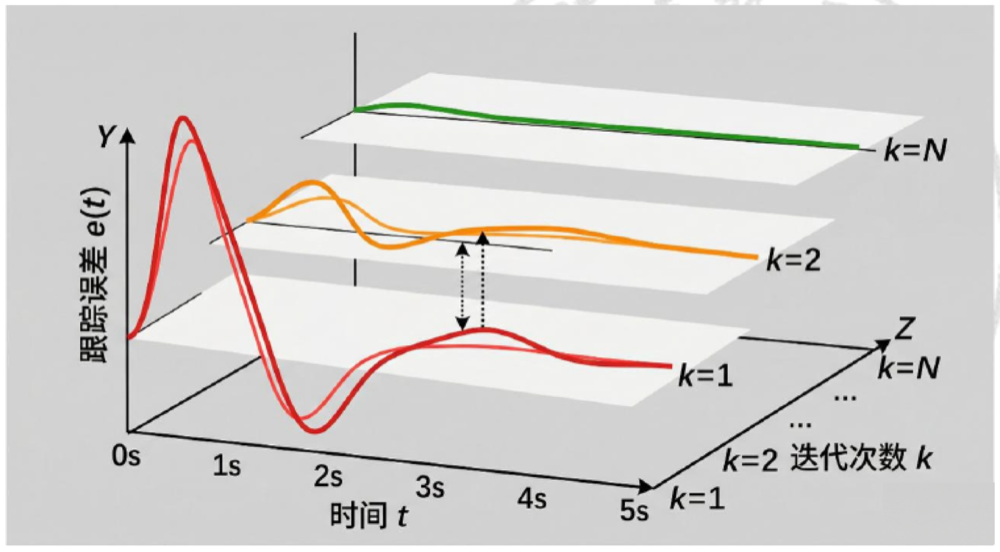
简化来看,PID 沿任务时间轴 纠正当前误差,ILC 则沿迭代轴 利用上一轮误差。
1.1 「二维时间」视角
普通控制沿任务时间 运行;ILC 额外引入迭代次数 ,用上一轮同一时刻 的误差 修正下一轮同一时刻的控制 。因此,同一个 位置可以随迭代逐轮改善。
1.2 控制律:从 D 型到 PID 型
最基础 D 型(Arimoto):。统一 PID 型:
只用 = P 型、加导数 = PD 型(提响应)、加积分 = PID 型(消稳态误差)。
这里要区分普通 P 控制和 P 型 ILC: 用当前误差计算当前控制量,属于同一轮的时间轴反馈; 则把上一轮误差加到下一轮,属于跨轮的迭代轴学习。按使用哪一轮误差,可分为用 的开环形式、用 的闭环形式,以及同时使用两者的开闭环形式。
闭环 D 型把修正信号换成当前迭代的误差导数:;闭环 PD 型再叠加 。课件还给出指数变增益 D 型:
让每一轮任务开始时修正较强,随后随时间衰减; 越大,衰减越快。它体现了一个实用思想:学习增益不必从头到尾固定,而可按任务阶段分配。
1.3 为什么「加上一轮误差」就能收敛(推导)
设线性例 ,误差 ,P 型律 。算下一轮误差:
注意 正好是 ,所以误差递推公式:
每迭代一轮,误差就被乘以因子 。若这里是标量系统,收敛条件是
若 是矩阵或线性算子,则要检查谱半径
或者用更强但容易验证的充分条件 。满足时,每个误差模态都像 一样指数衰减到 0。这说明:① 增益 应与对象 的逆动态相似,使 接近单位映射;② 不要求精确模型,但 的方向和大小仍需落在可收敛的范围内。
1.4 四关键技术
① 稳定性与收敛性(光稳定不够,必须收敛到真值才最优);② 初始值问题(收敛证明要求每轮初始状态相同 ,否则归为鲁棒性,故实验强调起点一致);③ 学习速度(收敛条件多在 给出,实际要更快——高阶迭代 / 遗忘因子 / 当前项反馈);④ 鲁棒性(有界干扰下收敛到期望轨迹邻域,干扰消除后收敛到期望轨迹)。
1.5 仿真实例(自动驾驶重复过弯)
二阶非线性 , = 轮胎侧偏未建模非线性, = 重复性外扰(坡度 / 风阻 / 附着,每圈一样故 ILC 能学会补偿),误差 。三阶段:第 1 次迭代过弯大超调;第 5 次记录误差曲线、提前反向补偿、明显变好;第 30 次轨迹与期望几乎重合、误差近 0。即「刷圈」从生疏到肌肉记忆。
2. 强化学习 RL —— 框架与理论
入门例子(倒立摆 / 平衡杆):杆铰接在小车上,左右推车让杆别倒。没人给「每刻推多大力」的标准答案(故不能监督学习),只能试错:立住 = 好、倒了 = 坏,摸索出策略。这种「靠好 / 坏反馈试错学策略」= 强化学习。
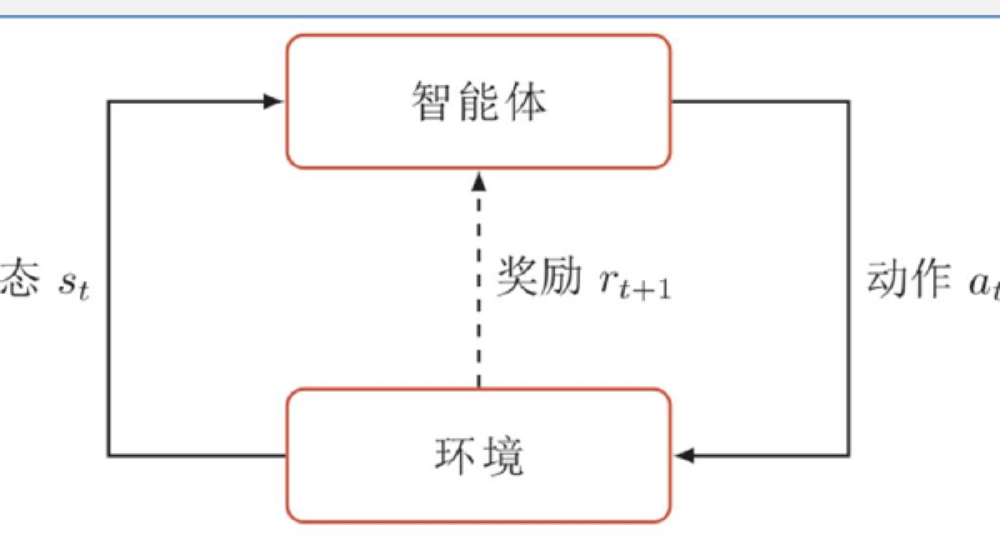
基本框架:智能体(Agent) 感知状态、执行动作并根据奖励调整策略;环境(Environment) 受动作影响改变状态并反馈奖励。时刻 观察状态 → 选择动作 → 环境转移到 并给出奖励 → 智能体更新策略,然后进入下一时刻。目标是最大化长期累积奖励。
MDP(马尔可夫决策过程)——要素:状态集 、动作集 、状态转移概率 、即时奖励 。马尔可夫假设:下一状态只取决于「当前状态 + 当前动作」,与更早历史无关(如下棋只看当前棋盘)。课件对比了四种相关模型:
| 模型 | 能否决策(动作) | 状态是否完全可观测 |
|---|---|---|
| 马尔可夫链 MC | 否(纯随机演化) | 完全可观测 |
| 隐马尔可夫 HMM | 否(无决策) | 部分可观测 |
| 马尔可夫决策过程 MDP | 是 | 完全可观测 |
| POMDP | 是 | 部分可观测 |
记忆:有无动作 = 决策过程 vs 纯过程;状态看全否 = 完全 vs 部分可观测。POMDP 最难,第八讲具身智能会用到(摄像头只看局部)。
策略 / 回报 / 折扣率:策略 = 状态 下选各动作的概率。总回报 = 一条轨迹累积奖励,但加折扣:
折扣率 :① 越远奖励越不确定越不值钱(明天的 100 不如今天的 100);② 调眼光—— 目光短浅、 重视长远。
值函数 / Q 函数 / 贝尔曼方程:
- 状态值函数 :从 按 走的期望总回报(「我现在处境前景如何」)。
- 动作值函数 (Q=Quality): 下先做 再按 走的期望总回报。比 V 多「动作」维,更有用——挑 Q 最大的动作即可。
- 贝尔曼方程:当前状态期望回报 = 即时奖励 + 折扣后的下一状态期望回报,。它把无穷累积回报改写成只关联当前与下一步的递推,许多强化学习算法据此迭代更新值函数。
探索与利用:利用是选择当前已知最优动作,稳定但可能错过更好的选择;探索是尝试尚未充分评估的动作,可能发现更优策略,也可能受到惩罚。只利用可能停在局部最优,只探索则难以形成稳定策略。
3. 强化学习的算法:从 Q-Learning 到 PPO/SAC
强化学习可以先按是否使用环境模型分成无模型与有模型。无模型算法还可以按主要优化对象区分为:基于值的方法(Q-Learning、DQN)、直接策略优化(REINFORCE、TRPO、PPO)和Actor-Critic(A3C、A2C、DDPG、TD3、SAC)。这些分支不是严格互斥的,例如 PPO 通常也用 Critic 估计优势函数,但更新重点仍是受约束的策略优化。
有模型强化学习既可以使用已知动力学,也可以从交互数据学习“状态 + 动作会带来什么后果”的世界模型。拿到模型后有三种典型用法:① 直接在模型里搜索动作序列;② 用 MPC 每一步滚动预测一段未来,只执行第一步再重算;③ 用模型生成或校正数据,帮助估计值函数。它通常比纯试错省真实交互,但模型误差会被多步规划放大,所以工程上常把短期模型规划与无模型的长期价值估计混合起来,TD-MPC 就属于这条路线。
3.1 Q-Learning——走房间例子
5 房间 + 屋外(5),抽象成图(房间 = 状态节点,门 = 动作边),目标从任意房间到屋外。奖励:直通目标的边 = 100、其他 = 0、不通 = -1,状态 5 自环 = 100(吸收目标:到了就待着)。Q 表(行状态列动作)初始全 0,靠探索填。更新公式(贝尔曼实操版):
其中 是学习率,方括号内是时序差分误差。目标值由即时奖励与下一状态的最优动作价值组成,再用 控制本次更新幅度。课件的房间例子采用 的简化写法;在初始 、 时,才有 。到目标后本 episode(回合) 结束,再换起点继续采样。
3.2 DQN
Q-Learning 需要用表存下所有 ,面对像素等高维状态时难以实现。DQN(深度 Q 网络,Mnih 2015) 用神经网络近似 Q 函数:输入状态,输出各动作的 Q 值。它把 CNN 与 Q-Learning 结合,实现从 Atari 原始像素到动作的端到端学习。训练时使用两个网络:eval net 每步更新并计算当前 Q,target net 每 步复制一次 eval net 参数,为更新提供相对稳定的目标。
3.3 算法谱系与对比
先懂 Actor-Critic:Actor(演员) = 策略网络输出动作;Critic(评论家) = 值函数网络给动作打分;优势函数 (这动作比平均好多少,代替原始回报更新策略,降梯度方差、训练更稳)。
| 算法 | 分支 | 动作空间 | 主要做法 |
|---|---|---|---|
| A3C | Actor-Critic | 离散 / 连续 | 多个 worker 异步采样,并异步更新共享参数 |
| A2C | Actor-Critic | 离散 / 连续 | A3C 的同步替代:多个环境并行采样后统一更新 |
| PPO | 直接策略优化 | 离散 / 连续 | 用 Clip 等约束限制新旧策略变化幅度,通常配合 Critic 估计优势 |
| SAC | 离策略 Actor-Critic | 连续 | 最大熵目标同时优化回报与策略熵 |
| TD-MPC | 有模型 | 连续 | 学习隐变量动力学,用短期规划结合长期价值 |
更准确的关系是:基于值的方法从 Q-Learning 发展到 DQN;直接策略优化包含 REINFORCE、TRPO、PPO;A3C 与同步实现 A2C 属于 Actor-Critic 分支,不能排成 A2C→A3C 的前后继关系;DDPG、TD3、SAC 也是面向连续控制的 Actor-Critic 方法;TD-MPC 则属于有模型路线。PPO 曾用于 InstructGPT 的人类反馈强化学习,但这不等于所有大模型都固定使用 PPO。
3.4 强化学习与最优控制的接口
非线性系统 的最优控制要寻找 ,使性能函数 (状态代价与控制代价的累积)最小。变分法可推出 HJB(哈密顿-雅可比-贝尔曼)方程,它是连续时间的贝尔曼方程,但通常是难以得到解析解的非线性偏微分方程。强化学习可以通过策略迭代等方法数值逼近其解,因此与最优控制存在直接联系。
3.5 经典应用脉络
① 倒立摆(1983, Barto/Sutton/Anderson)——RL 控制奠基,动力学未知也能学会平衡(二人获 2024 图灵奖);② DQN(2015)——深度 RL 主流化标志;③ AlphaGo(2016, Silver)——策略网络 + 价值网络 + 蒙特卡洛树搜索 + 自我博弈,标志 RL 从「学单一策略」到「表示学习 + 价值评估 + 规划搜索」综合决策;④ Roach(2021)——RL 专家(PPO 训练)当「教练」监督端到端城市自动驾驶,迁移决策知识给单目摄像头学生模型,缓解模仿学习分布偏移。
4. 本讲小结:ILC vs RL
| 维度 | 迭代学习控制 ILC | 强化学习 RL |
|---|---|---|
| 适用任务 | 重复性任务(同轨迹刷圈) | 一般决策任务(状态多变) |
| 学习信号 | 上一轮误差 | 环境奖励 |
| 学习维度 | 迭代轴 (跨轮前馈) | 时间轴状态-动作序列 |
| 目标 | 逐轮减小重复轨迹的跟踪误差 | 最大化长远累积奖励 |
| 直觉 | 吃一堑长一智(刷圈速) | 试错 + 奖惩(学骑车) |
| 模型依赖 | 免精确模型(要 方向对) | 无模型 / 有模型两支 |
ILC 利用重复任务中的误差逐轮改善轨迹,强化学习则根据奖励在交互中改进策略;两者都能放进控制系统的反馈与优化框架中理解。
下一讲:感知基础——光流。在让智能体「行动」之前,先让它「看懂」环境在怎么动。