第五讲 · 连接主义:神经网络控制与序列建模
对应 PPT:第四讲《神经网络控制》+ 循环神经网络专题 + Transformer 模型专题 前四讲讨论了规则、隶属度与可训练的 TSK 系统。我在这一讲转向连接主义:不再逐条编写规则,而是给出「输入→输出」样本,让模型从数据中学习规律。这是 2006 年后 AI 的主流范式。
1. 机器学习在「学」什么:构造一个映射函数
可以把机器学习理解为构造一个映射函数 。看图认猫(像素→是否猫)、自动驾驶转向(画面→方向盘转角)、控制(误差→控制量 ),都可以写成寻找一个 。传统编程由人明确写出 (如 PID 公式、模糊规则);机器学习则根据一组 样本估计 。
三种基本学习方式的差异不在网络名字,而在“拿到什么反馈、优化什么目标”:
| 类型 | 训练信息 | 目标与学习准则 | 课程中的例子 |
|---|---|---|---|
| 监督学习 | 带标签样本 | 让预测与标签的损失最小 | 函数逼近、RBF 辨识 |
| 无监督学习 | 只有输入 | 从数据自身发现结构或分布 | 聚类、表示学习 |
| 强化学习 | 状态、动作、奖励和下一状态 | 最大化长期累计奖励 | 第六讲的 Q-Learning、PPO |
机器学习三要素(任何方法都是这三样的组合):
-
模型(Model):框定「 长什么样」的候选函数家族 + 可调旋钮 。
- 线性模型 ;
- 广义线性模型 。
- 关键:若基函数 本身是可学习的非线性函数,则 就等价于一个神经网络。即:神经网络 = 连基函数 都让机器自己学的广义线性模型(呼应第四讲 TSK ≈ RBFN 的伏笔)。
-
学习准则(Learning Criterion):用损失函数给「这套旋钮好不好」打分,目标是让期望风险最小:
-
优化方法(Optimization):怎么拧旋钮让损失最小——梯度下降。直觉是「蒙眼下山」:感知当前最陡下坡方向(负梯度),迈一小步,反复滚到谷底;步长由学习率控制。
2. 神经元与激活函数
神经网络 = 用「神经元」这种小积木堆成千上万个。生物神经元:树突收信号 → 细胞体汇总 → 超过阈值就「激活 / 放电」,否则沉默。
人工神经元 = 两步:
- 加权求和:( = 输入重要性, = 可调激活门槛)。
- 过激活函数:。
例:、、 → → 。神经网络要学的旋钮 就是所有神经元的 。
为什么需要激活函数:没有它,每个神经元只是线性变换,线性变换叠加后仍是线性的,堆 100 层也等价于 1 层,连异或都无法表示。激活函数负责引入非线性,使多层网络能够逼近复杂函数。
三个常用激活函数:
- Sigmoid / Logistic:,压进 ,软开关。
- Tanh:,压进 ,以 0 为中心。
- ReLU:,负的归零、正的放行,现在的默认选择。
Sigmoid/Tanh 与 ReLU 的梯度差异:Sigmoid 在输入离 0 很远时曲线几乎水平,导数趋近 0。反向传播会连续相乘各层导数,多次乘上接近 0 的值后,前面层得到的梯度很小。ReLU 在 时导数恒为 1,因此更有利于梯度向前面层传播,深层网络中也更常使用。
3. 前馈神经网络与通用近似定理
前馈神经网络:信号只朝一个方向走——输入层 → 隐藏层 → 输出层,不回头、不成环(有向无环图)。同层神经元互不相连,相邻层通常全连接。整个网络是一串「加权和+激活」的嵌套复合函数(5 层为例):
**通用近似定理(Universal Approximation Theorem)**有多种版本。常用版本说明:采用合适的非线性激活函数(例如连续且非多项式的激活函数)时,带一个隐藏层和线性输出层的前馈网络,只要隐藏单元足够多,就能在紧集 上以任意精度一致逼近任意连续函数。它不表示任意激活函数都成立,也不直接覆盖任意不连续函数。
这个定理说明,用神经网络逼近映射 在表示能力上是可行的,也与第三讲的模糊系统万能逼近性质相呼应。
两个澄清(防误解):① 「存在」≠「找得到」——定理只保证有那么个好网络,没说怎么训练(那是优化问题,靠反向传播,常很难);② 「单层够用」≠「单层最好」——做深(多隐藏层)往往用少得多的神经元达到同样效果(先学简单特征再拼复杂特征:边缘→轮廓→猫脸),这是用深度学习的原因。
4. 反向传播:神经网络怎么「学」出来
反向传播(Backpropagation, BP,Rumelhart/Hinton/Williams 1986) 解决「怎么把埋在深层的权重训练出来」。
问题:梯度下降要拧某个权重 ,得知道它的梯度 (「动这个权重一点点,最终损失变多少」)。难在网络层层嵌套,要调的权重可能埋在第一层,它对末端损失的影响「拐了好几道弯」。
工具:链式求导法则。网络是大复合函数,链式法则把「跨层总账」拆成「一串局部导数连乘」。直觉 = 齿轮传动比相乘:齿轮 1→2 传动比 、2→3 传动比 ,则 1 对 3 的总影响 。把 拆成 :
每项是相邻两步的局部导数,单独都好算;难算的总账 = 一串好算的小账连乘。
两趟走:① 前向传播——输入 一层层算到底得预测 ,与真值比算损失 (从前往后);② 反向传播——从输出层损失出发,把误差信号沿网络往回一层层倒推算梯度(「误差从后往前倒推」=「反向」的由来),复用后层已算结果、一趟回传算完全网络梯度。然后梯度下降更新权重,重复成千上万次(每次喂一个 mini-batch = MBGD)。
接回梯度消失:反向传播是一串局部导数连乘,用 Sigmoid 则每环贡献趋近 0 的小导数、连乘几层梯度消失;ReLU 正区间导数恒为 1。梯度消失 = 反向传播的连乘链断在半路。
5. 神经网络控制结构(课件重点)
现在回到本门课的主线——控制。这么个会学习的网络,接在控制回路的哪个位置?
顶层二分:神经控制(神经网络为主体,独立构成控制器)vs 混合神经网络控制(用网络的学习能力改善传统控制器,或与模糊 / 专家系统结合)。
六种神经控制结构,再加一类混合控制:
| 结构 | 网络角色 | 直觉 | 归类 |
|---|---|---|---|
| 监督控制 | 偷师传统控制器 | 老司机带新手:NNC 学传统控制器输出(当标准答案),学成逐渐取代、传统控制器留作保底 | 神经控制 |
| 直接逆控制 | 对象逆模型 | 英译中接中译英:网络学 串在对象前,正反抵消使传递函数≈1。无反馈、鲁棒性差,需在线学习 | 神经控制 |
| 自适应·自校正 | 辨识未知参数 | 对象 ,解方程 , 未知则用网络辨识 | 神经控制 |
| 自适应·模型参考 | 逼对象模仿理想榜样 | 设参考模型(理想响应曲线 = 标准示范),NNC 调参把误差 压到最小 | 神经控制 |
| 预测控制 | 预测未来的模型 | 看一段路、只走一步、滚动重规划(预测模型 + 滚动优化 + 反馈校正,呼应 MPC) | 神经控制 |
| 自适应评判 | 评委 + 运动员 | Critic 按外部再励信号打分、Actor 据内部再励信号选动作。没有标准答案、靠奖惩试错 = 强化学习核心(→第六讲) | 神经控制 |
| 混合控制 | 与模糊 / 专家系统联姻 | 神经网络 + 模糊 = 模糊神经网络;+ 专家系统 = 神经网络专家系统。会学 + 会讲道理 | 混合控制 |
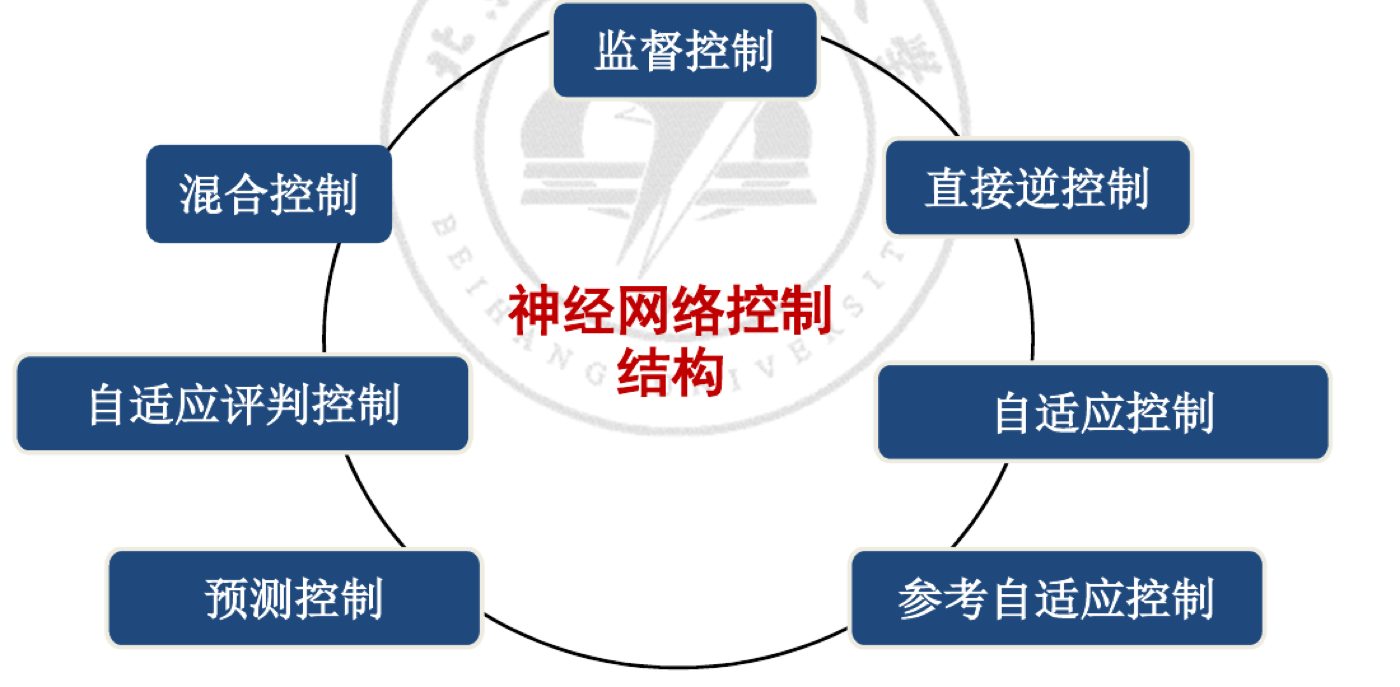
工程中还要分别检查:网络本身是否稳定、接入后整个闭环是否稳定、在线学习能否在采样周期内完成,以及控制器和辨识器该选什么输入与结构。“网络训练收敛”不等于“被控系统闭环稳定”,两者不能混为一谈。
6. RBF 网络控制
RBF = Radial Basis Function(径向基函数),控制领域最常用的神经网络。固定三层,特别处在隐藏层用高斯函数当激活函数。
「径向基」拆名:径向=只看距离——每个隐藏神经元揣一个中心 ,输入 进来只关心「离我中心多远」。第 个隐藏神经元(高斯):
行为 = 「以 为圆心的钟形山包」:输入正好在中心→(最强);离中心越远→(越弱);基宽 控制山包胖瘦。直觉:每个隐藏神经元是「片区探测器」,只盯输入空间里以 为中心的一小片。输出层线性加权:。
控制领域偏爱 RBF 的三理由:① 局部响应→学得快、不互扰(每个高斯只管一片,调一处不乱全局),适合在线实时控制;② 结构简单单隐藏层,但仍是万能逼近器;③ 数学性质好,便于稳定性分析。
权值更新靠梯度下降——定性能指标 ,更新:
= 学习率, = 动量因子(让本步参考上步方向、加速收敛减震荡)。本质和反向传播同一回事。进阶版连中心 、基宽 也一起在线调。实例谱系:ALVINN(早期车辆控制)→ DAVE-2(CNN 端到端转向)→ RBF 极限工况横向稳定控制 → RBFNN-PID(转向执行层非线性补偿)。
6.1 RBF 怎样进入在线控制闭环
课件用一个单输入非线性对象说明自校正控制:
若 已知,确定性等价控制律直接取
难点恰好是对象未知。于是用两个 RBF 输出 分别在线辨识 。若两套网络共用同一类高斯基函数,可写成
其中 、 是两套输出权值。一步预测为
令辨识误差 、损失 ,最直接的梯度更新是
v_j\leftarrow v_j+\eta_v e_m u(k-1)h_j^\phi.$$ 第二式必须带 $u(k-1)$,因为 $N_\phi$ 在预测式里还乘了控制输入;课件对应增量式疑似漏掉了这一链式因子。这样控制器不需要先得到完整精确模型,而是一边控制、一边用观测误差修正辨识器。 模型参考自适应控制则让另一个 RBF 直接输出 $u(k)$,目标是让对象输出追踪参考模型 $y_m(k)$。除了权值,中心和基宽也按同一损失反向更新: $$c_{ij}\leftarrow c_{ij}-\eta_c\frac{\partial E}{\partial c_{ij}},\qquad b_j\leftarrow b_j-\eta_b\frac{\partial E}{\partial b_j}.$$ 对高斯基函数 $h_j=\exp[-\|x-c_j\|^2/(2b_j^2)]$, $$\frac{\partial h_j}{\partial c_{ij}} =h_j\frac{x_i-c_{ij}}{b_j^2},\qquad \frac{\partial h_j}{\partial b_j} =h_j\frac{\|x-c_j\|^2}{b_j^3}.$$ 再乘上“损失对网络输出”和“网络输出对 $h_j$”的导数,就得到实际增量。模型参考控制的梯度里还会出现 $$\frac{\partial y(k)}{\partial u(k)}$$ 叫 **Jacobian 信息**,表示对象输出对控制输入的敏感性,可由神经网络辨识器近似得到。它不必极其精确,剩余误差会继续通过闭环参数更新被修正。 ## 7. TSK 模糊系统与 RBF 网络的对应关系 零阶 TSK 的第 $j$ 条规则写作「IF $x_1$ is $F_{j,1}$ AND $x_2$ is $F_{j,2}$ THEN $y_j$=常数」。先计算点火强度 $f_j(x)$,再按点火强度加权平均:$y(x)=\frac{\sum_j f_j(x)y_j}{\sum_j f_j(x)}$。 **关键一步——前件隶属函数选高斯**:则点火强度(两高斯相乘 = 指数相加) $$f_j(x)=\exp\!\Big(-\frac{(x_1-m_{j,1})^2+(x_2-m_{j,2})^2}{\sigma_j^2}\Big)$$ 这正是 RBF 隐藏层那个「以 $(m_{j,1},m_{j,2})$ 为中心的钟形片区探测器」$h_j$。两套输出公式并排:TSK $y=\frac{\sum_j f_j y_j}{\sum_j f_j}$ 与归一化 RBF $y=\frac{\sum_j h_j w_j}{\sum_j h_j}$ —— **完全一样**。 五条对应(Jang & Sun 1993):规则数 = 神经元数、前件高斯 = 隐藏层高斯激活、t-范数相乘 = 高斯多维相乘、后件常数 = 输出权重 $w_j$、加权平均 = 加权求和。 由此可以得到三点:① 两者都用局部钟形基函数分片逼近曲面;② 这组对应关系支持神经模糊系统和 ANFIS 的可解释、可训练结构;③ MLP、MoE、CART、Stacking 等模型的训练方法也可用于优化 TSK 模糊系统。 --- ## 8. RNN 循环神经网络:给网络装上「记忆」 前面的网络都假设「每次输入独立、输出只看当前输入」。但**序列问题**(文本、语音、视频、物理过程——任何嵌在时间里的东西)前后有依赖、顺序有意义(「我不喜欢」vs「我喜欢」;轨迹下一秒依赖前几秒)。前馈网络两硬伤:输入输出维度固定(处理不了变长序列)、没记忆。 **RNN(Recurrent Neural Network)核心结构**:加一条自反馈回路,把「这一刻的内部状态」留给「下一刻」用。这个不断后传的内部状态叫**隐藏状态** $h_t$(= 记忆)。每个时间步: $$h_t=\tanh\big(W_x x_t+W_h h_{t-1}+b\big)$$ 大白话:这一刻记忆 = 当前输入 $x_t$ 和上一刻记忆 $h_{t-1}$ 混合后过 tanh 压一下。$h_{t-1}$ 里又揉着前天的记忆……故 $h_t$ 层层藏着从开头到现在的历史。 **两个关键概念**:① **时间展开**——把自环拉直、每个时间步画一个网络副本,看起来像「深度方向是时间」的深前馈网;② **参数共享**——所有时间步用**同一套权重** $W_x,W_h$,好处是能处理任意长度序列 + 规律平移不变(与 CNN 卷积核扫全图同理)。 **长程依赖与梯度消失 / 爆炸**:反向传播沿时间连续相乘,链很长时,每一项小于 1 会使乘积趋近 0,形成**梯度消失**;每一项大于 1 则可能形成**梯度爆炸**。因此普通 RNN 很难保留很早的信息。输入输出形态包括多对一(情感分析)、一对多(看图说话)和多对多(机器翻译)。 ## 9. LSTM:给记忆装上「门」 RNN 只有一条记忆通道 $h_t$,每步把新信息一股脑混入再整体压扁,旧信息被冲刷。**LSTM(Long Short-Term Memory,Hochreiter & Schmidhuber 1997)**:开一条「传送带」式**长期记忆**通道 $C_t$ 让信息原样流过多步不被冲刷,再用**三道闸门**精确控制忘 / 记 / 说。 **门(gate)零件**:逐元素相乘 + Sigmoid。Sigmoid 把数压进 (0,1):**0 = 闸门全关,1 = 全开**。三道门都看 $[h_{t-1},x_t]$ 做决定: - **① 遗忘门 $f_t$**(长期记忆里哪些擦掉):$f_t=\sigma(W_f\cdot[h_{t-1},x_t]+b_f)$,逐元素乘到旧记忆 $C_{t-1}$。 - **② 输入门 $i_t$**(新信息里哪些值得存):先 tanh 生成候选新记忆 $\tilde C_t$,再 Sigmoid 门 $i_t$ 决定写多少。 - **③ 状态更新**:$C_t=f_t\odot C_{t-1}+i_t\odot\tilde C_t$(先擦掉要忘的信息,再写入新信息)。旧记忆 $C_{t-1}$ 通过加法路径进入新状态,而不是反复乘权重;遗忘门接近 1 时,信息和梯度可以沿这条路径保留更久。 - **④ 输出门 $o_t$**(这步对外说什么):$o_t=\sigma(W_o\cdot[h_{t-1},x_t]+b_o)$,$h_t=o_t\odot\tanh(C_t)$。 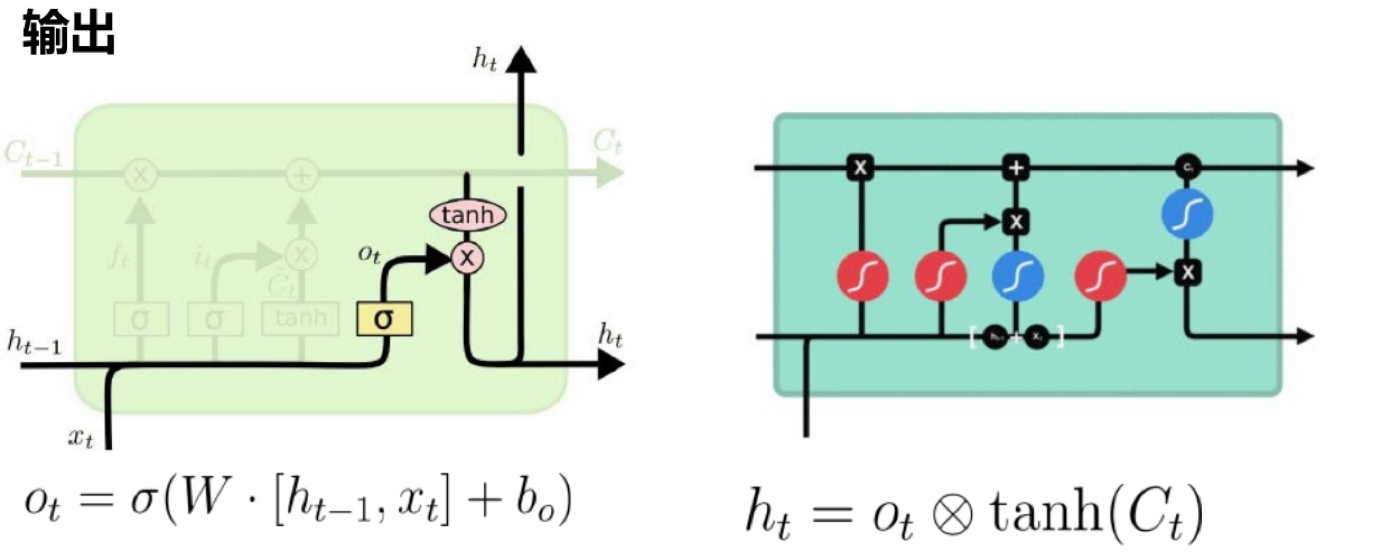 口诀:**遗忘门忘旧、输入门记新、输出门说话**。**GRU(Gated Recurrent Unit)** = LSTM 简化版,三门精简为两门,参数少训练快、效果常相当。 ## 10. Transformer:抛弃循环,改用注意力 LSTM 改善了长程记忆,但和 RNN 一样必须**按时间逐步计算**($h_t$ 依赖 $h_{t-1}$),难以并行。**Transformer(2017)** 去掉循环,让每个词通过注意力直接读取其他词的信息。没有递推链后,各位置可以并行计算,任意两个位置之间也不再受序列距离限制。 **① 词→向量:One-hot → Embedding**。one-hot(每词一超长向量、自己位 1 其余 0)太稀疏、任意两词正交算不出语义关系。**Embedding(词嵌入)**:可学习矩阵把它压成低维稠密向量,训练后意思相近的词向量也相近(猫≈狗,远离桌子)。 **② 注意力内核:点积算相关度**。点积 = 两向量逐元素相乘求和,方向越一致越大→当「相关度打分器」:A 该不该关注 B,就拿 A、B 向量点积。 **③ 为什么要「跳跃式」注意力**:预测一个词,该重点看的可能是很远处某个特定词(`Check the program/battery log ... whether it ran (down)`,决定 down 的词隔了一长串)。「跳过无关、精准盯远处关键词」= 注意力。 课件先用序列模型逐步推出这个需求:一阶模型只依赖相邻一个词,二阶模型把窗口扩到两个词,带 skip 的二阶模型允许当前位置与非相邻、更早的词组成二阶特征。skip 能越过一部分无关词,但连接仍来自人预设的特征模板;真正的语言依赖却由内容决定,关键词可能隔着任意多的无关词。注意力的进步就是把**固定连边**改成**每次根据输入动态计算连边权重**。 **④ Q/K/V 机制**:对每个词造三向量——**Query** 「我想关注什么」、**Key** 「我能提供什么信息(索引)」、**Value** 「我实际携带的内容」。比喻查字典:Q = 要查的词条,K = 词头索引,V = 解释内容。三步:① 当前词 Q 与所有词 K 点积打分;② Softmax 变成和为 1 的**注意力权重**;③ 用权重对所有词 V 加权求和。公式: $$\text{Attention}(Q,K,V)=\text{Softmax}\!\left(\frac{QK^{\mathsf T}}{\sqrt{d_k}}\right)V$$ $QK^{\mathsf T}$ = 每词对每词点积打分一次矩阵乘算完(**注意力 = 矩阵乘法**,GPU 可大规模并行);$\sqrt{d_k}$ 缩放防 Softmax 饱和。 **⑤ 补两零件**:**Masking(掩码)**——文本生成时预测第 $t$ 词不能偷看 $t$ 及以后(答案),打分后 Softmax 前把未来位置设 $-\infty$,保证因果性;**Positional Encoding(位置编码)**——抛弃循环后模型不知词序(「狗咬人」=「人咬狗」),给每词 embedding 加一个编码「第几位」的向量(不同频率正弦 / 余弦),既并行又不丢顺序。 **⑥ Multi-Head Attention(多头)**:一组 Q/K/V 只能学一种关注模式,但词间关系多维度(语法 / 语义 / 局部 / 全局)。多头 = 并行多套独立 Q/K/V,各学一种模式,结果拼接融合。比喻委员会同审一句话,各看一角度再汇总。 **⑦ 完整 Transformer 块**:注意力不是整台 Transformer。Encoder 每层依次做多头自注意力和逐位置前馈网络(FFN),两个子层都使用残差连接与 Add & Norm;相同结构重复 $N$ 次。Decoder 每层有三段:Masked Self-Attention 不能偷看未来,Encoder–Decoder Cross-Attention 用 Decoder 表示作 Query、Encoder 输出作 Key/Value,最后再过 FFN;每段同样带残差和归一化。FFN 对每个位置独立使用同一套两层 MLP,负责把注意力混合后的特征再做非线性加工。 **⑧ 收尾**:多层加工后用 De-embedding 映射回词表每词分数,Softmax 成概率,挑最高词输出,逐词生成。 Transformer 可以并行处理序列并直接建立长程联系,但自注意力的计算量随序列长度按 $O(N^2)$ 增长。第四讲的 Mamba/SSM 用状态空间形式 $\dot h=Ah+Bu,\ y=Ch+Du$ 处理这一问题。 ## 11. 本讲小结 ```text 机器学习 = 找映射 f(模型 + 损失 + 梯度下降) 神经元 = 加权和 + 激活(注入非线性,ReLU 治梯度消失) 通用近似定理:合适非线性激活 + 足够宽隐藏层 → 逼近紧集上的连续函数 反向传播(链式法则):误差从后往前倒推算梯度 │ 神经网络控制结构(监督/直接逆/自校正/模型参考/预测/自适应评判/混合) RBF 网络:局部钟形响应,适合在线学习 └── TSK ≈ RBF(神经模糊 ANFIS) 序列建模:RNN(记忆但记性短)→ LSTM(三门 + 传送带)→ Transformer(注意力 + 并行) ``` **下一讲**:行为主义——没有人教、也没有标准答案,靠「做了之后看反馈」来学(迭代学习控制 + 强化学习)。