第四讲 · 模糊系统优化:TSK、ANFIS 与 Mamba
对应 PPT:模糊系统优化专题。第三讲的 Mamdani 控制器靠人写规则,我在这一讲继续追问:规则能否从数据中优化?答案是把后件改成函数,再把整套模糊推理画成一张可反向传播的网络。
1. 从 Mamdani 到 TSK:只改后件,性质就变了
一条二输入 TSK(Takagi-Sugeno-Kang)规则写成:
- 前件仍用隶属函数判断输入对规则的符合程度;
- 后件不再是「 is PB」这样的模糊标签,而是一个普通函数;
- 时是零阶 TSK,每条规则只输出一个常数;否则是一阶 TSK。
Mamdani 是「每条规则给一个模糊结论,最后统一解模糊」;TSK 是「每条规则先算出一个数,再按激活强度加权平均」。因此 TSK 天然给出数值输出、可微,也更容易用数据训练。
设第 条规则的激活强度为 ,后件为 ,归一化权重为
则最终输出为
这条「局部模型按输入相关权重融合」的式子,是后面所有等价关系的共同骨架。
2. 三个工程难点
- 优化:前件的中心、宽度和后件参数都要确定,可用进化算法、梯度下降,或「梯度下降 + 最小二乘」混合优化。
- 维数灾难:若每个输入切成 个模糊集, 维输入最多会产生 条规则。
- 泛化:规则太多同样会过拟合,需要正则化、规则丢弃和更好的初始化。
3. TSK 与几类机器学习模型的关系
3.1 TSK 与 RBF 神经网络
若前件采用高斯隶属函数,多输入的规则激活强度可以写成
它就是 RBF 网络隐藏层的径向基响应。零阶 TSK 的常数后件对应 RBF 输出权重,归一化加权平均也完全一致:
| TSK 模糊系统 | RBF 网络 |
|---|---|
| 一条规则 | 一个隐藏层神经元 |
| 高斯隶属函数中心 | RBF 中心 |
| 规则激活强度 | 高斯基响应 |
| 常数后件 | 输出权重 |
| 归一化加权平均 | 归一化 RBF 输出 |
这说明两个「万能逼近器」并非巧合:它们都在用许多局部钟形基函数拼出复杂曲面。差别是,TSK 可以把每个局部模型翻译回 IF-THEN 规则,解释性更强。
3.2 MoE、CART 与 Stacking
- 混合专家 MoE:每条规则就是一个局部专家,前件隶属度就是路由权重。
- 分类回归树 CART:从根到叶的一条路径是一条规则,叶节点给局部输出;树可以帮助初始化高维 TSK 规则。
- Stacking:各规则后件是基础回归器,但 TSK 的融合权重随输入变化,比固定权重的普通 Stacking 更灵活。
这些对应关系说明,TSK 同时具有规则系统、局部模型和集成学习的特点。
4. ANFIS:把模糊推理展开成五层网络
ANFIS(Adaptive-Network-based Fuzzy Inference System)把 TSK 推理拆成五层:
- 计算每个输入对各模糊集的隶属度;
- 合并前件,得到每条规则的激活强度;
- 把所有规则的激活强度归一化;
- 用归一化强度乘该规则的后件函数值;
- 对所有规则结果求和,得到最终输出。
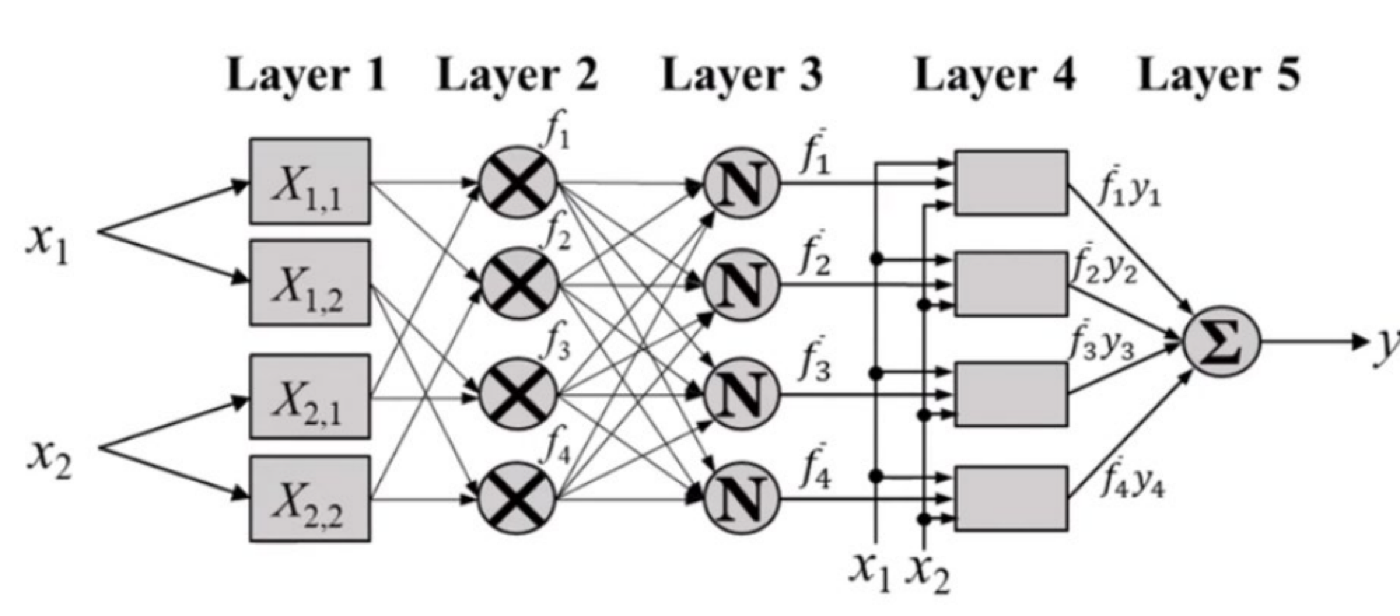
每层都有清晰语义,却又能像前馈网络一样反向传播。这就是「神经模糊」的核心:训练时当神经网络,解释时还原成规则。
5. 怎样训练 TSK
5.1 目标函数
回归常用带 L2 正则的均方误差:
分类则把输出经过 Softmax,用交叉熵训练;还可加入均匀正则,避免少数规则长期垄断全部样本。
5.2 初始化与微调
- 回归可在每个输入维的取值区间均匀放置高斯中心,宽度按该维标准差初始化;
- 分类常用 k-means 初始化规则中心;
- 后件参数先置零,再用 mini-batch 梯度下降微调。
MBGD 在「全量梯度稳定但慢」和「单样本梯度快但抖」之间折中,是大数据训练的默认选择。Adam 或 AdaBound 用来加速;DropRule 像模糊系统版 Dropout,训练时随机关掉部分规则;LayerNorm、BatchNorm 与 ReLU 则改善高维训练和泛化。
| 环节 | 回归 | 分类 |
|---|---|---|
| 目标 | L2 正则 | L2 + 均匀正则 |
| 初始化 | 半随机均匀放置 | k-means |
| 大数据 | MBGD | MBGD |
| 加速 | Adam / AdaBound | Adam / AdaBound |
| 泛化 | DropRule / LayerNorm | ReLU / BatchNorm |
6. Mamba 与状态空间法
专题最后介绍 Mamba,关注的是与 TSK 相似的方法:把已有数学结构嵌进可学习模型。
Transformer 的自注意力需要两两比较 token,时间和显存复杂度随序列长度 近似按 增长。状态空间模型则用有限维隐藏状态压缩历史:
它与自动控制中的
形式完全相同。矩阵 决定记忆怎样演化, 决定当前输入怎样写入状态, 决定怎样读出, 像一条直通的残差通道。
这里的状态变量是一组足以概括系统当前信息的变量:给定当前状态和今后的输入,就能确定系统今后的运动。状态表示不一定是最小的,也可能含有冗余;一个线性系统的实现还要同时可控、可观,才能称为最小实现。把状态变量排成向量 ,所有可能的 构成状态空间。
状态的选法并不唯一。同一个电路可以选电容电压和电感电流,也可以选它们的线性组合;只要变换矩阵 可逆,令 ,就得到
两套状态方程外观不同,却描述同一个输入输出系统。这种相似变换不改变系统行为的事实,也解释了深度状态空间模型为什么可以学习一种不必对应具体物理量、但能压缩历史的隐藏状态。
6.1 从 HiPPO 到 S4
谱系是:状态空间法 → HiPPO / LSSL → S4 → S6 / Mamba。HiPPO 用正交多项式理论让有限状态更好地压缩长程历史;S4 又对状态矩阵施加结构,使模型既能写成 RNN 式递推,也能在训练时改写为卷积并行计算。
6.2 选择性扫描
固定参数的 S4 对所有 token 一视同仁,缺少「该记什么、该忘什么」的内容选择能力。Mamba 让 、 和离散步长 随输入变化,由此得到选择性状态空间模型 S6:重要信息写入并长期保留,无关信息快速遗忘。
参数随输入变化后,普通卷积不再适用;Mamba 用并行扫描、CUDA 核融合和反向重计算恢复训练效率。因此它训练时可以并行,推理时只递推一个状态,长序列复杂度接近线性。
课件还列出一组实验性对比:在对应实验配置下,Mamba 的吞吐量可达到 Transformer 的约 5 倍,2.8B 参数模型可与 GPT-J 6B 对比,并展示了超过 100 万 token 的长序列能力。这些数字说明选择性 SSM 的潜力,但会随硬件、实现、任务和比较基线改变,不能当成“任何场景都快 5 倍”的普适定理。
7. 本讲结构
Mamdani:人写规则,后件是模糊集
  → TSK:后件换成函数,输出可微
  → ANFIS:把规则推理摊成可训练网络
  → RBF / MoE / CART / Stacking:共享局部专家加权骨架
→ SSM / Mamba:把控制论状态空间结构嵌进序列模型这些模型共同说明,可解释的先验结构与数据学习并不冲突。下一讲转向连接主义,看神经网络怎样直接从样本学习控制律和序列依赖。