第二次作业 · TransE 知识图谱表示学习
任务说明
基于 OpenKE 实现或复现 TransE,在 FB15K237 数据集上完成训练与推理,并用链接预测指标评估模型。现存提交使用 OpenKE 官方模型、训练器、评测器与 C++ 数据后端,另写训练和测试入口。
查看实现与实验结果
从三元组到向量平移
TransE 把实体和关系嵌入到同一向量空间,并希望成立的三元组 满足
对应的能量函数为
距离越小,三元组越可信。训练时用替换头实体或尾实体的方式构造负例,并用 margin ranking loss 拉开正负样本:
每步还会对实体向量做 归一化,避免仅靠无限放大向量尺度来改变距离。
数据集与实验设置
FB15K237 是 Freebase 子集,并移除了 FB15K 中大量可直接互推的逆关系。
| 项目 | 数量 |
|---|---|
| 实体 | 14,541 |
| 关系 | 237 |
| 训练三元组 | 272,115 |
| 验证三元组 | 17,535 |
| 测试三元组 | 20,466 |
本次实验沿用 OpenKE 的模型、训练器、评测器,以及负责负采样和链接预测的 C++ 后端。Python 脚本负责组装配置和启动训练、评测。
| 超参数 | 本次运行值 |
|---|---|
| 嵌入维度 | 200 |
| 距离范数 | |
| Margin | 5.0 |
| 每个正例的实体负样本数 | 25 |
| 每轮 batch 数 | 100 |
| 负采样 | Bernoulli |
| 已知三元组过滤 | 开启 |
| 优化器 | SGD |
| 学习率 | 1.0 |
| 实际训练轮数 | 250 |
依赖版本为 PyTorch 2.12.0、NumPy 2.4.6、scikit-learn 1.9.0 和 tqdm 4.68.2。
怎样准确复现这组结果
OpenKE 的数据加载和评测使用 C++ 后端,换机器或平台后应先重新编译:
python -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt

cd OpenKE/openke
bash make.sh
cd ../..

python train.py --train_times 250
python test.py
这里必须显式传入 --train_times 250。作业 README 把本次实验写成 250 轮,但 train.py 的参数默认值其实是 1000;训练日志确认结果表来自 250 轮。直接执行不带参数的 python train.py 会跑 1000 轮,不能严格复现下面这组数值。
链接预测怎样评测
对测试三元组 ,评测会分别遮住 和 ,用全部实体逐个替换,再按 TransE 分数排序。常用指标是:
- MRR:正确实体排名倒数的平均值,越大越好;
- MR:正确实体平均排名,越小越好;
- Hit@:正确实体进入前 名的比例,越大越好。
raw 会直接排列全部候选;filter 会去掉数据集中已经成立的其他三元组,避免把另一个正确答案误当作错误候选。因此通常以 filtered 指标作为主要结果,但同时保留 raw 指标便于完整复核。
TransE 实验结果
250 轮 CPU 训练耗时 3,021.1 秒,约 50 分钟;测试集链接预测约需数分钟。完整结果为:
| 设置 | 预测方向 | MRR | MR | Hit@10 | Hit@3 | Hit@1 |
|---|---|---|---|---|---|---|
| Raw | 头实体 | 0.0887 | 562.68 | 0.2064 | 0.0861 | 0.0332 |
| Raw | 尾实体 | 0.2490 | 163.78 | 0.4386 | 0.2734 | 0.1555 |
| Raw | 平均 | 0.1689 | 363.23 | 0.3225 | 0.1798 | 0.0943 |
| Filtered | 头实体 | 0.1856 | 313.26 | 0.3540 | 0.2085 | 0.1022 |
| Filtered | 尾实体 | 0.3825 | 138.54 | 0.5885 | 0.4351 | 0.2744 |
| Filtered | 平均 | 0.2840 | 225.90 | 0.4713 | 0.3218 | 0.1883 |
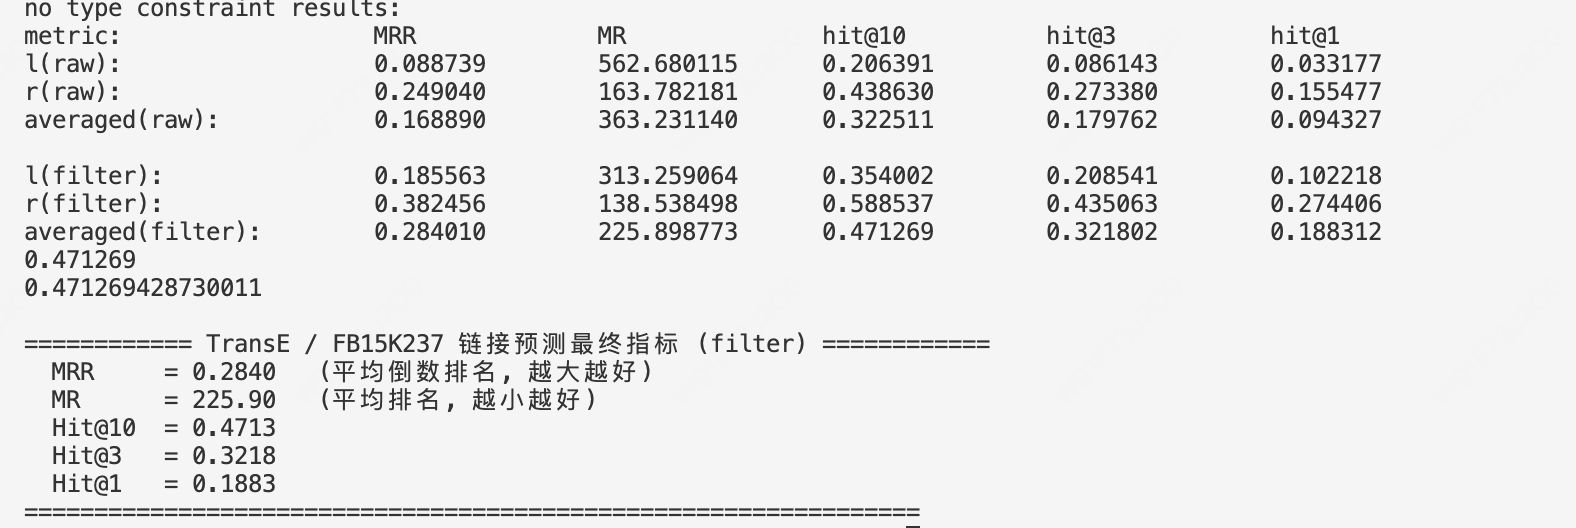
图:250 轮训练后,OpenKE 输出的 raw 与 filtered 链接预测结果。
这次运行中,预测尾实体明显优于预测头实体,例如 filtered Hit@10 分别为 0.5885 和 0.3540。这说明两个预测方向在该数据和模型下难度并不对称;关系的基数结构、候选歧义和 TransE 的表达能力都可能影响差异,不能仅凭这一张表把原因绝对归结为“数据大多是一对多”。
另一个边界是:这组结果只能证明当前 OpenKE 配置和 250 轮运行得到上述指标。它不等于完成了不同实现、随机种子或训练轮数之间的严格基准比较。