第二讲 · 符号主义:专家系统与专家控制
对应 PPT:第二讲《专家系统》 专家系统采用一条很直接的路线:把人类专家的经验写成规则,让机器按规则推理。
1. 历史定位:符号主义
专家系统是符号主义学派的代表。符号主义认为,智能可以用符号、规则和逻辑显式表达。上世纪 80 年代 AI「第二次崛起」的三件标志性事件中,第一件就是专家系统(代表人物 Edward Feigenbaum,「专家系统之父」,1994 年图灵奖);另外两件是 Hopfield 网络(1982)和 BP 算法(1986),第五讲会放在连接主义里介绍。
AI 关键历史节点(背景时间线):
1950 图灵《计算与智能》 → 1956 达特茅斯会议 → 1957 感知机
  → 1974 第一次低谷 → 1980 XCON → 1982 Hopfield → 1987 第二次低谷
  → 1997 深蓝 → 2006 Hinton 深度学习 → 2011 Watson → 2016 AlphaGo
2. 核心思想:把经验写成规则
专家系统可以概括为:把专家经验写成 IF-THEN 规则,再由推理机循环匹配规则。
以自动驾驶为例,规则本质上就是「人类驾驶经验的形式化」:
规则1: IF 前方检测到红灯       THEN 减速并停车
规则2: IF 前方车距 < 安全距离   THEN 降低车速
规则3: IF 行人进入车道 THEN 紧急制动工作流程(正向推理):环境感知 → 形成事实 → 匹配规则 → 产生控制决策。扫地机器人的推理机本质就是个无限循环:
while Robot_is_Running:
    front = read_sensor("Front")
    left  = read_sensor("Left")
    if front == CLEAR:
        execute_action("前进")
    elif front == BLOCKED and left == CLEAR:
        execute_action("左转")
    else:
execute_action("后退并调头")专家系统的行为完全由规则库决定:规则没有覆盖的情况,系统就无法据此做出可靠判断。这也是知识获取和规则维护困难的直接原因。
3. 结构:知识库 + 推理机
专家系统主要由两大件构成:
- 知识库(Knowledge Base):存知识。包含三类——基于专家经验的判断性规则、用于推理的控制性规则、说明问题状态的数据。
- 推理机(Inference Engine):利用知识库中的规则和事实推导结论。
发展三阶段:初创期(1965–1971,DENDRAL 化学分子结构、MACSYMA 数学)、成熟期(1972–1977,MYCIN 血液感染诊断、HEARSAY 语音)、发展期(1978 至今)。
3.1 一套完整专家系统怎样建立
真实工程不只有两个方框。知识库内部还要分成规则库和数据库,并提供查询、检索、增删、修改和扩充;推理机内部包含解释程序和调度程序。系统一端通过知识获取接口向领域专家收集经验,另一端通过咨询接口向用户提问、给结论并解释理由。
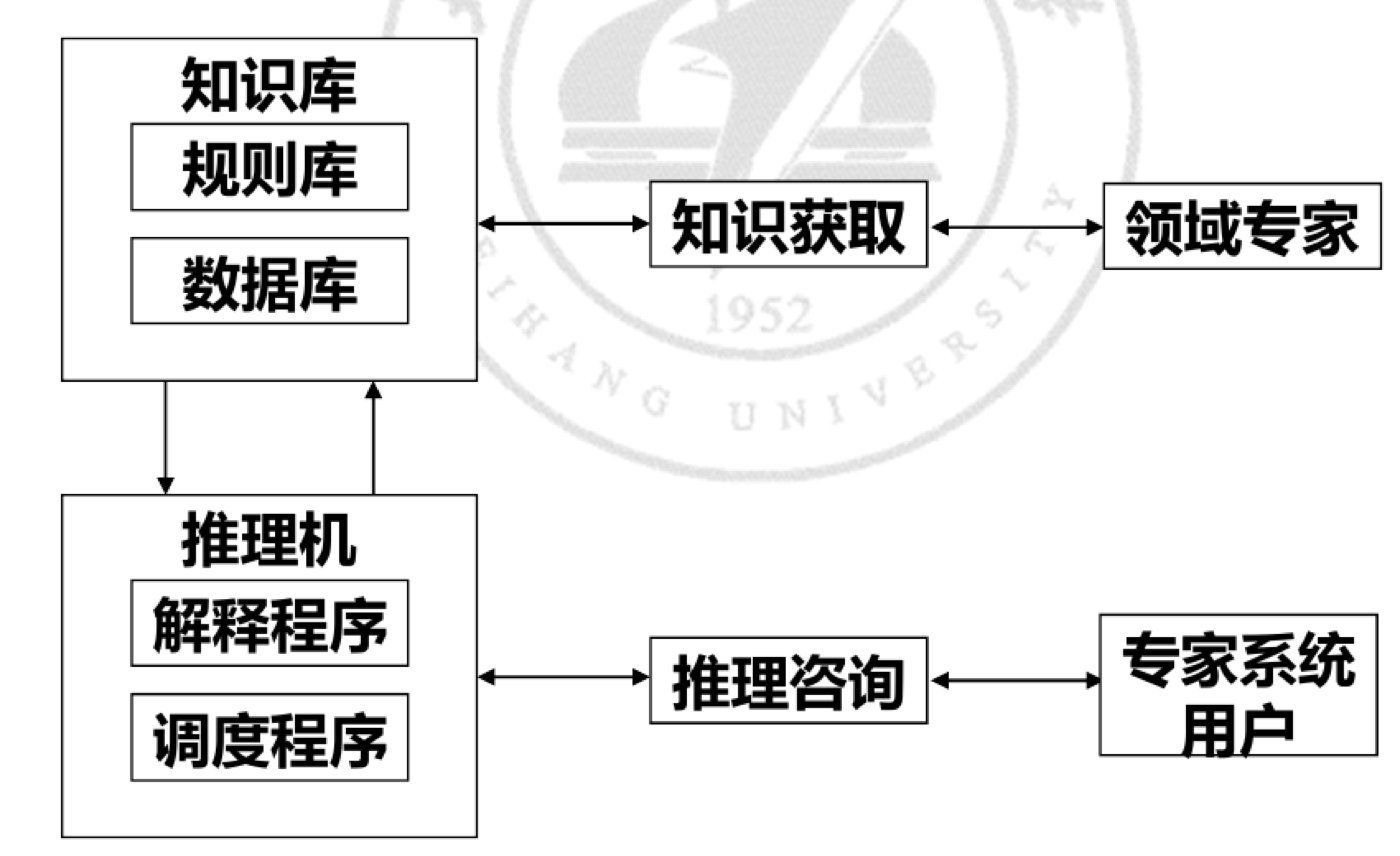
建立过程可以按三层设计:
- 知识库:先区分叙述性、过程性和控制性知识,再选择表示方法,并实现规则的保存、编辑、删除、增加和搜索;
- 推理机:选择正向、反向或双向推理,再选深度优先、广度优先或启发式搜索等算法;
- 人机接口:用户接口负责咨询理解和结论解释,专家接口负责知识扩充与系统维护。
开发时既可以直接使用 C、Prolog、Lisp 等语言,也可以使用已有的专家系统“空壳”:框架已经带好知识表示和推理机,只需装入领域知识。
4. 三种推理方式
- 正向推理:从已知条件出发往前推得到结论(数据驱动)。扫地机器人是正向推理。
- 反向推理:先提出假设结论,再找支持证据;证据存在则假设成立(目标驱动)。MYCIN 是反向推理。
- 双向推理:用正向推理提出假设,再用反向推理证实。
5. 知识表示与确定性因子 CF
知识表示方法有产生式规则(最流行)、框架、语义网络、过程。产生式规则的标准形式:
IF E THEN H WITH CF(E,H)E 是前提(证据),H 是结论(假设),CF 是规则强度。
确定性因子 CF(Certainty Factor) 用来处理专家知识中的不确定性。医学诊断、机器人感知等判断往往不是绝对确定的,可以用 CF 量化可信度:
完全确定, 不确定, 完全否定。例:IF 病人持续高烧 THEN 可能细菌感染,可信度约 70%,即 。CF 让专家系统能处理不确定知识——这是它比纯逻辑系统强的地方,也是 MYCIN 的首创贡献。
6. 从「专家系统」到「专家控制」
K. J. Åström(瑞典)1983 年把专家系统引入控制领域,1986 年提出「专家控制(Expert Control)」。形象地说——在传统控制基础上「加入」一个富有经验的控制工程师。
课件重点比较了专家控制与专家系统:
| 维度 | 专家系统 | 专家控制 |
|---|---|---|
| 任务 | 辅助用户决策 | 独立、实时的自动决策 |
| 工作方式 | 离线 | 在线(需在线获取反馈) |
| 可靠性 / 抗干扰 | 一般 | 要求更高 |
一句话记忆:专家系统是「顾问」,专家控制是「司机」——顾问可以慢慢想,司机必须实时闭环。
按作用分两类:直接型专家控制器(直接取代常规控制器,模拟「操作工人」,专家 PID 属此类)和间接型专家控制器(与常规控制器结合做高层决策,模拟「控制工程师」,又分优化型 / 适应型 / 协调型 / 组织型)。
6.1 专家控制的知识怎样组织
专家控制要同时保存对象与控制两侧的知识:对象知识包括开环特性等先验知识和运行中间状态等动态知识;控制、辨识和诊断知识又分成算法形式的定量知识与经验、逻辑、直觉形式的定性知识。数据库进一步按推理层级组织为:
- 事实:传感器误差、报警阈值、操作约束等静态数据;
- 证据:带噪声、延迟甚至互相冲突的实时测量;
- 假设:由事实和证据推出的状态估计等中间结果;
- 目标:稳定性、工作点寻优和控制律是否要调整等性能要求,可预先给定,也可在线生成。
这套系统既能利用先验知识,也能通过增加规则积累经验,还能用“超调小”“偏差增大”等定性语言描述和解释性能,并从闭环故障中获取新规则。间接型控制器的运行方式也不同:优化型、适应型通常要在线实时运行;协调型、组织型可以离线充当计算机辅助系统。
落地的四个关键问题是:怎样表示知识、怎样从传感器识别定量信号、怎样把定性经验变成控制量、怎样持续获取规则。由此得到它的三项工程特点:灵活性、适应性、鲁棒性。
7. 专家 PID 控制
思想:基于受控对象和控制规律的各种知识,无需精确模型,用专家经验来设计 / 整定 PID 参数。它是一种直接型专家控制器。
7.1 回顾 PID
控制问题就是让某个量(车速、温度、位置)达到目标。定义误差 目标值 当前值, 是第 个采样时刻的误差。控制器要根据误差算出控制量 (油门、电压、阀门开度),把误差压到 0。PID 用三个视角看误差:
- P 比例:误差现在多大,大就使劲。像「离目标还远,踩深油门」。
- I 积分:误差累计了多久,专治「持续的小误差」(如上坡总差 2 km/h 到不了目标)。累加历史误差、持续加码直到误差归零,消除稳态误差。
- D 微分:误差变化多快,预测性地防冲过头。像「快到目标了提前收油」。
连续时间形式:
7.2 数字化:位置式与增量式
计算机每隔采样周期算一次,把积分换成求和、微分换成差分,得到位置式 PID:
位置式直接计算控制量的绝对值。实现时可以维护一个累计积分状态,不必保存全部历史误差;但执行器饱和后,积分状态仍可能继续增长,形成积分饱和。
增量式的巧思:不算「 该是多少」,只算「这一步 要增减多少」,即 。把 和 两式相减,三项各自变成:
- P 项 →
- I 项 → (两次累计和相减后只剩当前误差,但输出 仍会逐步累积)
- D 项 →
合起来:
每一项现在读作: 是误差这一步变化了多少(一阶差分); 是当前误差本身; 是误差的二阶差分(误差曲线的弯曲 / 加速度)。
增量式只需最近几个误差就能计算 ,而且直接给出控制量的变化,适合阀门、步进电机等增量执行场景。但 由 累加得到,所以它不会自动消除积分饱和,一次错误增量也可能保留在后续输出中。实际实现仍需输出限幅、积分分离或反算等 anti-windup 机制;手自动切换时也要让内部状态与当前执行器输出对齐,才能做到无扰切换。
7.3 专家 PID 的 5 种情况
专家 PID 观察典型二阶系统阶跃响应的误差曲线,按误差大小与变化趋势分 5 种情况切换控制策略(设阈值 ,极小误差界 )。记 :
- 误差极大:。不管趋势,输出取最大 / 最小(开环 bang-bang),以最快速度把误差拉回。
- 误差在恶化:(误差正朝绝对值增大方向走)。若 → 强控制,增量乘放大系数 ;若 → 一般控制,用标准增量 PID。
- 误差在好转: 且 。保持输出不变 ,别去干扰这个好趋势。
- 误差处于极值(拐点): 且 。若 → 较强控制 ;若 → 较弱控制 (, 为误差极值)。
- 误差极小:。加入积分作用,消除稳态误差。
核心直觉:误差大→猛踩(甚至开环全力),误差在变好→别乱动,到极值→适度修正,误差很小→用积分抹平静差。这正是一个老司机的「手感」,被翻译成了 5 条规则。
8. 四大经典案例
| 系统 | 团队 / 年代 | 领域 | 亮点 |
|---|---|---|---|
| XCON | CMU / 1980 | DEC 计算机配置 | 第一个深度商用成功;正向推理;约 1 万条规则;准确率 >95%;年省约 4000 万美元 |
| MYCIN | 斯坦福 / 1970s | 血液感染诊断 | 首创确定性因子 CF;反向推理;首次实现「知识库与推理机分离」;因法律 / 伦理未临床 |
| PROSPECTOR | 斯坦福研究所 | 地质探矿 | 概率推理;1980 发现钼矿,价值约 1 亿美元;AI 首次在非学术领域产生巨大直接经济效益 |
工业案例 LINKMAN(英国蓝圈水泥,1980s):把老师傅「看火」经验提成规则,如 IF 烧成带温度下降 AND 尾气氧含量偏高 THEN 增加煤粉进给量,是「专家系统 + 自动控制」结合最成功的早期工业案例。
MYCIN 的故事很有教益:技术成功 ≠ 能落地——它输在了「误诊责任归属」这类社会 / 伦理问题上(呼应第九讲安全与伦理)。
9. 专家系统的局限与后续发展
三个根本困境:
- 知识获取困境:专家的隐性经验(直觉、手感)「只可意会,不可言传」,转成严谨的
IF-THEN极其困难。 - 缺乏泛化能力:规则库没覆盖的情况就不会处理,不能举一反三。
- 难扩充维护:规则从几十条涨到数万条,新规则极易与旧规则逻辑冲突。
2006 年后,AI 主流范式逐渐从「人工编写规则」转向「从数据中学习规律」。专家系统并没有消失:在自动驾驶底层安全策略、医疗核心诊断等高安全领域,显式规则仍可作为确定性的安全约束,并与深度学习结合成神经符号系统(Neuro-Symbolic)。
专家的经验很难完整写成规则,这个「知识获取困境」限制了符号主义方法。下一讲用连续隶属度表达模糊经验,第五讲则转向从数据中学习规则。
下一讲:模糊逻辑——把「温度有点高就把阀门关小一点」这种模糊话,量化成机器能算的控制律。