第八讲看起来塞满了不同领域的模型,其实全部在重复同一种求解动作:先求后行动者在每种历史下的最优反应,再让先行动者预见这些反应并选择第一步。
一、所有模型共用的逆向结构
一个典型两阶段模型可以写成:
- 参与人 1 先选择 x;
- 参与人 2 观察 x 后选择 y;
- 收益为 u1(x,y) 与 u2(x,y)。
求解时先得到参与人 2 的反应函数
y∗(x)∈argymaxu2(x,y),
再把它代回参与人 1 的问题:
x∗∈argxmaxu1(x,y∗(x)).
最后得到的完整策略不只是 y∗,而是整条函数 y∗(x):参与人 2 必须说明观察到每一种 x 时分别怎样回应。
二、Stackelberg:先动者如何利用反应函数
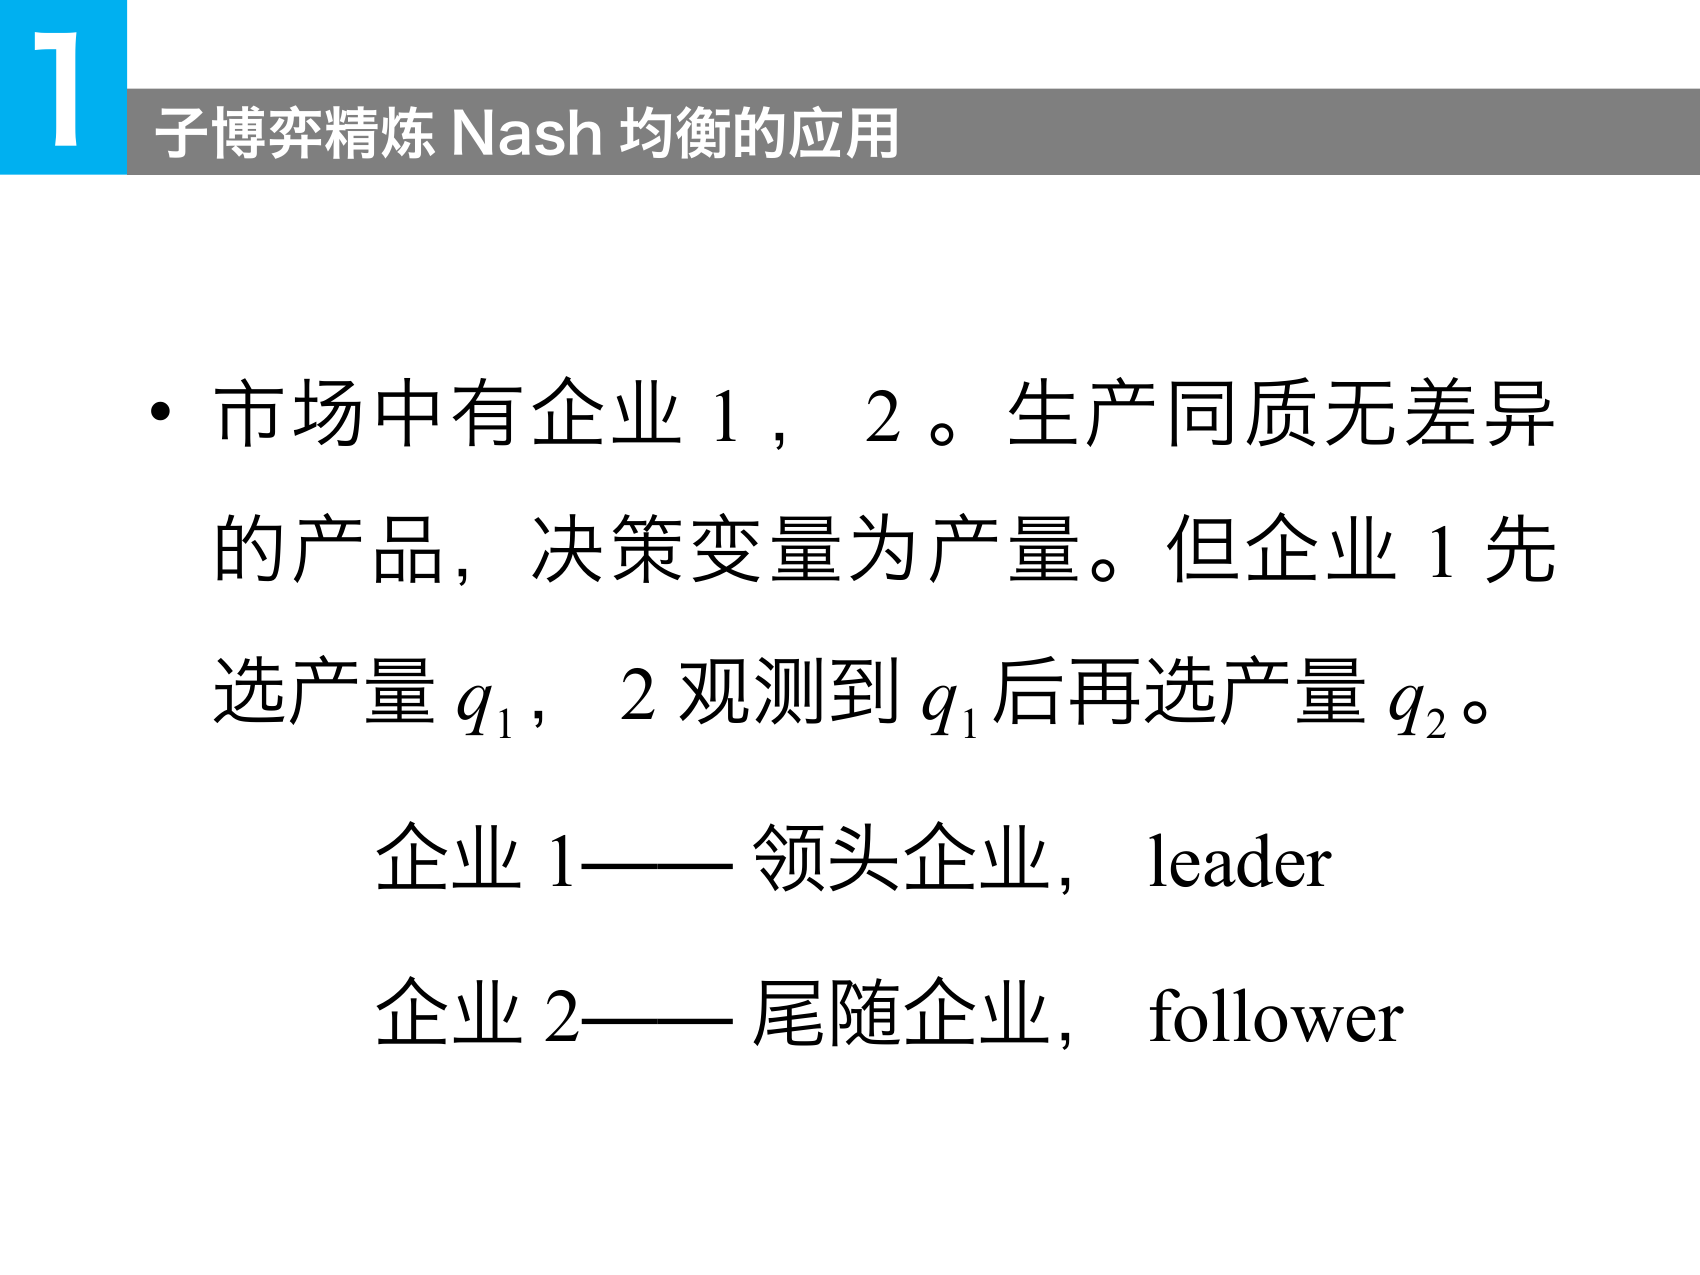
两家企业生产同质产品。企业 1 先选产量 q1,企业 2 观察后选 q2。
设市场需求和成本为
P=a−(q1+q2),Ci=cqi.
企业 2 给定 q1 后最大化
π2=q2(a−c−q1−q2),
所以反应函数为
q2(q1)=2a−c−q1.
企业 1 预见该反应,最大化
π1=q1(a−c−q1−2a−c−q1),
得到
q1∗=2a−c,q2∗=4a−c.
相应利润为
π1∗=8(a−c)2,π2∗=16(a−c)2.
Cournot 同时行动时两家各生产 (a−c)/3。Stackelberg 领头企业主动扩大产量,迫使跟随者沿反应函数缩小产量,因此获得先动优势。
先动本身不保证有利。只有当先动者能公开、不可撤回地承诺自己的选择,并且对手的最优反应有利于先动者时,优势才成立。
三、Leontief 劳资谈判:先定工资,再定就业
工会先提出工资 w,企业观察后决定就业量 L。课件设工会效用为
U(w,L),Uw>0,UL>0,
企业利润为
π(w,L)=R(L)−wL,R′(L)>0,R′′(L)<0.
先求第二阶段。给定工资 w,企业选择 L 最大化利润,一阶条件是
R′(L∗(w))=w.
由于 R′′<0,对上式求导可得
dwdL∗(w)=R′′(L∗(w))1<0.
这就是企业向下倾斜的劳动需求:工资越高,企业选择的就业量越少。
工会预见这条反应函数,在第一阶段求
w≥0maxU(w,L∗(w)).
内部解满足
Uw+ULdwdL∗(w)=0,
也就是工会无差异曲线与企业劳动需求曲线相切。工资和就业的权衡不是口头描述,而是由企业后手反应 L∗(w) 进入工会的一阶条件。
四、关税与国际市场:先制定规则,再让企业竞争
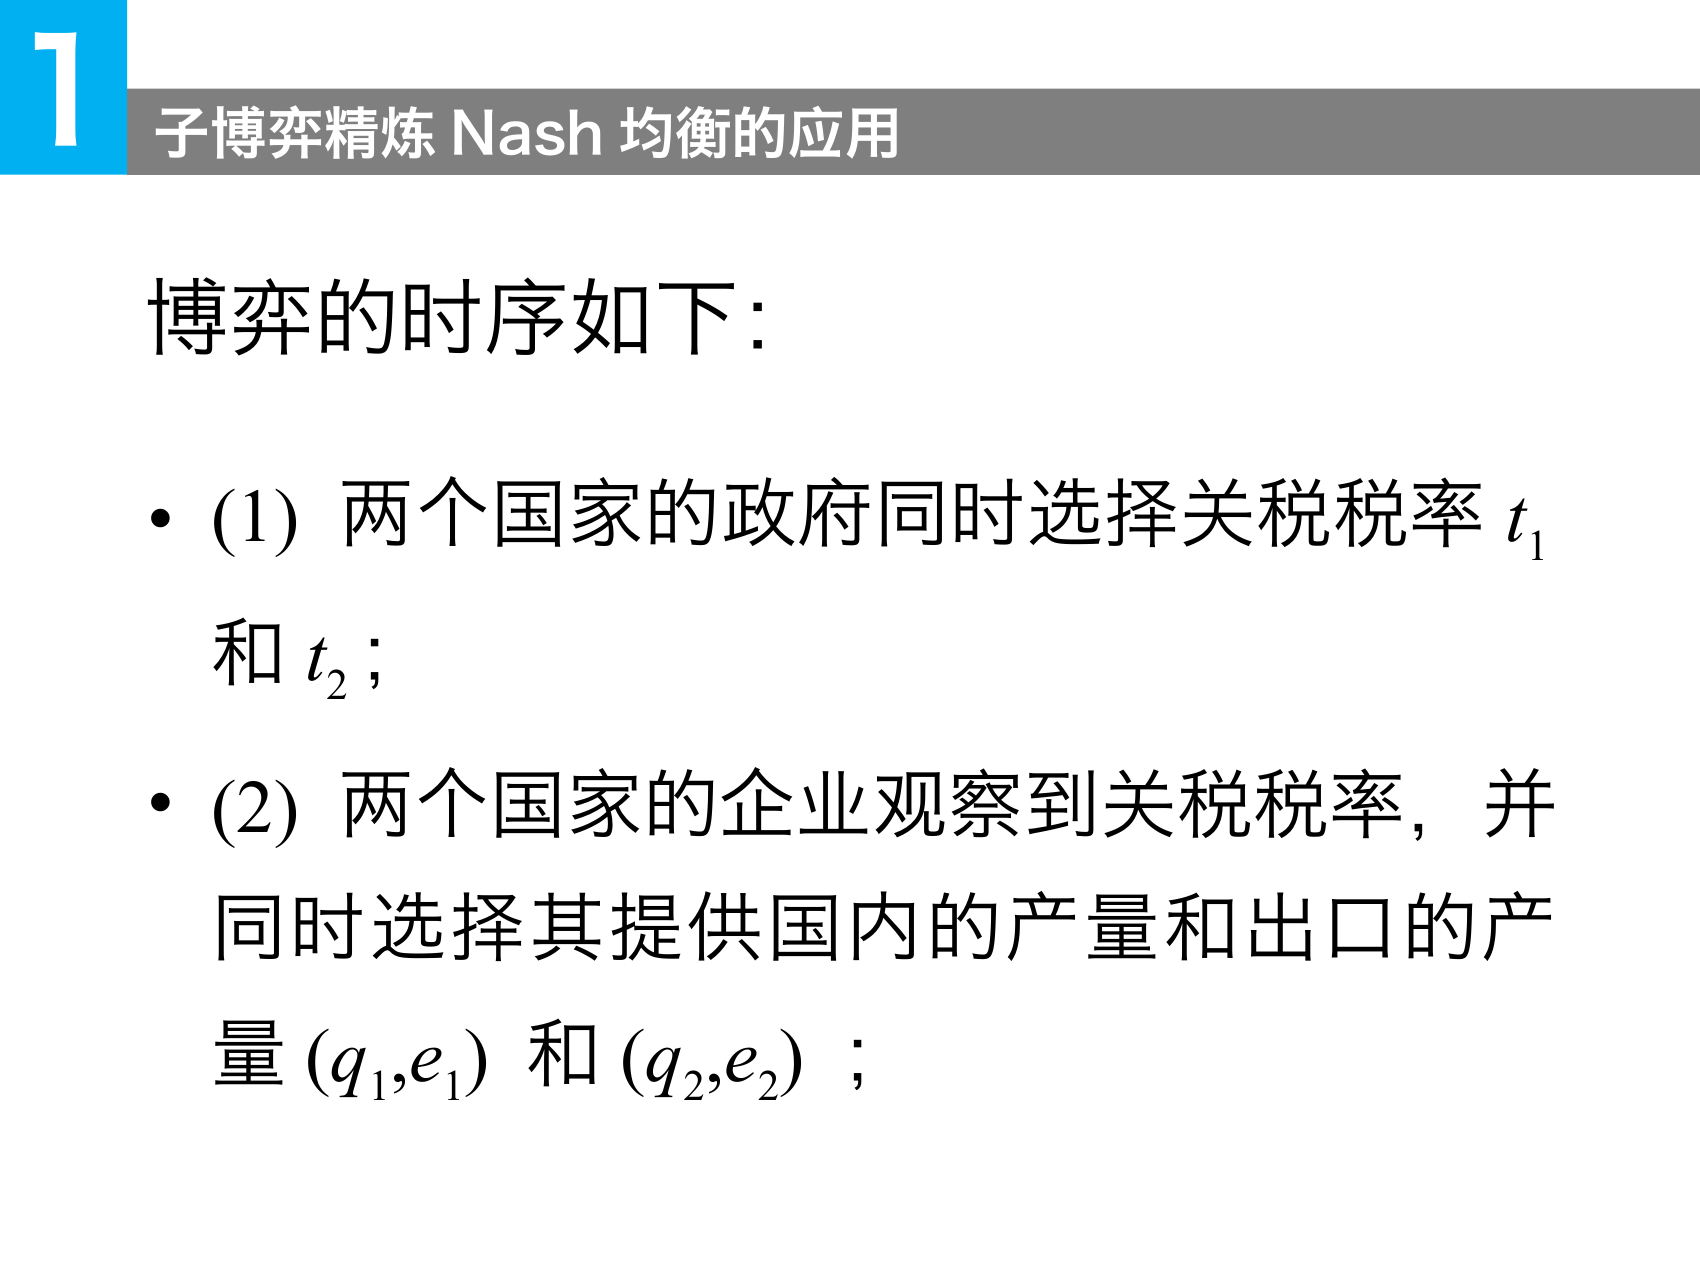
课件中的时序是:
- 两国政府同时选择关税;
- 企业观察关税;
- 企业再同时选择产量。
求解仍然从企业开始:给定关税,先求企业在国际市场上的产量 Nash 均衡;政府再预测该均衡如何随关税变化,并选择使本国福利最大的税率。
课件假设国家 i 的企业向本国销售 qi、向外国出口 ei,边际成本为 c。国家 i 的市场总量和逆需求是
Qi=qi+ej,Pi(Qi)=a−Qi.
国家 i 对进口商品征收单位关税 ti。企业 i 的利润为
πi=[a−(qi+ej)]qi+[a−(qj+ei)]ei−c(qi+ei)−tjei.
给定两国关税,企业的一阶条件给出反应函数
qi∗=2a−ej−c,ei∗=2a−qj−c−tj.
联立两家企业的反应函数可得
qi∗(ti)=3a−c+ti,ei∗(tj)=3a−c−2tj.
本国福利包括消费者剩余、企业利润和关税收入:
gi=2Qi2+πi+tiej.
政府把第二阶段均衡代入 gi 再选择 ti,得到非合作最优关税
ti∗=3a−c.
对称均衡中
qi∗=94(a−c),ei∗=9a−c.
若两国共同最大化 g1+g2,最优选择却是 t1=t2=0。单个政府把关税对外国一侧造成的损失排除在自己的目标之外,两国都这样做就形成类似囚徒困境的政策低效率。
五、工作竞赛:企业先设计奖金,工人再努力
企业不知道每位工人的精确产出噪声,但可以按相对排名发奖金。时序是:
- 企业设计第一名和第二名的报酬;
- 工人观察奖金差距后选择努力;
- 随机产出实现,企业按排名支付报酬。
工人 i 的期望收益可以写成
(wH−wL)Pr{yi(ei)>yj(ej)}+wL−g(ei),
其中产出为
yi=ei+εi,
ε1,ε2 独立同分布,g(e) 是努力成本。工人的一阶条件是
(wH−wL)∂ei∂Pr{yi(ei)>yj(ej)}=g′(ei).
所以真正刺激努力的是奖金差
Δw=wH−wL,
而不是工资整体平移。在对称均衡 e1=e2=e∗ 中,每位工人胜出的概率为 1/2;若外部机会收益为 Ua,参与约束是
21wH+21wL−g(e∗)≥Ua.
企业再选择 wH,wL 最大化
2e∗(wH,wL)−wH−wL,
并在最优解处把参与约束压到等号。这样就把“先设计奖金、后选择努力”的两阶段结构完整写了出来。
该模型解释了晋升竞赛和绩效排名,也提醒我们:奖金差过大可能诱发破坏合作、过度冒险或只优化排名指标。
六、投票次序:议程本身就是策略
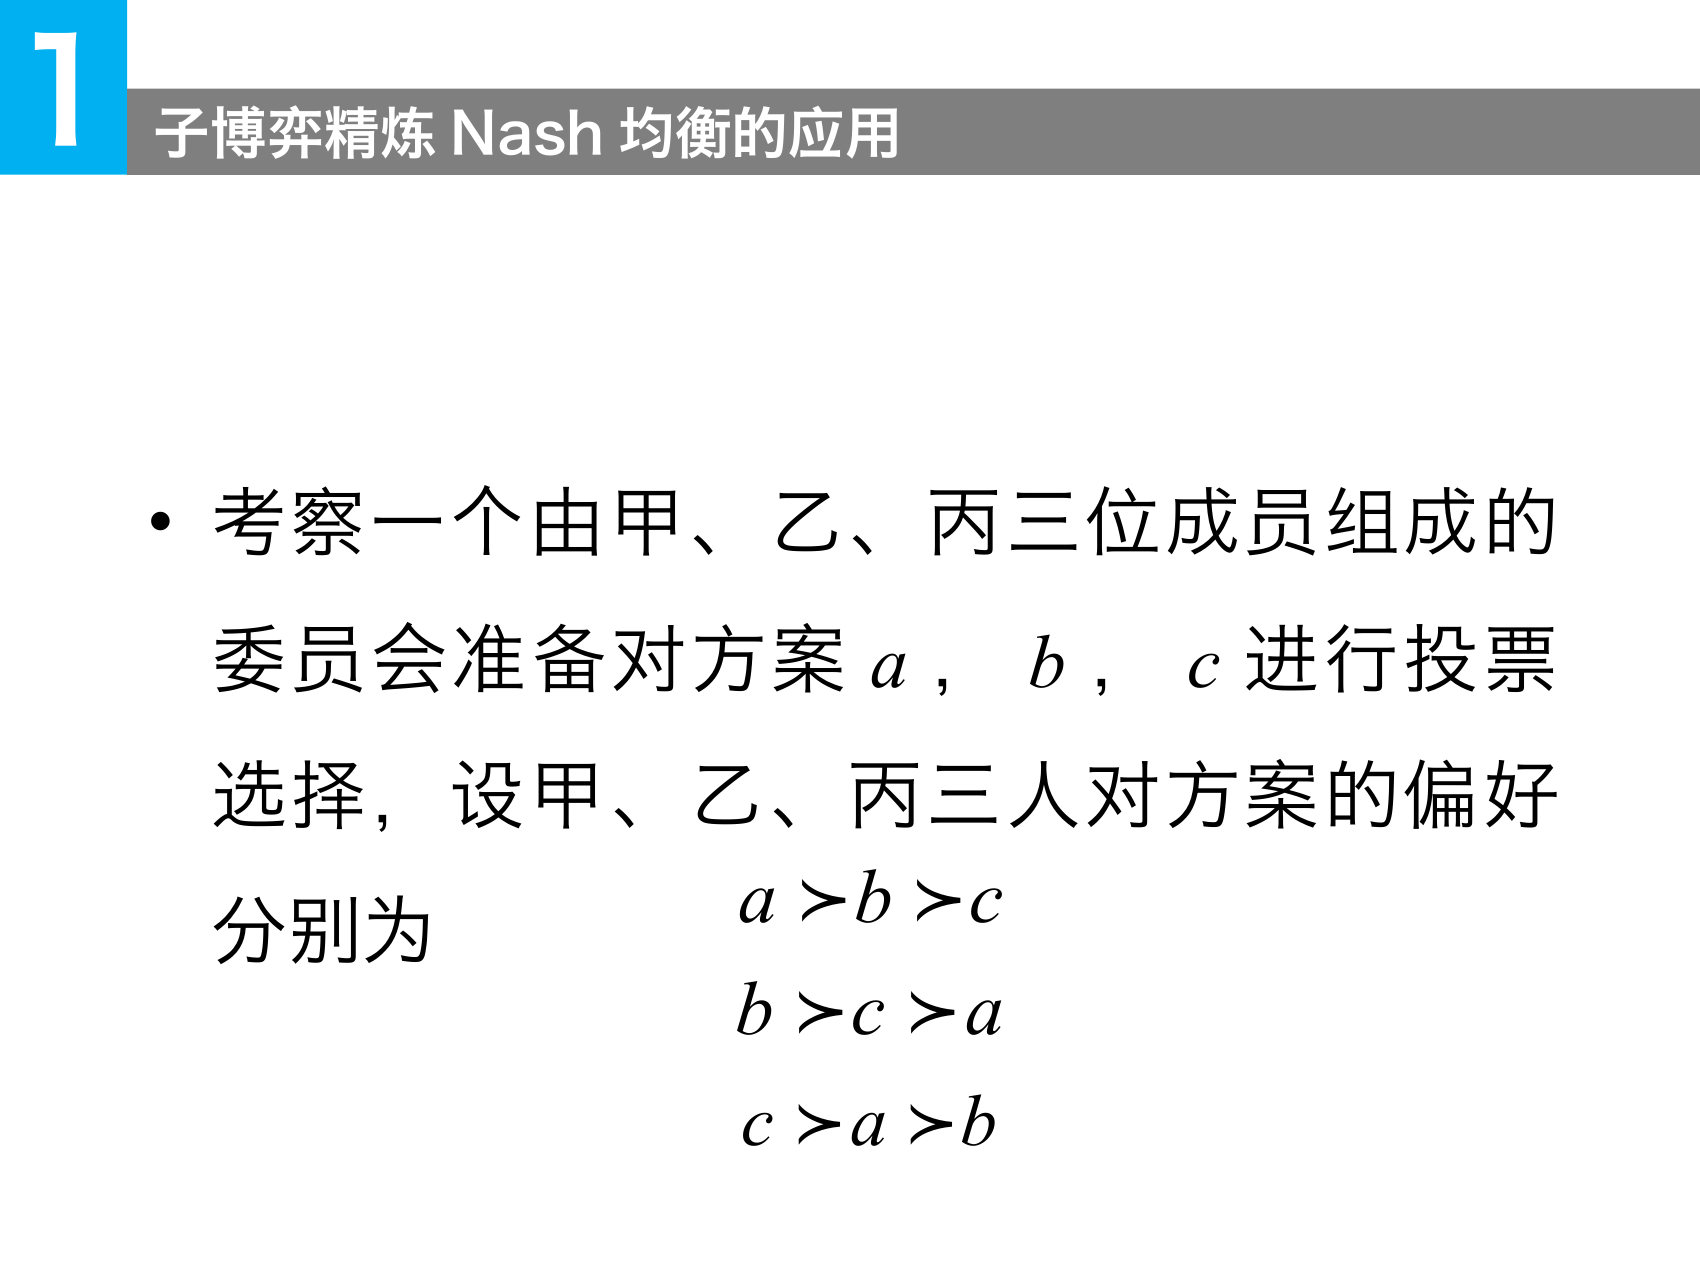
三名成员在 a,b,c 三个方案间投票,偏好可能形成循环:
a≻b,b≻c,c≻a.
这时不存在一个方案能在两两多数决中击败所有其他方案,最终结果会依赖先比较哪两个、胜者再与谁比较。
若议程已经公开,而且每位成员能预见后一轮,他不会只按当前两方案的直接偏好投票,而会考虑当前胜者在下一轮面对谁。求解方法仍是逆向归纳:
- 先求最后一轮两方案中谁会胜;
- 回到前一轮,成员比较的不是眼前方案,而是它们分别会导致的最终结果;
- 议程设置者可以利用这种预见能力影响结果。
用一个三人例子可以直接看出战略投票。设三人的偏好分别为
1:a≻b≻c,2:b≻c≻a,3:c≻a≻b.
于是两两多数关系为 a≻Gb、b≻Gc、c≻Ga。若议程是先比较 a,b,胜者再与 c 比较:
- 如果第一轮所有人按眼前偏好投票,a 先胜 b,第二轮却输给 c,最终是 c;
- 玩家 1 预见到这个结果后,会在第一轮改投自己较不喜欢的 b,因为 b 下一轮能击败他最不喜欢的 c;
- 玩家 1、2 共同使 b 在第一轮获胜,随后 b 再以多数击败 c,最终结果变为 b。
因此“越晚进入议程越有利”只在成员按真实偏好逐轮投票时成立;偏好成为共同知识后,逆向归纳会诱发战略投票,结论可能改变。
所以制度设计不能只规定“多数决定”,还必须规定提案权、表决顺序、修正案规则和是否允许战略投票。
七、五个模型的共同结构
| 模型 | 第一阶段 | 第二阶段 | 核心效应 |
|---|
| Stackelberg | 领头企业定产量 | 跟随者定产量 | 可观察承诺带来先动优势 |
| 劳资谈判 | 工会定工资 | 企业定就业 | 工资与就业的内生权衡 |
| 关税 | 政府定政策 | 企业定产量 | 政策外部性造成低效率 |
| 工作竞赛 | 企业定奖金 | 工人定努力 | 奖金差塑造激励 |
| 投票次序 | 设定议程 | 成员逐轮表决 | 程序顺序改变最终选择 |
遇到新的动态应用时,不必先背它属于哪个著名模型。只要把时间顺序画清楚,先求后手反应,再代回前手问题,复杂故事就会还原成同一个 SPNE 求解框架。