第九讲 · 主存储器与 Cache
对应材料:2025 计组复习提纲“主存储器”“高速缓存”,并参考实验 6 的 Cache、RAM 与 LRU 电路。
存储系统一直在解决同一组矛盾:容量大、速度快、成本低,无法同时做到。主存用 DRAM 提供容量,Cache 用更快的 SRAM 保存近期最可能访问的数据,让 CPU 大多数时候不用等主存。
1. 存储芯片的容量写法
芯片容量常写成
例如 1K×4 表示 1024 个可寻址字单元,每个单元 4 bit:
- 地址线数:;
- 数据线数:4;
- 总位容量: bit。
“1K×4”和“4Kb”总位数相同,却强调了不同的外部接口组织。做芯片扩展题时,必须先看字数和字长,不能只看总 bit。
2. SRAM 的一维与二维组织
2.1 一维地址结构
若 1024×2 的 1024 个字都由一个 10-1024 译码器直接选中,就是一维组织。概念简单,但译码器扇入、布线和矩阵长宽都不理想。
2.2 二维地址结构
课件以 4096×4 SRAM 为例:总共有
个位单元,可排成 矩阵。12 位字地址拆成:
- 7 位行地址:128 选 1,先选一整行;
- 5 位列地址:从这一行的 32 个四位字中再选 1 个。
二维结构把一个巨大的译码问题拆成行、列两级,减少布线长度和译码复杂度。
3. DRAM:密度更高,但必须刷新
SRAM 单元用触发结构维持状态,只要供电就能保持;DRAM 单元主要靠电容保存电荷,电荷会泄漏,所以要周期性刷新。
课件的 4096×4 DRAM 仍有 12 位字地址,但把行、列地址分时复用在同一组 6 根地址线上:
- 地址线上先给行地址,用 RAS 锁存;
- 再给列地址,用 CAS 锁存;
- 用 WE/OE 等信号控制读写。
这样减少了封装引脚,代价是访问时序更复杂。
刷新按行进行,本质上是把一行读出并恢复。课件列出三种安排:
- 集中式:正常访问一段时间后,集中刷新全部行;会出现一段较长“死区”;
- 分散式:每次正常访问后都安排一次刷新,死区分散但持续占用带宽;
- 异步/分布式:在刷新周期内均匀插入各行刷新,兼顾最长刷新间隔与可用带宽。
4. 用小芯片组成大存储器
4.1 位扩展:字数不变,字长增加
用两个 1K×4 组成 1K×8:
- 两片地址线、读写控制并联;
- 一片接数据总线低 4 位,另一片接高 4 位;
- 两片同时选中。
片数为
4.2 字扩展:字长不变,字数增加
用四个 1K×8 组成 4K×8:
- 低 10 位地址接到每一片内部地址;
- 新增的高 2 位地址送 2-4 译码器;
- 每次只使能其中一片。
片数为
4.3 混合扩展
用 4K×4 组成 16K×8:
先画“每组两片并联扩位”,再画“四组由高位地址译码选片”,比直接画八片不容易乱。
5. CPU 与主存连接
连接时逐项核对:
- CPU 低位地址接芯片内部地址;
- CPU 高位地址经译码产生片选;
- 数据总线按位宽并联;
- 读写控制接到对应使能端;
- 列出每片或每组的起止地址。
若一个芯片组含 个按字节编址单元,它占用连续 字节,最低 位用于片内寻址,高位决定落在哪个组。地址范围题最稳妥的做法是把高位片选编码与低位全 0/全 1 直接拼接。
6. 为什么 Cache 有效:局部性
程序访问不是随机撒点:
- 时间局部性:刚访问过的数据/指令很可能再次访问,例如循环变量;
- 空间局部性:访问某地址后,很可能访问附近地址,例如顺序数组和指令流。
Cache 不只装“这一个字”,而从主存搬入一个连续数据块(block)。一次缺失代价较高,却可能让后续邻近访问连续命中。
7. Cache 的基本结构与术语
一条 Cache 行通常包含:
Valid:这一行是否装有有效内容;Tag:它对应哪个主存块;Data:整块数据;- 组相联设计还需要替换状态;支持写回时还可能有
Dirty。
性能量:
命中直接从 Cache 取;缺失则从下一级取回整块、放入 Cache,再完成当前访问。
8. TIO:地址为何拆成 Tag、Index、Offset
设:
- 主存地址宽度为 bit;
- Cache 数据容量为 byte;
- 块大小为 byte;
- 相联度为 路。
则:
- Offset 选块内字节;
- Index 选 Cache 组;
- Tag 与该组保存的标记比较,确认是不是所需主存块。
9. 直接映射
直接映射是 1 路组相联:每个主存块只能去一个固定 Cache 行。
访问步骤:
- 用 Index 定位唯一 Cache 行;
- 检查 Valid;
- 比较地址 Tag 与行内 Tag;
- 命中后用 Offset 选块内字节或字。
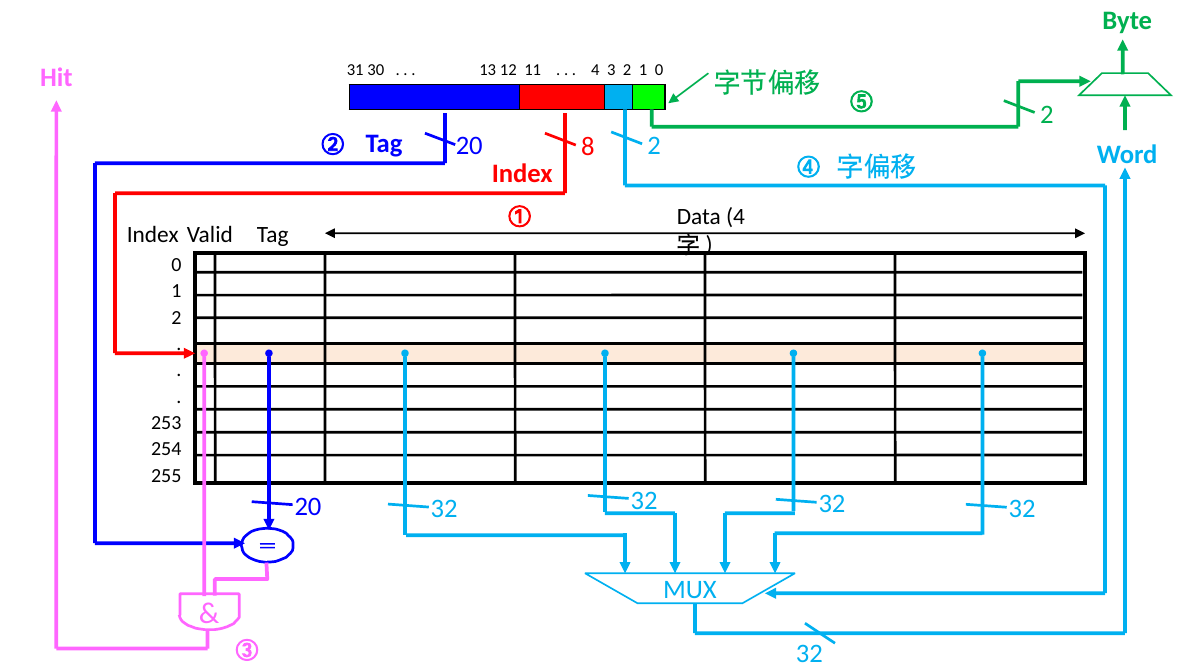
图截自 2025 复习提纲的 Cache 结构主体。红色 Index 选行,蓝色 Tag 做比较,青色/绿色 Offset 依次选择字和字节。
9.1 图中参数怎么算
32 位地址、4 KB Cache、16 B 块、直接映射:
所以地址正好分成 Tag(20) | Index(8) | Offset(4)。
10. Cache 实际存储容量
题目口头说“16 KB Cache”,通常只指数据容量,不含 Tag 和状态位。课件例题:直接映射、数据容量 16 KB、每块 4 个 32 位字、32 位地址,每行 1 位 Valid。
- 每块数据: bit B;
- 行数:;
- Offset: bit;
- Index:10 bit;
- Tag: bit;
- 每行总位数: bit;
- 实际总存储: bit。
如果还有 Dirty、替换状态或校验位,也要继续加。先算“每行有什么”,再乘行数最不容易漏。
11. 全相联与组相联
11.1 全相联
主存块可以放任意一行:
- 没有 Index;
- 地址只有 Tag 和 Offset;
- 必须同时比较所有行的 Tag;
- 冲突少,但比较器数量、选择逻辑和功耗都高。
11.2 路组相联
主存块先由 Index 定位一组,再可放组内任意一路:
访问时并行比较该组 个 Tag,再由命中路选择数据。直接映射是 1 路,全相联是只有 1 组的极端情况;组相联在冲突率与硬件成本之间折中。
相联度提高时,组数减少、Index 变短、Tag 变长;组内还需要 LRU、伪 LRU、FIFO 或随机等替换策略。直接映射没有替换选择,因为每个主存块只有一个位置。
12. 三类 Cache 缺失
| 缺失 | 原因 | 主要改进方向 |
|---|---|---|
| Compulsory | 第一次访问该块,Cache 不可能已有 | 预取、适当增大块 |
| Capacity | 工作集超过总容量 | 增大 Cache、改善程序局部性 |
| Conflict | 多个活跃块争同一组 | 提高相联度、改善地址布局 |
直接映射中两个主存块若 Index 相同,会反复把对方替掉,形成“乒乓”。从直接映射提升到 2 路组相联通常能获得最显著的一步改善,此后继续提高相联度收益递减而成本上升。
13. 块大小不是越大越好
块变大时,空间局部性让一次缺失带来更多可能命中的邻近数据,缺失率先下降;但 Cache 总容量固定时,块数会减少,冲突与容量缺失又会上升,而且每次缺失要传更多数据,缺失代价也可能增大。
这形成课件所说的“浴盆曲线”:需要在命中率、缺失代价和硬件组织之间折中。
14. AMAT:把命中与缺失合成一个时间
平均存储访问时间:
其中 是命中时间, 是缺失率, 是缺失后的额外代价。
课件示例: 周期、、 周期:
看似只有 2% 的缺失率,却让平均时间翻倍,因为一次缺失太贵。优化时要比较参数变化后的完整乘积,不能只看某个百分比“变小了多少”。
多级 Cache 可递归理解:L1 缺失后才付 L2 的访问与缺失代价。L1 追求短命中时间,L2/L3 用更大容量降低访问主存的概率。
15. 一条通用的 Cache 解题顺序
- 统一单位:地址按 byte,块容量也换成 byte;
- 算 Offset;
- 用数据容量除以“块大小 × 路数”算组数,再算 Index;
- 剩余位是 Tag;
- 模拟访问时先定组,再比较 Tag/Valid,再选 Offset;
- 缺失时按替换策略更新整块与状态;
- 容量题另算 Tag、Valid、Dirty、替换位;
- 性能题把缺失率与缺失代价放回 AMAT。
现有复习提纲对 Cache 的重点是结构、局部性、映射、替换和性能;写策略只在虚拟存储的页面写回语境中展开。若题目额外给出 write-through/write-back 或 write-allocate 条件,再按题面模拟,不自行补一个默认策略。