第八讲 · 流水线冒险、转发与暂停
对应材料:2025 计组复习提纲“流水线冒险、性能分析”,并参考 2024 流水线 PPT。
流水线冒险(hazard)不是程序写错了,而是下一条指令按理想节拍前进时,硬件暂时还不能保证它得到正确结果。处理冒险的目标是:软件可见语义必须与顺序执行一致。
三类冒险:
| 类型 | 根因 | 典型处理 |
|---|---|---|
| 结构冒险 | 同一时刻争用同一硬件 | 复制/多端口资源,或暂停 |
| 数据冒险 | 后指令依赖前指令结果 | 转发、暂停、编译调度 |
| 控制冒险 | 下一 PC 尚未确定 | 预测、提前判断、冲刷、延迟槽 |
1. 结构冒险
如果指令和数据共用一个单端口存储器,同一周期可能既要 IF 取指,又要 M 级执行 lw/sw,两者无法同时完成。课程数据通路把 IM 与 DM 分开,就是从结构上消除这一冲突。
寄存器堆也要同时支持:
- D 级两路读取;
- W 级一路写回。
可用“两读一写”多端口寄存器堆,并安排一个周期内先写后读,使同周期写回值能被 D 级看到。若硬件资源不足,就只能让某条指令停下来。
2. 数据相关不等于数据冒险
例如:
add  $t0, $s0, $s1
sub  $t2, $t0, $s2
第二条读取第一条写的 $t0,这是读后写(RAW)相关。相关是程序语义本身;只有当流水线让 sub 读取时新值还不可用,才形成冒险。
一般还有 WAR、WAW,但经典五级顺序发射 MIPS 中:
- 所有读都在 D 级;
- 所有写都在 W 级;
- 指令按序通过各级。
所以主要硬件数据冒险是 RAW。不要把乱序处理器的所有冒险类型机械套进本课程模型。
3. 为什么“等写回”太浪费
add 的结果在 E 级末尾已经产生,却要到 W 级才写入 RF。紧跟的 sub 下一周期进入 E 级时,真正需要的是 ALU 输入,不一定非要等结果绕到寄存器堆。
**转发(forwarding / bypassing)**就是把流水线寄存器中已经产生但尚未写回的最新结果,直接送到后继指令所需的功能部件。
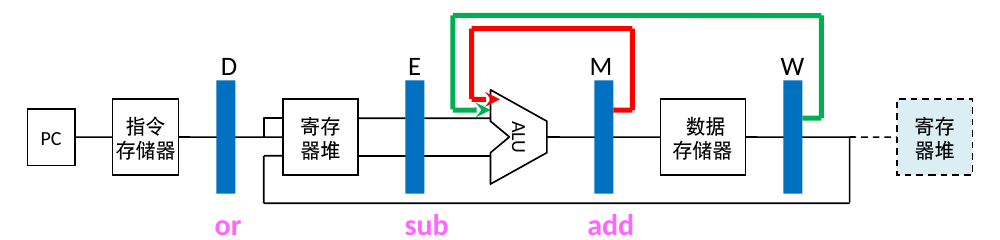
图中红线是较近的 M→E 转发,绿线是较远的 W→E 转发;截自 2025 复习提纲的局部数据通路。
4. 转发条件与优先级
以 E 级指令的 ALU.A 输入为例,比较它要读的 rsE 与后级待写寄存器:
- 若 M 级会写 RF、结果此时已经产生、目的寄存器非 0,且
DstM==rsE,选 M 级最新结果; - 否则,若 W 级会写 RF、目的寄存器非 0,且
DstW==rsE,选 W 级写回结果; - 否则选 ID/EX 中原本读出的寄存器值。
概念表达式:
M 级优先于 W 级,因为同一寄存器可能连续被多条指令写,距离 E 级更近的那条结果更新。这里的 ResultReadyM 排除了结果尚未从数据存储器读出的 lw;不能把它的地址计算结果误当成加载数据转发。
同理还要考虑:
- E 级 ALU.B;
sw写入 DM 的数据;- 若分支在 D 级比较,比较器两个输入也需要转发。
“给 ALU 加两根旁路线”并不完备,必须按所有结果使用点逐一检查。
5. lw-use:转发也赶不上的一拍
lw   $t0, 0($s0)
sub  $t1, $t0, $s1
lw 的数据要到 M 级末尾才从 DM 出来;下一条 sub 同一周期已经在 E 级开头需要 $t0。结果在时间上来不及,即使有旁路也无法“从未来转发到过去”。
解决:暂停一拍,让 sub 晚一个周期进入 E,随后从 W 级写回路径转发读出的数据。
| 周期 | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|---|---|
lw | F | D | E | M | W | ||
sub | F | D | D | E | M | W | |
| bubble | E | M | W |
6. 暂停时到底冻结什么
对 D 级发现的 lw-use 冒险:
- PC 不更新:下一周期仍指向同一个后继位置;
- IF/ID 不更新:D 级指令保持不动;
- 送入 ID/EX 的控制信号清零:让 E 级出现一条不写任何状态的 bubble;
- 更老的 E/M/W 级指令继续向前,
lw才能按时产出结果。
这不是“整条流水线全部停住”。如果连 lw 也冻住,所等的数据永远不会向后产生。
一个简化的 lw-use 检测条件是
最后的“确实读取”很重要:某些 I 型指令把 rt 当目的寄存器,并不读取旧 rt。只按字段编号相等会制造不必要暂停。
7. 编译器调度能否消掉停顿
若两条独立指令可以合法交换,编译器可把无关指令塞进 lw 与使用者之间:
# 原顺序
lw   $t0, 0($s0)
add  $t1, $t0, $s1

# 若下面这条与二者都无依赖,可移入空隙
lw   $t0, 0($s0)
or   $t3, $t4, $t5
add  $t1, $t0, $s1
但重排必须保持所有数据依赖、内存别名和异常行为,不能为了少一拍随意换序。
8. 控制冒险
遇到 beq/bne 时,取指单元不知道下一条该取 还是分支目标。若等到 E 级才得到比较结果,此时后面若干条顺序路径指令已经进入流水线。
8.1 方案一:预测不跳转
先按 继续取:
- 若分支不发生,零损失;
- 若分支发生,把错误路径指令的控制信号清零并从目标重新取指,这叫冲刷(flush)。
8.2 方案二:提前判断
把比较器和分支目标计算前移到 D 级,可以减少错误路径条数。但代价是:
- D 级组合路径变长;
- 分支可能依赖前序结果,D 级比较器也需要转发;
- 某些结果仍未及时产生,可能需要额外暂停。
所以“提前”不是免费优化。
8.3 方案三:分支延迟槽
经典 MIPS 可规定分支后的那一条无论是否跳转都执行,编译器尽量把有用且安全的指令放入延迟槽;找不到时填 nop。
课程材料同时讲了无延迟槽的单周期模型和有延迟槽的经典流水线语义,必须看题目模型:采用延迟槽时,分支与链接地址的 PC 关系也会相应变化,不能混用 与 。
9. 冲刷与暂停不要混淆
| 动作 | 原因 | 被处理的指令 | 做法 |
|---|---|---|---|
| Stall | 正确指令暂时缺数据/资源 | 保留正确指令 | 冻结前级,插入 bubble |
| Flush | 已经取入错误路径 | 丢弃错误指令 | 清零相应流水寄存器控制 |
暂停是“等一等再执行”,冲刷是“这条根本不该执行”。两者都可能把控制信号清零,但 PC 与级间寄存器的处理不同。
10. 实际 CPI
可把实际 CPI 写成
若某类事件发生频率为 、每次平均罚时 个周期,其 CPI 贡献约为 。例如 load 占 25%,其中 20% 紧跟相关使用者,每次暂停 1 拍,则
分支同理,但要乘分支频率、预测失败率和失败罚时,而不是把三者直接相加。
11. 一套不会乱的冒险分析法
对每对相邻或相近指令:
- 写前指令写哪个寄存器、结果在哪一级末尾产生;
- 写后指令读哪个寄存器、在哪一级入口使用;
- 若结果及时,画最近的转发;
- 若时间上来不及,算需要暂停几拍;
- 若是分支,另外追踪下一 PC 何时确定、错误路径要冲刷几条;
- 最后画时空图验证,确保老指令继续向前、错误写使能被清零。
冒险题真正考的是“产生时间”和“使用时间”,不是背红线绿线。