第十讲 · 虚拟存储、中断与 DMA
对应材料:2025 计组复习提纲“虚拟存储器”“微处理器集成”。
程序发出的地址为什么能相同而互不冲突?内存不够时为什么程序还能运行?设备比 CPU 慢几个数量级,CPU 又怎样不被它拖住?
这两组问题分别由地址转换和 I/O 协作机制解决;它们最终在异常、中断和操作系统处理程序处汇合。
1. 虚拟地址与物理地址
CPU 中的程序使用虚拟地址(VA),真正送到主存的是物理地址(PA)。内存管理单元 MMU 完成转换:
CPU 产生 VA → MMU 地址转换 → PA → Cache / 主存虚拟存储带来:
- 每个进程都有独立、连续的虚拟地址空间;
- 不同进程的同一 VA 可映射到不同物理位置;
- 页面权限可以隔离进程并保护内核;
- 当前不需要的页面可暂存磁盘,程序可使用大于物理主存的地址空间。
2. 分页:地址低位不需要转换
虚拟空间按固定大小分成虚拟页,物理主存按同样大小分成物理页框。地址拆成:
页内偏移 Offset 原样保留,只把虚拟页号 VPN 换成物理页号 PPN。
若页大小为 byte,则偏移为 bit。4 KB 页面有 12 位偏移。
2.1 课件例题
32 位虚拟地址、128 MB 物理主存、4 KB 页面:
因此:
- 虚拟空间最多有 个虚拟页;
- 物理主存有 个页框;
- 一个进程不可能让所有虚拟页同时驻留主存。
3. 页表:用 VPN 查 PPN
页表可先理解为数组:VPN 是下标,数组元素是页表项 PTE。PTE 不只保存 PPN,还可能包含:
| 字段 | 作用 |
|---|---|
| Valid / Present | 页面是否已在主存 |
| AR | 读、写、执行等访问权限 |
| Dirty | 驻留后是否被修改 |
| Ref / Accessed | 最近是否被访问 |
| PPN 或磁盘位置 | 在主存时给页框,不在时记录后备位置 |
每个进程有自己的页表。操作系统切换进程时,把该进程页表在主存中的基地址写入 PTBR(Page Table Base Register)。
3.1 页表为何也很大
32 位 VA、4 KB 页面共有 个虚拟页。若每个 PTE 为 4 B,单级页表就要
页表本身放在主存中。如果每次读数据都要先读一次 PTE,再读真正数据,访存次数几乎翻倍,于是需要 TLB。
4. 页命中与缺页
4.1 页命中
PTE 表示页面已经在主存:取出 PPN,与原 Offset 拼成 PA,继续访问 Cache/主存。
4.2 缺页
若页面不在主存,产生缺页异常。CPU 不会让当前 load 读到一个“空值”,而是停止并交给操作系统:
- 用 VPN 找到页面在磁盘的位置;
- 找空闲物理页框;若主存满,选择牺牲页;
- 若牺牲页 Dirty,先写回磁盘;
- 从磁盘把所需页读入页框;
- 更新新旧 PTE,并使失效的 TLB/Cache 状态保持一致;
- 返回后重新执行发生缺页的指令。
重新执行很关键:原指令此前没有完成,不能从下一条继续。
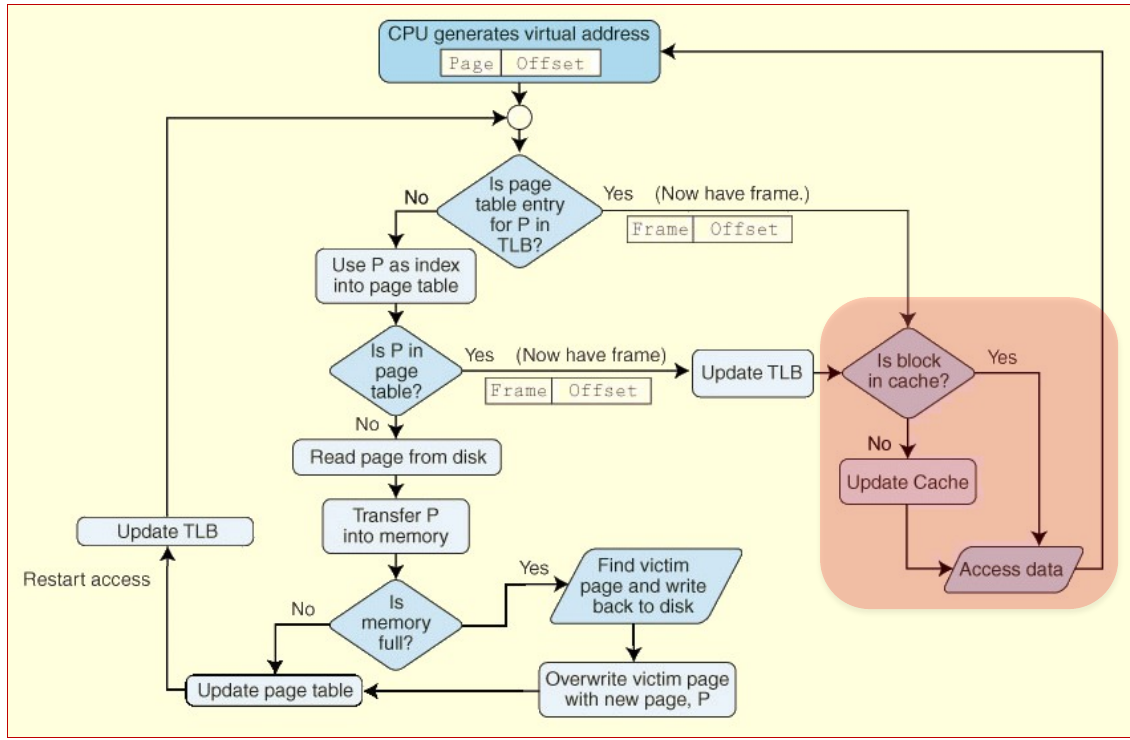
图源:2025 复习提纲的完整数据访问流程。图中 P 代表虚拟页。
5. 为什么虚拟存储必须重视 Dirty
主存与磁盘的性能差距极大,不能每次写内存都同步写磁盘。虚拟存储采用写回思想:先只改主存页面并置 Dirty,页面被替换时才写回后备存储。
Dirty=0:磁盘副本仍是最新,牺牲时可直接覆盖页框;Dirty=1:页面已被修改,替换前必须写回,否则数据丢失。
页面通常比 Cache 块大得多,例如页面 4 KB、Cache 块 64 B。缺页代价也远高于 Cache 缺失,因此页面替换更谨慎,课件强调基于 Ref 的 LRU 思路。
6. TLB:页表项的 Cache
TLB(Translation Lookaside Buffer)保存最近用过的 VPN→PPN 映射:
- 用 VPN 查 TLB;
- 命中则直接得到 PPN;
- 缺失才访问主存中的页表;
- 页表命中后,把 PTE 装入 TLB;
- 页表也缺失则触发缺页处理。
TLB 可以是全相联或组相联。表项一般包含 Valid、Dirty、Ref、AR、TLB Tag 与 PPN。
6.1 组相联 TLB 例题
课件参数:16 KB 页面、40 位 VA、64 GB 主存、2 路组相联 TLB,共 512 项。
若状态位为 Valid 1 位、Dirty 1 位、Ref 1 位、AR 2 位,则表项总位数为
7. TLB、页表、Cache 的先后关系
在课件的物理地址 Cache 模型中:
VA = VPN | Offset
      ↓ 查 TLB
   得到 PPN
      ↓ 拼接
PA = PPN | Offset
      ↓ 查 Cache
   得到数据
为什么先查 TLB?因为 Cache 的 Tag/Index 来自物理地址,在得到 PPN 前还没有完整 PA。
7.1 各种“缺失”不能画等号
| 情况 | 是否可能 | 解释 |
|---|---|---|
| TLB miss,页表 hit | 可能 | 映射在主存页表,但没缓存在 TLB |
| TLB hit,Cache miss | 可能 | 地址转换命中,但数据块没在 Cache |
| TLB miss,转换后 Cache hit | 可能 | 先查页表得到 PA,数据块仍可能在 Cache |
| Page fault,Cache hit | 不可能 | 页面不在主存,物理 Cache 不应有该页的有效数据 |
TLB miss 是“翻译缓存没找到”,Page fault 是“页面本身不在主存”,Cache miss 是“所需物理数据块不在 Cache”。三者发生在不同层。
8. 页面替换与状态一致性
替换一个物理页框时,不能只覆盖 DRAM:
- 旧页 PTE 要改为不驻留,并记录磁盘位置;
- 旧 VPN 对应的 TLB 项要失效;
- 若 Cache 中还有该物理页的数据,相关块不能继续被当作旧映射的有效数据;
- 新页 PTE 要写入新 PPN,随后才能重启访问。
课件用 Ref 表示近期访问。真正的精确 LRU 成本可能很高,系统可周期清 Ref,用近似算法判断哪些页面长期没被访问。
9. I/O 为什么不能照 CPU 速度来
鼠标、网络、磁盘等设备速度相差巨大,也普遍远慢于 CPU。I/O 接口通常提供:
- 状态寄存器:设备是否 ready、是否出错;
- 数据寄存器:CPU 与设备交换的数据;
- 控制寄存器:启动、方向、中断使能等。
10. 程序查询:最简单,也最浪费 CPU
CPU 反复读状态寄存器:
do {
    status = device.status;
} while (!status.ready);

data = device.data;
优点是控制简单;缺点是等待期间 CPU 一直执行无效循环。设备越慢,浪费越严重。
11. 中断:设备准备好后主动通知
中断是设备产生的异步事件,与当前指令没有因果关系。课程模型中的过程:
- 设备拉高中断请求
Int; - CPU 完成当前指令;
- 把下一条指令地址 保存到 EPC;
- PC 跳到固定 ISR 入口
0xBFC00000; - 中断服务程序保存现场、服务设备、恢复现场;
eret把 EPC 恢复到 PC,继续原程序。
ISR 框架:
保存可能被破坏的寄存器
读取设备状态,判断中断原因
与设备交换数据并确认/清除请求
恢复寄存器
eret
12. EXL:防止同一个中断反复重入
设备可能一直保持中断请求,直到 ISR 真正访问设备寄存器清除它。若 CPU 刚进 ISR 执行一条指令又响应同一电平,就会不断跳回 ISR 开头。
课程模型用状态寄存器中的 EXL 位:
- 正常执行时
EXL=0,允许响应; - 进入 ISR 同时置
EXL=1,屏蔽再次进入; eret恢复 EPC 的同时清EXL=0。
真正的中断机制是软硬件协同:设备发请求,控制器在指令边界检测,EPC/EXL 保存最小硬件状态,ISR 再用软件保存完整现场。
13. 异常与中断
课件把异常定义为 CPU 执行指令产生的同步事件,例如溢出、除 0、非法指令、TLB 缺失。
| 对比 | 异常 | 中断 |
|---|---|---|
| 与指令流关系 | 同步,有因果关系 | 异步,无因果关系 |
| 受害指令 | 尚未完成,停止执行 | 当前指令先完成 |
| EPC 保存 | 当前指令地址 | 下一条指令地址 |
| 返回后 | 常需重试受害指令 | 从下一条继续 |
两者处理骨架相似:保存位置、进入处理程序、保存/恢复现场、特殊返回。区别决定 EPC 中究竟应该放当前 PC 还是 。
课件的控制状态机为中断增加 INT 状态,为异常增加 EXC 状态:非法指令可在译码阶段发现,溢出在 ALU 运算阶段发现。控制器必须保证异常指令不产生部分写入,才能实现精确恢复。
14. DMA:批量数据不再让 CPU 逐字搬运
中断避免了忙等,但若每传一个字都中断一次,CPU 仍要执行大量 I/O 指令。DMA(Direct Memory Access)让控制器直接在设备和主存之间搬一整块数据。
DMA 控制器通常含:
- Address:当前主存/设备地址;
- Counter:剩余传输量;
- Control:方向、中断使能等;
- Status:完成或错误状态;
- 数据缓冲与总线接口逻辑。
14.1 DMA 的三个阶段
- CPU 初始化:设置方向、设备地址、主存起始地址、长度和完成中断;
- DMA 传输:申请总线,读源、写目的,地址递增、计数递减;
- 后处理:整块完成后产生一次中断,CPU 检查结果或提交下一块。
DMA 获得总线时,CPU 可能暂时无法访问主存,这仍是一种资源竞争;但相比 CPU 为每个字执行 load/store,整体效率高得多。
15. 三种 I/O 方式放在一起
| 方式 | 等待由谁承担 | 数据由谁搬 | CPU 开销 | 适合场景 |
|---|---|---|---|---|
| 程序查询 | CPU 忙等 | CPU | 最高 | 极简单、极短操作 |
| 中断 I/O | 设备就绪时通知 | CPU/ISR | 中等 | 零散事件、低速设备 |
| DMA | DMA 控制器 | DMA | 最低 | 高速、批量传输 |
16. 完整系统的一次 load
一条 lw 的真实路径可以这样串起来:
- 流水线 E 级用 ALU 算 VA;
- VPN 查 TLB;
- TLB miss 时查页表,Page fault 时异常进入 OS、从磁盘调页;
- PPN 与 Offset 拼成 PA;
- PA 查 Cache;
- Cache miss 时从主存装入数据块;
- 数据沿流水线写回目标寄存器;
- 若等待磁盘 I/O,设备完成后还可能用 DMA 搬数据并以中断通知 CPU。
从一条指令到整个系统,核心始终是三问:状态在哪里、谁产生下一状态、结果什么时候可用。