区间估计不只给一个猜测,还给出由抽样波动决定的误差范围。课程里最可靠的做法是:先写枢轴量,再放分位点,最后解参数。
置信区间的频率学解释
参数 θ 固定,区间端点随样本随机。若
Pθ{L(X)≤θ≤U(X)}=1−α,
则 [L,U] 是置信度 1−α 的区间。重复抽样时,长期约有 1−α 的区间覆盖真参数。对已经得到的区间,经典解释不说“参数有 95% 概率在里面”。
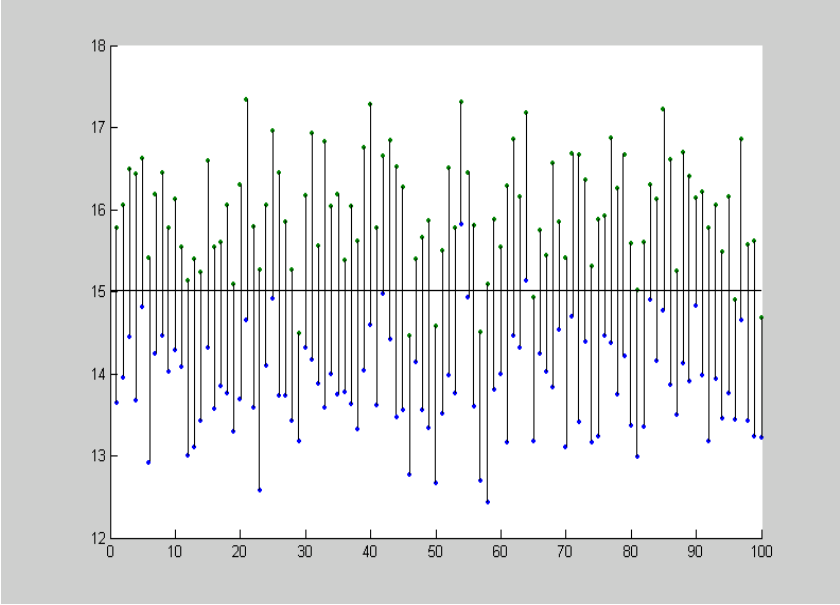
图中的水平线是参数真值,每一条竖线都是一次重新抽样后得到的区间。少数区间没有穿过真值,正是“置信度描述长期覆盖率,而不是某个已算出区间的概率”的直观含义。
正态总体均值
方差已知
Z=σ/nXˉ−μ∼N(0,1),
故双侧区间为
μ∈[Xˉ−z1−α/2nσ,Xˉ+z1−α/2nσ].
方差未知
用 S 替换 σ 后必须换成 t 分布:
T=S/nXˉ−μ∼t(n−1),
所以
μ∈Xˉ±t1−α/2(n−1)nS.
正态总体方差
利用
Q=σ2(n−1)S2∼χ2(n−1),
得到
σ2∈[χ1−α/22(n−1)(n−1)S2,χα/22(n−1)(n−1)S2].
注意参数在分母,解不等式后两个分位点会交换位置。
Bernoulli 比例的大样本区间
样本比例 p^=X/n 近似满足
p(1−p)/np^−p≈N(0,1).
把未知 p 用 p^ 替换可得 Wald 区间
p^±z1−α/2np^(1−p^).
它在样本小或比例接近 0、1 时表现不好;课程外实践通常优先 Wilson 区间。考题若明确要求大样本近似,再按课件形式作答。
单侧区间
只关心上界或下界时,把全部错误概率 α 放在一侧,使用 1−α 分位点,而不是 1−α/2。先画分布尾部能有效避免写反。
区间宽度由什么决定
均值区间半宽大致为“分位点 × 标准误”。提高置信度会增大分位点,使区间更宽;增大样本量会按 1/n 缩窄区间。想把误差减半,样本量通常要扩大到四倍。