统计量会随样本变化,因此也有自己的概率分布,这就是抽样分布。推断能否成立,取决于我们是否知道这个分布。
正态样本的四条核心结论
若 X1,…,Xn∼i.i.d.N(μ,σ2),则
Xˉ∼N(μ,nσ2),
σ2(n−1)S2∼χ2(n−1),Xˉ⊥S2,
T=S/nXˉ−μ∼t(n−1).
这些结论背后是正交分解:样本向量沿“全 1 方向”的投影给出均值,剩余 n−1 个正交方向给出离差平方和。正态向量在正交方向上仍独立,所以均值与样本方差独立。
三大分布怎样串起来
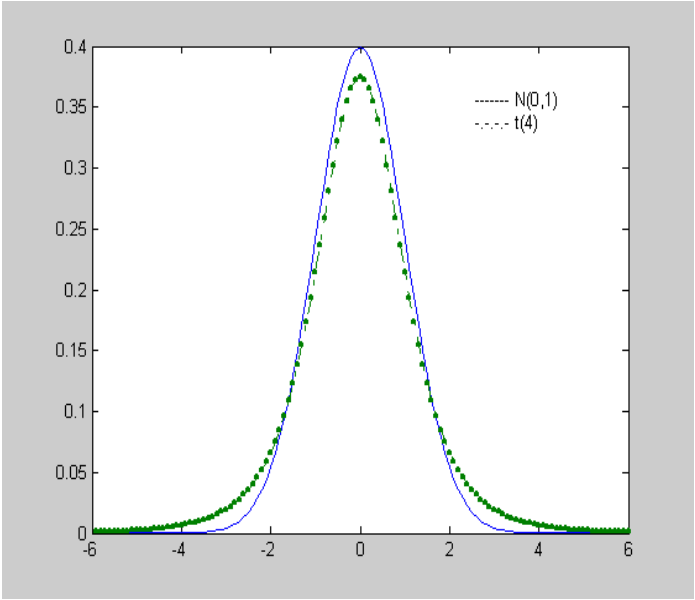
t 分布与标准正态分布同样关于零对称,但尾部更厚;自由度增大时,估计方差带来的额外不确定性变小,t 分布也就逐渐靠近标准正态分布。
若 Zi∼i.i.d.N(0,1),则
U=i=1∑νZi2∼χ2(ν).
若 Z∼N(0,1)、U∼χ2(ν) 且独立,则
U/νZ∼t(ν).
若 U1∼χ2(ν1)、U2∼χ2(ν2) 且独立,则
U2/ν2U1/ν1∼F(ν1,ν2).
所以 χ2 是基础积木,t 是“标准正态除以随机标准差”,F 是“两份随机方差之比”。
大样本下的近似分布
总体未必正态。只要均值、方差存在,中心极限定理给出
σn(Xˉ−μ)dN(0,1).
这允许用正态分布近似样本均值,但“n≥30 就一定可以”不是定理。总体越偏、尾越重,通常需要更大样本;极端重尾甚至可能不满足有限方差条件。
充分统计量:只保留与参数有关的信息
统计量 T(X) 对参数 θ 充分,意思是已知 T 后,原始样本关于 θ 不再提供额外信息。最常用的判断工具是 Neyman–Fisher 因子分解定理:若联合密度能写成
p(x1,…,xn;θ)=g(T(x);θ)h(x),
其中 h 与 θ 无关,则 T 充分。
例如指数尺度模型
f(x;θ)=θ1e−x/θI(x>0)
的联合密度为
θ−nexp(−θ∑xi)∏I(xi>0),
因此 T=∑Xi 充分。原始 n 个数关于 θ 的信息被压缩为一个和。
充分不等于完备
完备性是更强的性质:若对所有 θ 都有 Eθ[g(T)]=0,就必须有 g(T)=0(几乎处处)。充分说明“不丢信息”,完备保证“没有无用的零均值方向”。二者合在一起,能锁定唯一的最小方差无偏估计。