统计推断的原材料不是一列固定数字,而是一组随机变量。先把这层关系想清楚,后面的“估计量为什么也有分布”就顺了。
总体、样本与样本值
总体 X 用一个分布描述研究对象的随机规律。简单随机样本
X1,…,Xn∼i.i.d.F
包含两个条件:每个 Xi 都与总体同分布,且彼此独立。抽样前的 Xi 是随机变量;抽样后看到的 xi 才是固定的样本值。
“总体”不一定是一群实体,也可以是一次随机机制。例如研究电容寿命时,总体是寿命分布;取出的 n 个电容寿命是样本。
经验分布函数
不知道总体分布 F(x) 时,可以用样本中不超过 x 的比例近似它:
Fn(x)=n1i=1∑nI(Xi≤x).
Fn 是一条每遇到一个样本点就向上跳 1/n 的阶梯。Glivenko–Cantelli 定理说明样本增大时,Fn 会一致逼近 F。这也是“用样本特征替换总体特征”的根本依据。
图形不是装饰,而是先做诊断
- 直方图看分布形状、偏斜、多峰与异常长尾;
- 茎叶图在样本不大时既保留数值又展示形状;
- 箱线图用四分位数快速比较位置、离散程度与异常值。
箱线图的盒子从 Q1 到 Q3,中线是中位数,四分位距
IQR=Q3−Q1.
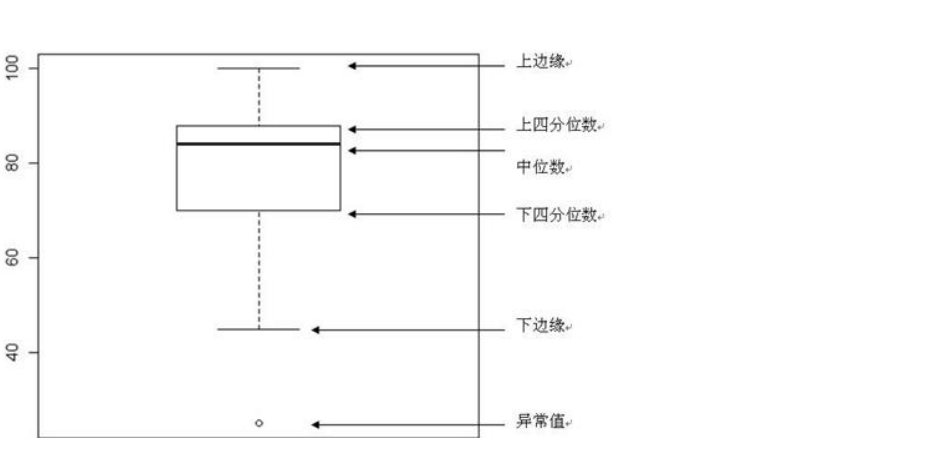
把箱线图看成一张压缩后的数据地图:盒子的高度反映中间一半数据的离散程度,中位数在盒子中的位置则能帮助判断偏斜。
常用规则把低于 Q1−1.5IQR 或高于 Q3+1.5IQR 的点标为异常点。它只是在提示“值得检查”,不等于这些数据一定错误。
统计量
统计量是只由样本构成、不能含未知参数的函数。常见统计量包括
Xˉ=n1∑Xi,S2=n−11∑(Xi−Xˉ)2,
Ak=n1∑Xik,X(1)≤⋯≤X(n).
其中 Ak 是 k 阶样本原点矩,X(i) 是第 i 个次序统计量。样本分位数、中位数、极差都可由次序统计量构造。
为什么样本方差分母是 n−1
恒等式
i=1∑n(Xi−Xˉ)2=i=1∑n(Xi−μ)2−n(Xˉ−μ)2
两边取期望可得分子期望为 (n−1)σ2,所以除以 n−1 才使 S2 无偏。直观上,残差之和被约束为零,n 个残差只剩 n−1 个自由度。
次序统计量的通用公式
若总体连续,分布函数为 F、密度为 f,则第 k 个次序统计量密度为
fX(k)(x)=(k−1)!(n−k)!n![F(x)]k−1[1−F(x)]n−kf(x).
不必死背推导:要让 X(k) 落在 x 附近,需要恰有 k−1 个点在它左边、n−k 个在右边,再乘排列数。
极小值与极大值更适合从尾概率算:
P(X(1)>x)=[1−F(x)]n,P(X(n)≤x)=[F(x)]n.
这两个式子在真题和作业里反复出现。