PCA 是无监督降维的代表。最大方差和最小误差看起来是两个不同的目标,最后都归结为协方差矩阵的特征值分解。
一、动机
把高维相关数据压成低维,又尽量不丢信息。做法:找数据”铺得最开(方差最大)“的方向投影。方差大的方向区分度高、信息多;方差小的方向点挤成团,往往是噪声,可丢弃。
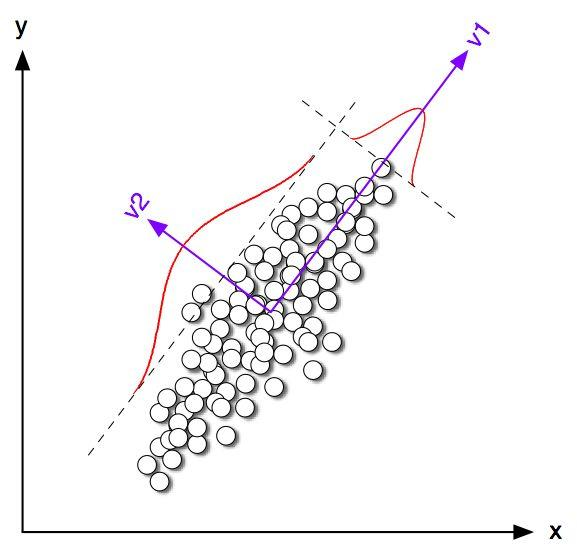
图:PCA 不关心类别标签,只寻找整批数据延展最明显的正交方向。
PCA 定义:把原有众多有相关性的指标,重新组合成一组少量互相无关的综合指标。两个等价目标:
- 最大方差:降维后样本方差尽可能大;
- 最小均方误差:降维后重建回原空间的误差尽可能小。
两个目标推到底结论相同——都取协方差矩阵最大特征值对应的特征向量。
二、最大方差视角
数据 {xn}(n=1,…,N),每点 D 维,先降到 1 维,投影方向为单位向量 u1(u1Tu1=1)。点投影后坐标为 u1Txn。
投影后样本方差可化简为:
N1∑n=1N(u1Txn−u1Txˉ)2=u1TSu1
其中 S 为原数据协方差矩阵:
S=N1∑n=1N(xn−xˉ)(xn−xˉ)T
目标:在 u1Tu1=1 约束下最大化 u1TSu1。用拉格朗日乘子法构造 u1TSu1+λ1(1−u1Tu1),对 u1 求导置零得:
Su1=λ1u1
这正是特征值方程:最优投影方向是 S 的特征向量。代回得投影后方差 u1TSu1=λ1,所以应取最大特征值对应的特征向量:
u1=S 最大特征值对应的特征向量=第一主成分
降到 M 维则取前 M 大特征值对应的 M 个特征向量。由于 S 对称、特征向量正交,各主成分天然互不相关。
三、最小均方误差视角
建一组标准正交基 {ui}(uiTuj=δij),点可精确展开 xn=∑i=1Dαniui,αni=xnTui。只保留前 M 维、其余用共享常数近似,得重建 x~n。
失真度(均方误差):
J=N1∑n=1N∥xn−x~n∥2=∑i=M+1DuiTSui
拉格朗日求解同样得到 Sui=λiui,失真度变为被丢弃方向的特征值之和:
J=∑i=M+1Dλi
要 J 最小,就丢掉最小的 D−M 个特征值、保留最大的 M 个。这与最大方差视角得到的选择一致。
四、计算步骤
- 计算样本均值 xˉ 和协方差矩阵 S;
- 计算 S 的特征值与特征向量;
- 特征值从大到小排序,取前 M 个特征值对应的特征向量构成投影矩阵;降维即数据乘投影矩阵。
数值例:4 个已中心化的点 (2,0),(0,2),(−2,0),(0,−2)。协方差 S=41(8008)=(2002),特征值 λ1=λ2=2(对称,无主次)。
若改为椭圆分布 (4,0),(0,1),(−4,0),(0,−1),则 S=(8000.5),λ1=8≫λ2=0.5,第一主成分为 (1,0)。
一个常见练习是给出 2×2 协方差矩阵,计算特征值(det(S−λI)=0)和特征向量。
五、应用与优缺点
应用直觉:特征值谱通常前几个大、后面骤降到接近 0(提示用前几维即可,小特征值方向多为噪声);失真度随保留维度 M 增大而减小。
优点:
- 普适性高,最大程度保留原数据信息;
- 可按主成分重要性排序,按需降维 / 压缩;
- 小特征值方向多与噪声相关,可去噪;
- 完全无参数,结果只由数据决定。
局限:
- 假设关系是线性的;
- 假设高信噪比(默认大方差为主成分,可能误删方差小但关键的方向);
- 只利用均值与协方差这类二阶统计量,可能忽略非线性流形和更高阶的分布结构。
六、PCA vs LDA
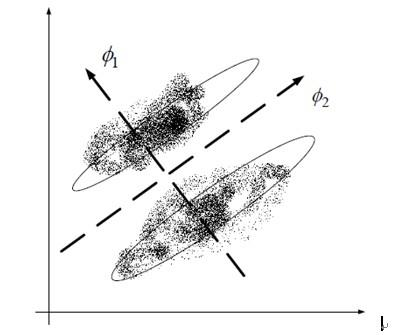
LDA(Linear Discriminant Analysis,线性判别分析,又称 Fisher 判别)也是投影降维,但目标与 PCA 相反:让投影后不同类离得最远、同类挤得最紧,专为”好分类”服务。
| 对比项 | PCA | LDA |
|---|
| 目标 | 保留最多信息(投影方差最大) | 类别最易区分 |
| 标签 | 不用(无监督) | 用(有监督) |
| 可能问题 | 投影后不同类可能混在一起 | 专为分类,类间分得开 |
LDA 核心(够用即可):类间散度 Sb=(m1−m2)(m1−m2)T(越大越好),类内散度 Sw=S1+S2(越小越好)。Fisher 准则最大化类间 / 类内之比:
JF(w)=wTSwwwTSbw
最优投影方向:
w∗=Sw−1(m1−m2)
PCA 希望投影后保留尽可能多的总体变化;LDA 则利用标签,让类间尽量分开、类内尽量紧凑。
复习要点
- 两个视角(最大方差 / 最小误差)都归到 Su=λu,取最大 / 丢最小特征值。
- 协方差矩阵公式、失真度 J=∑i=M+1Dλi。
- 2×2 协方差矩阵手解特征值 + 特征向量。
- PCA 优缺点(尤其三条线性 / 高信噪比 / 高斯假设的局限)。
- PCA vs LDA:无监督 vs 有监督、保信息 vs 分类别,Fisher 准则与最优方向 w∗=Sw−1(m1−m2)。