速成 · 智能控制与机器人
这门课表面上从专家系统讲到 VLA,跨度很大;把它们放回机器人闭环以后,关系会清楚很多:机器人先感知环境,再形成判断和决策,最后执行动作,并从新的反馈里继续修正。
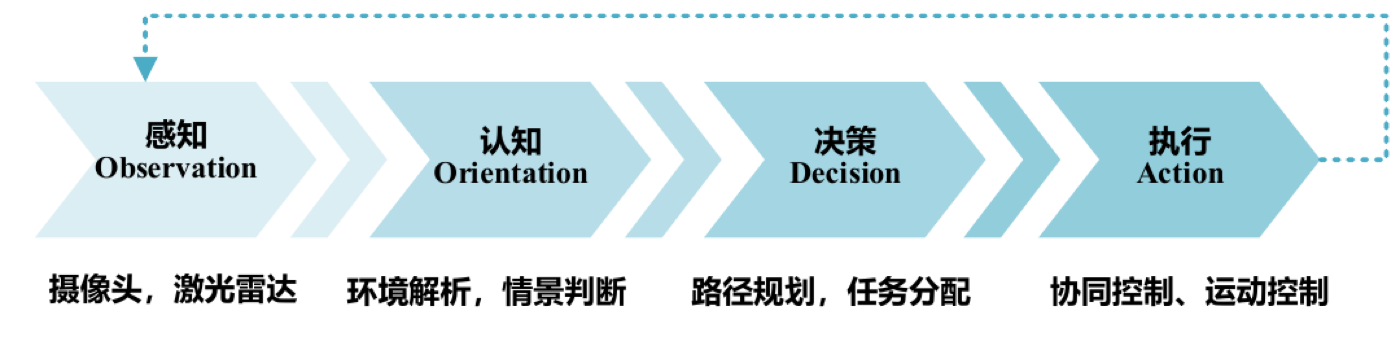
课程中的方法分别在解决不同缺口:
| 缺口 | 方法 | 它提供什么 |
|---|---|---|
| 专家知道怎么做,但经验没有写进程序 | 专家系统、专家控制 | 显式规则与推理 |
| 经验是“有点大、比较快”这类模糊语言 | 模糊控制 | 隶属度与模糊推理 |
| 规则和参数需要从数据中调整 | TSK、ANFIS、神经网络 | 可训练的非线性映射 |
| 同一任务要越做越准 | 迭代学习控制 | 跨轮误差修正 |
| 没有标准答案,只能从结果好坏学习 | 强化学习 | 奖励驱动的策略优化 |
| 机器人需要知道画面怎样运动 | 光流 | 像素运动估计 |
| 需要把视觉、语言和动作连成系统 | 具身智能、VLA | 面向任务的端到端或分层决策 |
| 模型要进入真实设备 | 安全评估与实验 | 风险约束、部署与验证 |
智能控制并不是“用 AI 替代控制”。更准确的理解是:当对象难建模、环境会变化、任务包含感知与决策时,把规则、学习、优化和反馈控制组合起来。课件用
概括自动控制、人工智能与运筹优化的交叉关系。
一、专家系统:把经验写成规则
专家系统的核心结构是“知识库 + 推理机”。知识库保存事实与 IF-THEN 规则,推理机按规则推出结论:
- 正向推理从事实出发,逐步匹配可触发规则;
- 反向推理先提出目标,再寻找支持目标的证据;
- 双向推理把两种方式结合起来。
规则存在不确定性时,可以写成
IF E THEN H WITH CF(E,H)其中 表示证据支持或反对结论的程度。
专家系统更像离线给建议的顾问,专家控制则要实时读取反馈并直接参与闭环。专家 PID 是典型例子:先用 PID 产生基础控制量,再根据误差大小、变化方向和异常状态切换规则或调整参数。
数字 PID 的增量式为
记住它的来源比死记展开式更稳:分别把位置式 PID 在 和 时刻相减,比例项变成一阶差分,积分项只剩当前误差,微分项变成二阶差分。
二、模糊控制:让“有点大”也能参与计算
经典集合只允许属于或不属于,模糊集合用隶属度
表示一个输入在多大程度上符合“温度高”“速度快”之类的概念。常见逻辑运算为
模糊控制器的完整数据流是:
精确输入 → 模糊化 → 规则推理 → 模糊输出 → 解模糊 → 精确控制量二维控制器通常以误差 和误差变化 为输入,以控制量 为输出。设计时依次确定论域、语言变量、隶属函数和规则表,再做推理与解模糊。重心法的离散形式为
模糊自整定 PID 不直接替代 PID,而是根据 与 在线给出
再更新三个参数。专家 PID 主要用规则切换“采用什么控制动作”,模糊 PID 主要连续调整“动作力度”。
三、TSK、ANFIS 与 Mamba:把结构变成可训练模型
Mamdani 规则的后件是模糊集合;TSK 把后件改成常数或输入的函数。例如
若第 条规则的激活强度为 ,最终输出是局部模型的归一化加权平均:
前件使用高斯隶属函数时,规则激活强度与 RBF 网络的隐藏层响应形式一致;每条规则也可以看成一个局部专家。这就是 TSK 与 RBF、MoE 之间的联系,但不表示它们在任何结构和训练方式下都完全等价。
ANFIS 把 TSK 推理展开成五层网络:隶属度、规则激活、归一化、后件计算、求和。它既能通过反向传播或混合优化训练,又能把结果还原为规则。
课程随后转到状态空间模型:
状态 压缩历史, 控制记忆演化, 写入当前输入, 读出状态。Mamba 的选择性状态空间模型让部分参数随输入变化,决定哪些内容应该写入、保留或忽略。它训练时使用并行扫描,推理时递推单个状态,长序列计算接近线性。TSK 和 Mamba 不是同一条模型谱系;课件把它们放在同一讲,是为了说明“把已知结构嵌进可学习模型”的共同思路。
四、神经网络控制:先分清网络在闭环里做什么
神经网络通过前向计算得到输出,用损失函数衡量误差,再用链式法则反向传播梯度。用于控制时,最重要的不是“网络有几层”,而是它接在闭环的哪个位置。
常见结构包括:
- 监督控制:网络学习现有控制器的输入输出;
- 直接逆控制:网络近似对象逆模型,放在对象之前;
- 自校正控制:网络在线辨识未知动力学,再据此计算控制;
- 模型参考控制:让对象输出追踪理想参考模型;
- 预测控制:预测未来并滚动优化;
- 自适应评判:Actor 选动作,Critic 评价长期收益;
- 混合控制:与 PID、模糊规则或专家系统组合。
RBF 网络用局部高斯基函数逼近非线性:
局部响应使它适合在线更新,但网络损失下降不等于闭环一定稳定。工程上还要单独分析对象、控制律、学习速率、采样周期和执行器约束。
序列模型则沿“怎样保存历史”演进。普通 RNN 在每个时间步递推
若输入、隐藏状态和输出维度分别为 ,则五组参数的形状依次是 、、、、,总参数量为
例如 时共有 个参数。时间步之间共享这些参数,因此序列变长不会增加模型参数量。
普通 RNN 反向传播时要沿时间连续相乘,容易出现梯度消失或爆炸。LSTM 增加细胞状态和遗忘、输入、输出三道门,GRU 用更新门和重置门把结构简化为单一隐藏状态。Transformer 改用注意力直接建立位置之间的联系并行训练,Mamba 则用选择性状态空间递推处理长序列。几种模型没有谁在所有任务上都更好,要看序列长度、并行需求、动作频率和部署资源。
五、ILC 与强化学习:两种“从反馈中学习”
迭代学习控制(ILC)适合轨迹会重复的任务。它沿两个维度运行:一轮任务内部有时间 ,相同任务的重复次数是 。P 型学习律为
若对象写成 ,则误差递推为
标量情况下要求
矩阵情况下可检查
这说明 ILC 不是不加判断地累积上一轮误差;学习增益要让误差沿迭代轴收缩,而且任务、初始状态和重复扰动也要足够一致。
强化学习(RL)面对的是一般状态—动作决策。智能体观察状态 ,执行动作 ,环境返回奖励和下一状态。目标是最大化贴现回报
Q-Learning 的更新为
DQN 用神经网络替代表格;Actor-Critic 用 Actor 产生动作、Critic 估计价值;PPO 限制策略单次更新幅度,SAC 加入最大熵目标,TD-MPC 则学习动力学并结合短期规划。
两者的区别很明确:ILC 用同一任务上一轮的误差改进下一轮输入,RL 用环境奖励改进一般状态下的策略。ILC 不等于 RL,P 型 ILC 也不等于普通 P 反馈控制。
六、光流:从两帧图像估计运动
光流描述像素在图像平面上的瞬时速度 。假设同一物体点在相邻帧中亮度基本不变,而且位移足够小,有
一阶展开后得到光流约束方程
一个方程有两个未知量,这就是孔径问题。不同方法用不同方式补足约束:
- Lucas-Kanade 假设局部窗口共享同一光流,用最小二乘求稀疏特征点;
- Farneback 用局部二次多项式近似,计算传统稠密光流;
- FlowNet 直接用卷积网络从图像对学习稠密光流。
LK 法中若窗口只有单方向边缘,梯度矩阵可能退化;角点在两个方向都有明显变化,通常更适合稳定跟踪。光流估计的是图像运动,不必然等于物体真实三维速度,还会受到相机自身运动、遮挡和光照变化影响。
七、具身智能与 VLA:把前面的方法放回系统
具身智能强调智能来自身体、环境和反馈的持续耦合。机器人通常只能看到局部观测,因此常用 POMDP 描述:
真实状态 不完全可见,智能体只能获得观测 ,需要利用历史或内部记忆做决策。
VLA(Vision-Language-Action)把视觉、语言和动作放进统一模型。基本链路是:视觉编码器把图像变成视觉 token,语言模型理解指令,融合模块让语言读取相关视觉信息,动作头输出离散动作、连续控制量或未来轨迹。
典型模型各有侧重:RT-2 把动作离散成 token 并结合视觉语言预训练;OpenVLA 提供开源模型与训练流程;Pi0 用 MoE Transformer 把视觉语言主干与动作专家组合,再以 Flow Matching 生成连续动作。Pi0.5 进一步处理动作训练对原有视觉语言知识的干扰:隔离动作梯度对 VLM 预训练知识的破坏,先预测高层语义子任务、再生成低层动作,并让异构的视觉语言数据和机器人动作数据协同训练。
具身系统不一定要让一个大模型直接输出关节力矩。NaVILA 就把高层视觉语言导航和底层运动控制拆开:高层输出“前进多远、转多少度”,底层策略负责平衡、避障和关节控制。高层低频处理语义,底层高频保证运动,是很常见的系统分工。
八、安全不是模型后面再加一个开关
真实机器人从摄像头、预处理、框架、算子和芯片一路到执行器,任何环节的问题都可能传导到动作。课件用“冰山模型”区分两类风险:
- 内生风险:鲁棒性、隐私性、透明性;
- 衍生风险:公平性、有害性、可靠性。
对抗样本是在扰动预算内改变模型预测;成员推断判断某条记录是否参与训练,模型反演尝试恢复训练信息,模型窃取通过查询复制模型能力。安全评估不能只看一次准确率,还要明确攻击者知识、扰动范围、数字或物理场景,并同时测试功能、鲁棒性、效率与可维护性。
控制系统还需要独立于学习模型的确定性保护:速度与力矩限幅、碰撞检测、看门狗、急停、通信超时停车、日志和回退。模型给出动作,不代表系统必须原样执行。
九、课程实验:分清做过的、比较过的和设想的
NaVILA 课程项目完成的是官方评估流程复现与参数对比,包括 Habitat 环境、R2R-VLNCE 任务、开环基线、闭环执行方式和 4-bit 量化实验。读实验结果时要同时看 SR、SPL、NE、OS 和 nDTW:成功率、路径效率、终点距离和轨迹一致性回答的是不同问题。
开环评估在固定数据上预测动作或轨迹,不让预测结果改变后续观测;闭环评估把动作送回环境,下一步输入会受到此前误差影响。两者不能用同一口径解释。
SimLingo 小车部署是课程给出的可选方案:GPU 基站负责 VLA 推理,小车负责传感采集和 /cmd_vel 执行,通过 ROS1 连接。它说明从模型到机器人还要处理 Domain Gap、动作空间映射、跨机通信、频率和安全机制,但我不能把它写成我们已经完成的实车结果。
十、综合题或项目设计的回答顺序
面对“为某个机器人设计智能控制方案”,可以按下面九步展开,便于保留完整的系统层次。
- 任务与控制目标:跟踪、导航、抓取,成功条件和允许误差是什么。
- 感知输入:相机、雷达、编码器、力传感器分别提供什么观测。
- 状态与记忆:当前观测是否足够,是否需要 RNN、Transformer、SSM 或显式地图。
- 决策方法:规则、模糊、监督学习、ILC、RL 或 VLA 为什么适合该任务。
- 控制输出:离散技能、轨迹、速度、力矩,在哪一层转换。
- 闭环频率:高层语义决策和底层运动控制分别多久更新一次。
- 学习与稳定:训练目标是什么,闭环稳定或 ILC 收敛怎样验证。
- 安全机制:限幅、急停、看门狗、故障回退和人工接管。
- 评价指标:任务成功、跟踪误差、效率、鲁棒性、资源占用和安全事件。
这套顺序的好处是,答案不只是在列模型名字,而是在说明每个模块收到什么、输出什么、怎样被反馈和约束。
十一、最容易混淆的几组概念
| 容易混淆 | 区别 |
|---|---|
| 专家系统与专家控制 | 前者主要给判断和建议;后者在线参与实时闭环 |
| 专家 PID 与模糊 PID | 前者按经验规则切换控制策略;后者用隶属度推理连续整定参数 |
| Mamdani 与 TSK | 前者后件是模糊集合并需解模糊;后者后件是数值函数并加权平均 |
| TSK 与 RBF | 高斯前件下可共享局部基函数形式,但解释结构和一般训练方式不同 |
| P 型反馈与 P 型 ILC | 前者在同一轮按当前误差反馈;后者把第 轮误差用于第 轮 |
| ILC 与 RL | ILC 学重复轨迹的误差补偿;RL 从奖励学习一般决策策略 |
| MDP 与 POMDP | MDP 假设完整状态可见;POMDP 只能看到与隐藏状态相关的观测 |
| Transformer 与 Mamba | 前者用全局注意力;后者用选择性状态空间递推压缩历史 |
| 开环评估与闭环评估 | 前者预测不改变下一输入;后者动作进入环境并影响后续观测 |
| 训练收敛与控制稳定 | 损失下降只说明优化过程;闭环稳定还要分析对象与控制器共同动力学 |
十二、需要细看时去哪一讲
- 第一讲:导论与课程地图
- 第二讲:专家系统与专家控制
- 第三讲:模糊控制
- 第四讲:TSK、ANFIS 与 Mamba
- 第五讲:神经网络控制
- 第六讲:ILC 与强化学习
- 第七讲:光流
- 第八讲:具身智能与 VLA
- 第九讲:智能系统安全与伦理
- 第十讲:NaVILA 与部署实验
复习时先确认每种方法在“感知—决策—控制—反馈—安全”链路中负责哪一段,再补对应公式,并区分课件方案、实际完成的实验和仍停留在设想中的部署。