速成 · 博弈论
如果只记一句话,博弈论研究的是:当每个人的最优选择都取决于别人怎样选择时,哪些策略预测能够彼此自洽。
这门课的内容很多,但分类方法只有两个问题:行动有没有可观察的先后?参与人是否知道所有人的收益结构?两个问题交叉后,整门课正好落在四个格子里。
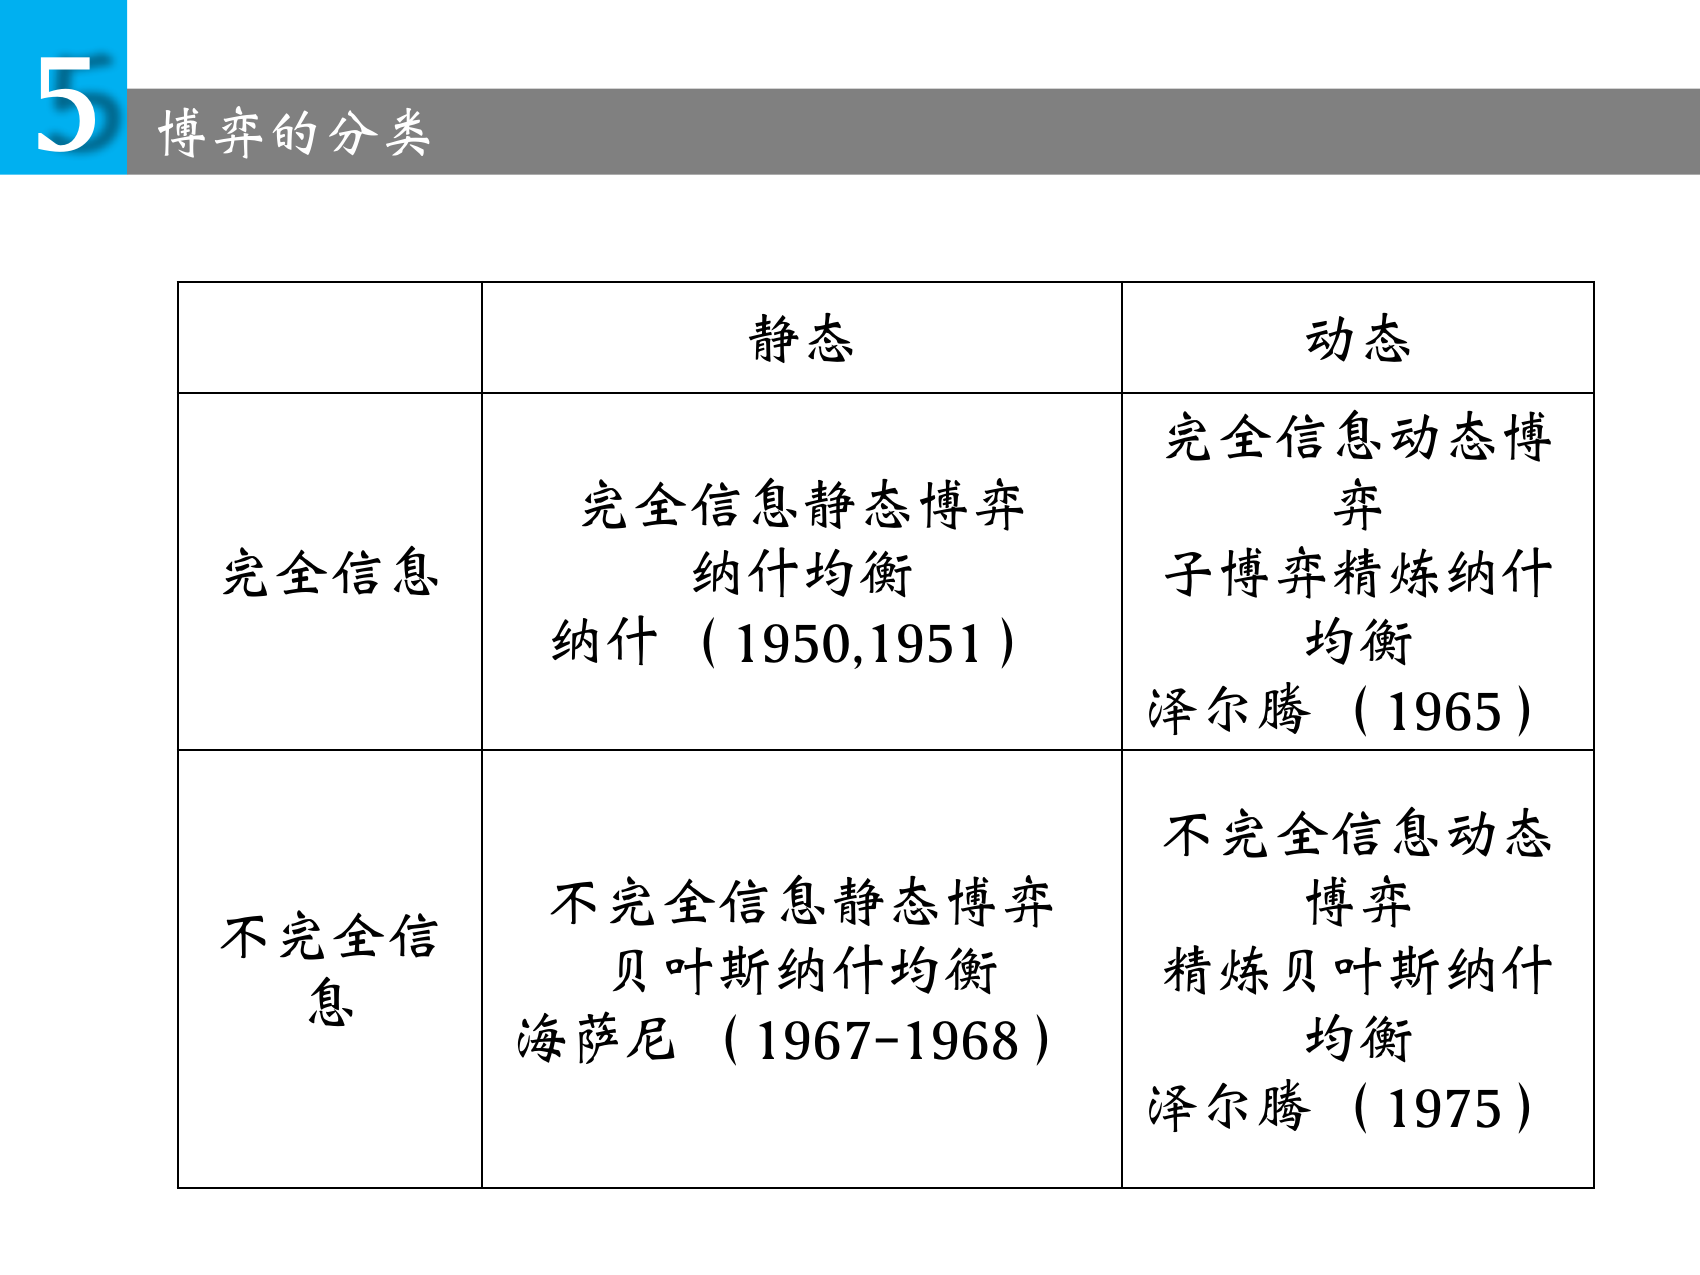
| 完全信息 | 不完全信息 | |
|---|---|---|
| 静态 | Nash 均衡 | 贝叶斯 Nash 均衡(BNE) |
| 动态 | 子博弈精炼 Nash 均衡(SPNE) | 精炼贝叶斯 Nash 均衡(PBE) |
接下来所有定义和公式,都可以看成在回答同一个问题:给定对手的策略以及自己掌握的信息,我现在的选择是不是最优的?
先判断题目属于哪一类
看到新问题时,先别急着算。按下面的顺序判断,通常就知道该用哪套工具。
- 若题目给出收益矩阵,先求纯策略 Nash;没有纯策略或明确要求随机化,再求混合策略。
- 若题目给出博弈树,而且后手能观察前手行动,用逆向归纳求 SPNE。
- 若同一个阶段博弈反复进行,比较当期偏离收益和未来奖惩,属于重复博弈。
- 若玩家同时行动,但不知道对手的成本、估值或其他私人信息,用类型与期望收益求 BNE。
- 若前手知道自己的类型、先行动,后手观察行动后更新判断,用策略加信念求 PBE。
“完全信息”和“完美信息”容易混淆。完全信息说的是大家是否知道收益结构;完美信息说的是行动时能否看见此前发生的全部相关行动。一个同时行动的收益矩阵可以是完全信息博弈,却不是完美信息博弈。
一、标准式与纯策略 Nash 均衡
一个标准式博弈写成
其中 是参与人集合, 是玩家 的策略集合, 是收益函数。所谓战略互动,就体现在收益同时依赖自己的策略 和其他人的策略 。
给定对手策略 ,玩家 的最优反应集合为
策略组合 是 Nash 均衡,当且仅当每个人都在对其他人的实际选择做最优反应:
这只表示“别人不变时,我不愿单独改变”,不表示结果公平、合作或有效率。囚徒困境里双方坦白就是 Nash 均衡,却不是双方共同最好的结果。
收益矩阵的求解顺序
- 固定每一列,比较玩家 1 的收益,把最大值全部标出。
- 固定每一行,比较玩家 2 的收益,把最大值全部标出。
- 同一格里两个收益都被标出,它就是纯策略 Nash 均衡。
- 若有严格劣策略,可以迭代删除后再求,但不要把弱劣策略当作严格劣策略删除。
- 没有双标格子时,再进入混合策略。
占优策略要求一个行动面对对手的所有选择都最好;Nash 均衡只要求它在均衡点上是最优反应。前者更强,也更少见。
二、混合策略:用自己的概率让对手无差异
混合策略是纯策略上的概率分布。若某个纯策略在均衡中以正概率使用,它属于该混合策略的支集。支集内的行动必须带来相同的期望收益,否则玩家会把概率全部移到收益更高的行动上。
设玩家 1 以概率 选择第一个行动,玩家 2 以概率 选择第一个行动。求解时最容易写反的一点是:
- 用玩家 1 的无差异方程求 ;
- 用玩家 2 的无差异方程求 。
自己的概率不是用来让自己无差异,而是用来调整对手面对的收益,使对手愿意随机化。
以猜硬币为例,约定双方都可选正面 或反面 ,同面时玩家 1 得 、异面时得 ;若玩家 2 以概率 选择 ,玩家 1 的两个纯策略收益分别为
令两者相等得到 ;同理令玩家 2 无差异得到 。
多策略问题用支集枚举:猜支集、令支集内收益相等、加上概率和为 ,解完以后再检查概率非负,并确认支集外行动没有更高收益。Nash 存在性定理保证有限博弈至少存在一个允许混合的 Nash 均衡,但不保证它唯一或容易计算。
三、连续策略静态博弈:先求反应函数
离散矩阵用划线法,连续策略模型则用最优化。通用步骤是:
- 写出每位参与人的收益函数;
- 固定对手的选择,对自己的变量求最优;
- 得到反应函数;
- 联立反应函数求交点;
- 检查边界解和二阶条件。
例如 Cournot 双寡头同时选择产量,设
企业 的一阶条件给出
其中非负边界来自 。在 的对称内点情形,两条反应函数联立后得到
Bertrand 把策略变量换成价格;在同质产品、相同边际成本且无容量约束的假设下,轻微降价可以夺走市场,因此均衡被压到 。Hotelling、公共资源、税收检查和专利竞赛的故事不同,求解仍然是在找相互最优反应。
四、动态博弈:策略是一份完整预案
在动态博弈里,“行动”和“策略”不再是同一件事。行动是某个节点上实际做的一步;策略必须规定玩家在自己的每个信息集上分别怎样行动,包括均衡路径上不会到达的节点。
普通 Nash 均衡可能靠不可信威胁维持。SPNE 继续要求策略在每个子博弈里都构成 Nash 均衡,因此
有限完美信息博弈通常用逆向归纳:从最后一个决策节点开始,保留行动者最喜欢的分支,再逐层向前替换。写答案时不能只写最终路径,还要写出所有节点上的完整策略。
判断威胁或承诺是否可信,可以问:真的走到那个节点以后,执行它仍然是最优选择吗?口头宣称不会改变未来收益;不可撤销合同、预付沉没成本或主动减少未来选项,则可能改变后续节点的收益比较,从而改变 SPNE。
五、重复博弈与讨价还价
重复博弈增加的不是新行动,而是“根据历史决定下一期怎样做”的策略。有限重复与无限重复要分开看。
若阶段博弈只有唯一 Nash 均衡,有限重复博弈会从最后一期一路倒推,得到每一期都执行阶段均衡。若阶段博弈有多个均衡,最后一期可以根据此前历史进入不同均衡,从而提供可信的奖励与惩罚。
无限重复没有确定的最后一期。以贴现因子 计算收益时,冷酷触发策略下始终合作的现值为
当前背叛一次、以后永远受罚的现值为
合作可持续的条件是
做这类题时,先把“合作、当期偏离、惩罚”三种单期收益认清,再比较现值。惩罚路径本身也必须可信。
轮流报价谈判同样靠逆向归纳。若两人的贴现因子为 ,参与人 1 的均衡份额为
越有耐心,拒绝当前报价的成本越低,谈判地位越强。
六、动态应用:先算后手
Stackelberg 竞争、劳资谈判、关税和工作竞赛大多可以沿同一套逆向顺序处理。连续策略模型写成:
先求后手对每一种 的反应函数,再把它代回前手问题。投票议程虽然是离散选择,也沿着同样的逆向顺序从最后一轮向前比较。前手利用的不是“先动”三个字,而是一个可观察、不可随意撤回的选择怎样改变后手反应。
几个模型分别强调:
- Stackelberg:领头企业用产量承诺影响跟随者;
- 劳资谈判:工会定工资,企业沿劳动需求选择就业;
- 关税:政府先定政策,企业再竞争,单边最优可能造成共同损失;
- 工作竞赛:企业先设计奖金差,工人再选努力;
- 投票议程:先后顺序会改变后续选项,参与人还可能战略投票。
七、贝叶斯 Nash:把不知道的东西写成类型
不完全信息静态博弈中,自然先抽取类型 ,每个人知道自己的类型,却不一定知道别人的。Harsanyi 转换把这件事画进博弈树,但没有消除信息不对称。
这里的策略不是单个行动,而是从类型到行动的函数:
纯策略 BNE 要求每位玩家的每一种类型,都在自己的条件信念下最大化期望收益:
求解顺序是:列类型与共同先验,求条件信念,列出完整的类型相依策略,计算期望收益,最后找相互最优反应。不要直接在原故事上猜行为,否则很容易漏掉某个类型的行动。
一级价格密封拍卖是典型应用。 位风险中性投标人的估值独立均匀分布在 时,对称递增均衡为
报价低于估值,是因为中标以后还要保留正收益;参与人数增加会使报价更接近估值。
八、PBE 与信号博弈:策略之外还要写信念
动态不完全信息里,先手行动会泄露信息,后手会在观察后更新对类型的判断。因此一个 PBE 要同时给出
其中 是策略组合, 是各信息集上的信念。它至少要满足两件事:
- 给定信念和其他人的后续策略,每个信息集上的行动都序贯理性;
- 以正概率到达的信息集上,信念由 Bayes 法则和均衡策略共同确定;
- 路径外不能直接对零概率事件使用 Bayes 法则,但课件仍要求信念能由博弈结构解释,并在参与人之间采用同一套共同信念系统。更强的序贯均衡会进一步约束这类信念的来源。
信号博弈中,自然先选发送者类型,发送者观察类型后发消息,接收者观察消息、形成后验并行动。候选均衡通常分为:
- 混同:不同类型发送同一消息;
- 分离:不同类型发送不同消息;
- 半分离:至少一种类型随机化。
纯策略 PBE 可以按固定顺序检查:
- 枚举发送者的混同或分离策略;
- 用 Bayes 法则计算路径内信念;
- 在每个消息后求接收者的最优反应;
- 对每种发送者类型写激励相容条件;
- 对混同候选补齐路径外信念并重新检查;
- 汇总完整策略与信念,而不是只写均衡路径。
信号能否分离类型,取决于不同类型模仿它的成本是否不同。教育、资本结构和价格都可能成为信号,但信号方向必须由具体收益决定。本课价格模型中,好质量厂商为了获得第二期复购利润,会用第一期低价诱导试用;不能套用“高价一定代表高质量”的日常直觉。
PBE 对路径外信念仍可能比较宽松。直观标准会排除那些无论接收者怎样合理回应都不可能从偏离中获益的类型;序贯均衡和颤抖手精炼则用小概率失误进一步约束策略与信念。
九、最容易混淆的几组概念
| 容易混淆 | 区别 |
|---|---|
| 行动与策略 | 行动是当前一步;动态博弈的策略是覆盖全部信息集的完整预案 |
| 占优策略与最优反应 | 占优策略面对所有对手选择都最好;最优反应只针对给定选择 |
| Nash 与 Pareto 效率 | Nash 检查单方偏离;Pareto 效率检查能否让至少一人更好且无人更差 |
| 完全信息与完美信息 | 前者关心收益结构是否已知;后者关心历史行动是否完全可见 |
| Nash 与 SPNE | SPNE 还要求每个子博弈里的后续行动都可信 |
| BNE 与 PBE | BNE 对类型取期望;PBE 还要逐信息集写信念并检查序贯理性 |
| 路径内与路径外信念 | 路径内通常由 Bayes 法则确定;零概率路径外信息集需要另行给出一致信念 |
| 混合概率的求法 | 用自己的无差异条件求对手的概率,而不是自己的概率 |
十、一套自测流程
学完以后,可以不看答案依次做四类自测。
收益矩阵
能否先删严格劣策略,再用双向标记找全纯策略 Nash;若没有纯策略,能否写出双方无差异方程,并检查支集外策略?
博弈树
能否区分节点、信息集、行动和完整策略;找出所有子博弈;从末端逆推,并说明哪些威胁不可信?
重复与两阶段模型
能否把合作现值和单次偏离现值写出来;能否先求后手反应函数,再代回前手目标;能否检查惩罚或承诺本身是否会执行?
贝叶斯与信号博弈
能否列全类型相依策略;用先验求后验;分别检查接收者最优反应和发送者激励相容;最后补齐路径外信念?
十一、需要细看时去哪一讲
- 第一讲:课程分类与标准式
- 第二讲:纯策略 Nash 均衡
- 第三讲:混合策略 Nash 均衡
- 第四讲:静态博弈应用
- 第五讲:扩展式与 SPNE
- 第六讲:重复博弈与讨价还价
- 第七讲:动态博弈应用
- 第八讲:贝叶斯 Nash 均衡
- 第九讲:PBE 与信号博弈
- 第十讲:信号应用与再精炼
我把最重要的判断顺序集中在这里;时间有限时,可以先看这一篇,再回到对应分讲补完整例题。每遇到一个新模型,都重新检查三件事:信息结构是什么、谁在什么时候做最优反应、这个反应是否可信。