第 2 次作业 · SVM 鸢尾花分类
原始要求
以下要求来自课程的两项实验作业 PPT:
用 SVM 对鸢尾花数据分类,按 4:1 划分训练集和测试集;选取不同特征,尝试不同核函数和参数组合,标出准确率最高的模型。提交可复现报告,包括实验步骤、代码和结果。5 月 19 日前交到第二次作业目录,命名方式同作业一。
源目录保留了报告、数据集、两个 Notebook 和实验结果 Excel。下面的实现与数值从这些提交文件还原。
查看我的实现、结果与复盘
实验方法
提交稿读取 Iris 的四个特征:
| 编号 | 特征 |
|---|---|
| 0 | 花萼长度 |
| 1 | 花萼宽度 |
| 2 | 花瓣长度 |
| 3 | 花瓣宽度 |
程序每次选择两个特征,枚举三种核函数 linear、rbf、poly。报告正文列出的 是 0.1、0.5、1、10,实际代码还枚举了 0.8 和 5;测试集比例枚举 10%、20%、30%、40%、50%。所有划分使用 random_state=1。
核心循环可压缩为:
from itertools import combinations
from sklearn import model_selection, svm

for i, j in combinations(range(4), 2):
    features = X[:, [i, j]]
    for kernel in ["linear", "rbf", "poly"]:
        for c in [0.1, 0.5, 0.8, 1, 5, 10]:
            for test_size in [0.1, 0.2, 0.3, 0.4, 0.5]:
                x_train, x_test, y_train, y_test = (
                    model_selection.train_test_split(
                        features,
                        y,
                        random_state=1,
                        test_size=test_size,
                    )
                )
                clf = svm.SVC(
                    C=c,
                    kernel=kernel,
                    gamma="auto",
                    decision_function_shape="ovr",
                )
                clf.fit(x_train, y_train.ravel())
                train_acc = clf.score(x_train, y_train)
                test_acc = clf.score(x_test, y_test)
原代码把每组参数、训练准确率和测试准确率写入 Excel,再按结果比较。
报告给出的最佳组合
| 比较范围 | 核函数 | 特征 | 测试比例 | 训练准确率 | 测试准确率 | |
|---|---|---|---|---|---|---|
| 全部枚举 | RBF | 花瓣长度 + 花瓣宽度 | 0.1 | 10% | 97.04% | 100% |
| 遵守题目 4:1 | Linear | 花萼长度 + 花瓣长度 | 5 或 10 | 20% | 96.67% | 100% |
| 遵守题目 4:1 | Poly | 花萼长度 + 花瓣长度 | 5 或 10 | 20% | 96.67% | 100% |
提交报告把第一行总结为“训练集和测试集准确率同时最高”,并单独说明题目要求 4:1 时应看后两行。
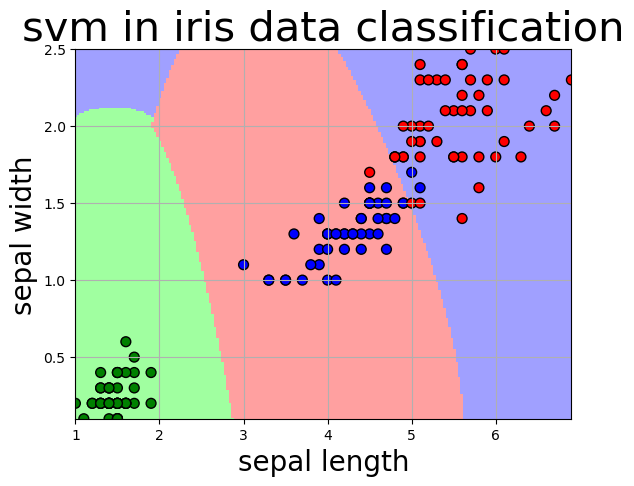
这张图来自原报告,坐标轴是花萼长度和花萼宽度,因此只用于展示二维 SVM 决策区域,不是上表“最高参数组合”的直接图证。
复盘:这些 100% 不能直接当最终泛化结论
原实现用同一个测试划分反复挑特征、核函数、 和测试比例,等于把测试集用于调参。最终再报告这批测试结果,会偏乐观。测试比例变小时测试样本更少,出现 100% 也更容易,不能据此推出“训练集越大,模型就普遍越准”。
若今天重做,应当:
- 固定独立测试集,只在训练集内部交叉验证选参数;
- 把
StandardScaler和SVC放进同一Pipeline; - 使用分层划分维持三类比例;
- 选定模型后只对测试集评估一次,并同时报告混淆矩阵;
- 若比较二维特征组合,应区分“为了画图”与“追求最优分类性能”。
以上是根据留存文件做的复盘,不改写当年的提交结果。