一些经验和认知
1. 对 LLM 的理解
1.1 Goal & Philosophy
- LLM 只有两个最核心的目标,提升能力 [capability](解决更多的问题)和对齐偏好 [alignment](符合多数人类/专家的体感)
- 对应两个目标,实现的方式分别为 capability => scaling,alignment => rlhf
1.1.1.1 The Bitter Lesson - Scaling - Capability
- 从长远来看,提升模型能力唯一重要的事情是充分利用计算能力。这背后的原因在于摩尔定律带来的单位算力成本持续指数级下降的趋势,同时世界的复杂度是人难以去精确刻画的
- 心智的实际内容是极其复杂、无法挽回地复杂的;我们应该停止试图寻找思考心智内容的简单方法,例如思考空间、物体、多智能体或对称性的简单方法。所有这些都是任意的、内在复杂的外部世界的一部分。最终的突破性进展往往来自于那些侧重于大规模计算的方法,这些方法利用搜索和学习。我们不应该试图在我们的智能体中构建关于世界的复杂先验知识,因为世界的复杂性是无穷无尽的,而我们对它的理解是有限的。我们应该专注于那些可以让智能体自主学习和发现这些复杂性的通用方法
- 按照经验,可以 scale 的方法,一定是极为简单的方法
1.1.1.2 Character Training - RLHF - Alignment
- 开发 AI 模型的公司通常会训练模型避免说出有害的话语,但是当我们思考那些真正令人钦佩的人的性格时,我们想到的不仅仅是避免伤害。我们会想到那些对世界充满好奇的人,那些努力讲真话而不刻薄的人,那些能够多角度看待问题而不过度自信或谨慎的人。我们会想到那些耐心倾听、细心思考、风趣幽默的谈话者,以及许多其他我们认为与睿智和能力全面的人相关的
- 人格训练的目标是让模型开始拥有更细致、更丰富的特质,例如好奇心、开放的心态和体贴的思维
1.2 LLM Stages
-
Pre-Training(预训练)
- 预训练通过 NTP(next-token-prediction) 天然地刻画了几乎所有自然语言任务,本质是让模型能够获取多样的知识和能力,学习不同的人的做事方式
- 预训练固定数据分布的情况下,loss (pass rate) 随模型大小和训练数据量经验性地符合 scaling law
- 在固定模型大小和数据量的情况下,数据分布(尤其是数据质量)决定了 scaling curve 的形状。同时由于模型的整体 scaling curve 为多个不同 domain 的 scaling curve 的加权平均,且不同 domain 的 scaling curve 和平均 scaling curve 呈线性关系,更进一步地说,数据分布决定了不同 domain 的 scaling curve 的形状,即模型参数如何分配。在固定的 model capacity 下,改善数据质量本质上代表对高质量数据分配更多的 model capacity 并使得模型在这部分数据上收敛到更低的 loss,最终对高质量内容产生记忆
-
Post-Training(后训练)
- 后训练通过 SFT (NTP) & RL,深度激发/组装模型多样化的知识和能力,塑造模型成为不同领域的专家,激发模型的优良特质,实现基于反馈的能力提升,并让模型成为真正令人钦佩的人
- 后训练固定数据分布的情况下(特指 RL【SFT 待确认】),pass rate 随熵(等同于 ppl)和输出长度经验性地符合 scaling law
- 在固定预训练模型的情况下,后训练本质是对模型参数利用的重分配,让模型能够提升在特定能力/Pattern 上的概率,并削弱在非期望输出上的概率。因此,后训练需要覆盖广泛的任务,构造高质量数据,提供准确的反馈信号,从而提升模型在不同下游任务上的效果
- Alignment 的上限取决于监督信号的区分能力,RLVR(verifiable reward)相比 RLHF(human feedback) 的核心差异在于监督信号的准确性 。因此,RLVR 通过程序/规则给出准确的监督信号,它的上限是模型在特定 entropy/length 下的 scaling 上限;RLHF 通过强人工来给出监督信号,它的上限是人工分辨模型输出的上限;RLAIF 通过强模型近似强人工,它的上限为强模型区分模型输出的上限
-
Bridge - In Context Learning(ICL, 上下文学习)
- 模型的 RL scaling curve 取决于 SFT 激发的 pattern,SFT 是否能够成功激发某种 pattern 取决于预训练模型对 pattern 的熟悉/覆盖程度(即 pattern 对于 SFT 模型来说是高确定性的)
- 一个相对经典的认知是,in-context learning 等价于模型在给定的 few-shot instances 上做 SFT。进而推导出,预训练模型在特定任务的 Few-Shot Pass@K 等于 SFT 模型激发后的 Zero-Shot Pass@K
- 但是考虑到上述的认知,这里遗漏了两个变量,即 entropy 和 output length。因此,还需要保证预训练模型在 few-shot 下的 entropy/output length 和后训练激发后的分布近似,这样两者才能可比
1.3 Scaling
1.3.1.1 什么是好的 Scaling
- 和 Scaling 对应的是成本,好的 scaling 对应的是更优的效果/成本兑换
- 对于预训练,好的 scaling 代表在同 model size & data size 下,达到更好的效果
- 对于后训练,好的 scaling 代表在同 entropy & length 下,达到更好的效果
1.3.1.2 Reasoning scale v.s. Round scale
- 思考长度和工具调用轮次本质是 scale 的两个不同维度,其中思考是连续的,工具是非连续的
- 将模型优化看作是带约束的最优化问题,可以通过拉格朗日乘子法将目标转化为加权求和的单一优化目标。对 think budget & round budget 权重的设置决定了模型的优化目标,进而影响最终的输出 pattern
=>
1.3.1.3 后续应该 scale 什么
- 相对 trivial 的:模型大小、数据量(多模态也可以看做是数据的 scaling)
- 相对 non-trivial 的:任务类型(query 自身、模型可利用的 scaffold【tool set、prompt、memory】、以及模型外部的环境【sandbox】)、输出长度(length & round、memory/summary/parallel thinking)、经验(从经验中学习【online learning】,和 ICL 是对立统一关系;自主利用外部信息【self learning】;personalization 可以看做是一种从经验中学习的方式)
1.4 其他
1.4.1.1 知识 v.s. 推理
- 推理是可以泛化的,知识是不能泛化的;[26.5.10 更新] 推理泛化的是方法,即 pattern(如数学解题的方法);[26.5.10 更新] 针对 agent 场景,因为 interleave tool calling 本质是在一步一步做事情,做事的逻辑也是可以泛化的,做事中也存在很多方法论,这些都是可以泛化的
- 证据是纯知识榜单在预训练和后训练基本持平,非特定数据(测试集本身)无法对结果产生影响。而推理(如数学、代码等)可以通过泛化来优化,泛化的过程体现在 n-gram pattern 的迁移
1.4.1.2 泛化
- 数据少的时候考虑泛化
- 大模型时代不应该过度关注泛化,应该考虑用覆盖的方式解决泛化的问题
1.4.1.3 相关性 v.s. 因果性
- 相关性不等于因果性,应该对因果性做干预,而不应该对相关性做干预
- 一个典型例子是对 rl 中的 entropy 做干预,可能缓解模型崩溃,但并不本质;本质的是训推不一致
2. AGI 的理解
2.1 定义
有空补一补
| 层级 | 名称 | 描述 | 目标 |
|---|---|---|---|
| L1 | Chatbot | 擅长对话任务、理解自然语言、通过以类似人类的方式参与对话以及根据用户指示执行任务 | 解决普通人需要几分钟到几十分钟能够完成的任务 |
| L2 | Reasoners | 类似拥有博士学位的人的问题解决能力,尽管没有专门的工具,但可以处理需要跨各个领域的逻辑推理和复杂的上下文理解任务 | 解决博士需要几十分钟到几天能够完成的任务 |
| L3 | Agents | AI 系统表现出更大的自主性,代表用户执行任务和做出决策,从被动转为主动,无需人类监督 | 解决领域专家需要几天到几周能够完成的任务 |
| L4 | Innovators | 自主为科学、医学等特定领域产生创新 - 为现有问题创造新颖的解决方案,并解决以前看似不可能的问题 | 解决人类顶尖专家需要几月到几年能够完成的任务 |
| L5 | Organizations | 能够执行整个组织的集体职能的 AI 系统。这些系统管理复杂的工作流程,并跨职能和部门大规模监督多个项目,即能够处理各样的任务 | - |
2.2 北美的关注点
2.2.1 做事方式
| OpenAI | Anthropic | Google DeepMind | |
|---|---|---|---|
| 做事方式 | 自底向上,技术主导,创新驱动 | 自顶向下,产品导向,模型即产品 | 自顶向下,委员会形式,理念主导 |
| 产品形式 | C 端 ChatGPT / Codex | B 端 Claude API,C 端 Claude Code | C 端 Gemini & 谷歌生态,B 端 API |
| 模型形式 | 针对内部场景优化,不考虑过拟合 | 考虑外部广泛场景,重视过拟合和泛化 | 针对内部场景优化,不考虑过拟合 |
| 团队形式 | 研究员做 prototype 研究 有效果之后组织逐渐加人形成团队 | 自顶向下规划做事方向 数据、算法、工程、产品等紧密协作 | 自顶向下规划做事方向 细节未知 |
2.2.2 模型能力
| OpenAI | Anthropic | Google Deepmind | |
|---|---|---|---|
| Reasoning | 强调将规模化无监督学习与显式推理相结合,并相信它们将在未来的模型中相互补充。可以可靠地链接“数十个工具调用”以完成多步骤任务 | 引入 hybrid reasoning 以及 extended thinking。Opus 4 和 Sonnet 4 都可以产生并行推理路径,甚至可以通过在多步骤任务期间向文件写入注释来保持长期“记忆” | 推出 DeepThink 模式,它并行生成多个人工智能智能体来探索不同的解决方案路径 |
| Planning & Agents | 投入高级推理。ChatGPT 已能用工具(插件、代码执行)——迈向自主代理。预期 ~1 年内代理可可靠处理多日任务 | Claude 面向长时、复杂任务并支持工具使用。聚焦“安全的代理” | 借助其强化学习专长赋能 LLM 规划。Project Astra 致力于可在现实中行动的通用助理(如手机、AR 眼镜)。已在 Google 产品中嵌入代理 |
| Search & Research | 首先推出 deep research,在研究类场景下效果极好,尤其在 deep search 类型任务上有良好的表现,但是由于搜索引擎不够优秀,有时在信息实时性上效果不佳 | 推出 Claude research agents,能够解决现实生活中的研究类问题 | 紧随 oai 后面推出 gemini deep research,同时支持 ppt 输出等方式。结合 google 搜索能力,在 wide search 表现较好 |
| Memory & Context | 快速扩大上下文窗口。探索用于长期记忆的检索插件。在用户可控前提下,模型能跨会话持续学习与记忆 | 推出“memory files”实现持久记忆——模型可写入并在后续调用关键信息。优先隐私(默认不使用客户数据训练)与长时一致性 | 同样推动超长上下文。与 Google 知识图谱/搜索整合以增强事实召回;强调面向个人助理的设备端记忆(本地加密存储) |
| Multimodal | 为 GPT-4 新增了图像与语音输入;可能继续扩展到更丰富的模态(目标:能“看见并对话”的 AI) | 对多模态持谨慎态度——目前主要聚焦文本。更重视安全与对齐,认为在对齐问题解决后才会采用图像/视频 | 把多模态作为核心优先级——Gemini 自底向上为文本、图像、音频、视频而建。相信整合感知能提升真实世界推理 |
2.2.3 发力方向
| OpenAI | Anthropic | Google DeepMind | |
|---|---|---|---|
| Coding | GPT-5 被训练成“真正的编码伙伴”,擅长生成和调试代码,并处理复杂的多文件代码 | Opus 4 和 Sonnet 4.5 在软件工程基准测试中处于领先地位。在改进多文件代码编辑和复杂调试领域表现较好,在重构过程中提高了代码质量 | Gemini 不仅可以生成代码,还可以生成交互式应用程序;同时 AlphaDev 和 AlphaEvolve 项目使用 AI 来发现超越人类已知算法的新算法 |
| Law & Legal | GPT-4 已通过律师资格类考试,OpenAI 技术正为法律类 AI 工具提供动力(如用于合同分析的 Harvey)。与律所合作开发用于检索与撰写的 AI 助手 | 正与律所及供应商合作,部署 Claude 用于尽职调查、证据摘要与合同条款建议。强调保密性与可靠性——将 Claude 定位为可信助手,能拒绝不道德请求,并保护数据隐私。Claude 对 “道德一致性和合规性” 的关注使其对信任至关重要的法律和政府环境具有吸引力 | 本身并非直接做法律产品,但通过 Google Cloud 与 Workspace,把 AI 融入律师日常工具(Docs、Gmail 起草,Search 用于法律检索)。开发强大的判例法数据库搜索 |
| Finance | 与金融机构深度合作(如摩根士丹利用 GPT-4 为投顾打造助手)。模型用于研究综述、报告生成与客户沟通。可能推出金融微调模型或行业插件。愿景是减少分析师的重复劳动,并从数据洪流中挖掘洞见 | 面向企业金融客户:提供“Claude for Financial Services”,并接入金融数据连接器。Claude 能在一次提问中处理海量财报,帮助建模与撰写尽调摘要。强调可审计性(回答可链接到来源)与合规性(默认不以机构数据训练模型)——对金融行业至关重要 | 通过 Google Cloud 切入金融(提供模型与基础设施)。面向金融的微调模型(Finance-PaLM)。将 AI 融入 Sheets(预算/分析),并用于反欺诈与风控(模式识别)。Gemini 的多模态能力可分析非常规金融数据(图像、社交趋势)以辅助投资洞见 |
| Healthcare | 与医疗机构合作部署 AI 助手(如医生问诊自动成文的 “AI 书写员”、面向患者的分诊聊天机器人)。重点在扩大可及性同时确保安全(如关键决策必须由医生监督) | 积极参与医疗政策(签署 CMS 承诺)。目标是用 Claude 打通割裂的健康数据——例如在获得授权下整合多机构记录,形成患者全貌。设想面向患者与临床医生的 AI 助手,能在获得同意后安全访问病历并以通俗语言解释复杂医学信息。高度重视隐私与避免有害建议 | AlphaFold 推动药物发现变革;还打造了 Med-PaLM 2,正与医院试点 Med-PaLM 协助医生。Google 也在面向消费者健康领域整合 AI(如症状检查、皮肤科应用)。Gemini 的愿景是多模态医疗 AI(同时分析影像如 X 线与文本)。预计 AI 将显著加速生物医药研究,并成为普适的医疗助手(相关监管审批在推进中) |
| Education | GPT-4 已用于辅导(Khanmigo),以“引导解题”而非直接给答案。OpenAI 正努力确保面向学生的回答事实准确且适龄。发展个性化辅导的潜力,同时与教师合作将 AI 融入课程(发布教师使用指南) | 推出 “Claude for Education”,配备“学习模式”,以培养批判性思维。与东北大学、伦敦政经等合作,面向全校师生部署 Claude。Claude 可辅助写作、反馈与制作学习资料,同时通过“苏格拉底式”提示鼓励独立思考 | Google 的 AI 已深嵌教育生态(Classroom、Search)。提供实时学习支持:如 Search 的作业辅导能逐步讲解。Docs/Slides 新功能帮助教师备课与学生写作。愿景是普惠知识获取。强调全球规模化(尤其覆盖使用 Android 设备的欠发达地区),并为教师提供监督 AI 使用的工具(如原创性报告检测 AI 生成内容) |
| Science & Engineering | 最早推出 deep research 功能。同时,通过学术加速器与大学合作,在研究环境中探索 GPT。OpenAI 的推理模型擅长在生物学、数学和工程环境中生成和批判新假设 | 通过 research agent 可以阅读论文并进行全面的文献综述。是 Anthropic 相对薄弱的环节 | 有一整个部门致力于“科学人工智能”,提出 AlphaFold、AlphaCode 等 Alpha* 方法。DeepMind 正在将 Gemini 的语言推理与天气、化学、材料等模型相结合 |
3. 如何提升模型特定能力
3.1 [26.5.10 更新] 方法论
- 所有做事应该从目标出发(如优化模型 coding 能力),将目标变为可观测指标(benchmark);观测可以从开源寻找,也可以自己构建,保证和目标对齐;观测的上限往往决定了做事的上限,例如只观测 swe-bench,那么就只会考虑对 bugfix 类型任务在 python 语言下的效果,最终使得模型优化有偏
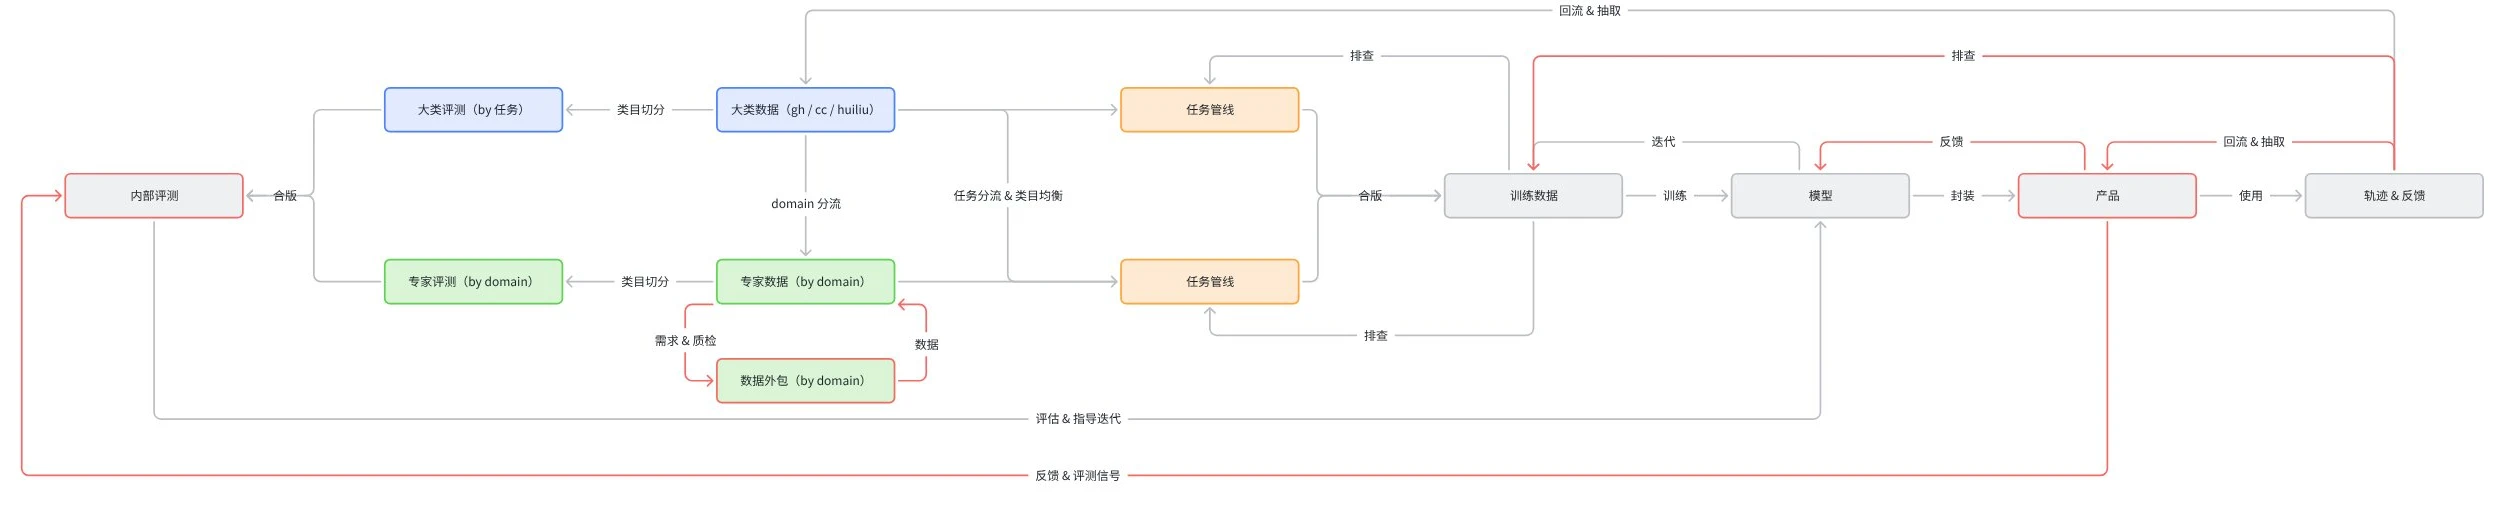
- 做事一般分为正向和反向,其中正向做事旨在大面覆盖已知的场景,反向做事旨在持续解决观测到的问题。做事初期一般从正向出发,以大面覆盖的方法尽可能定义所有细节(如 coding 能力下的所有职业 x 编程语言 x 任务类型),从分布上覆盖定义,形成通用管线,进而形成初版模型并得到观测。之后,做事上会分化为两部分:(1) [正向] 基于先验迭代通用管线(例如数据变得更多样、变得更长更难、做 rl);(2) [反向] 基于观测结果发现的问题,进行分析和解决(例如基于社媒上反馈的偷懒问题反向检测数据管线问题,或者基于回流反馈的问题发现垂类没有覆盖)。上述这两种方式,可以同时作用到算法和数据上的迭代。
3.2 SFT
- 然后列出当前所有可能影响结果的变量,从单条数据上,数据本身的质量、结果是否正确、过程是否正确;从数据分布看,训练集和测试集分布的相似度、训练集难度分布、训练集轮数分布;
- 之后分析训练集 query 的覆盖程度,计算和评测集 QA Embedding 相似度,需要确保不存在评测集的离群点,如果存在离群点则扩充 query 集合以达到覆盖。QA Embedding 用某个开源强模型即可,对模型要求不高
- 接下来确保训练集的 response 质量,其中质量不仅包括结果的正确性,同时包括过程的符合专家偏好、不存在极端 token、不存在语言/语义问题、不存在幻觉(如工具幻觉)。其中专家偏好在不同领域的含义不同,例如 reasoning 为解题过程的风格和逻辑性、agent 为调用工具的正确性,需要遍历一些中间变量得到期望的结果
- 最后进行 qa 分布配比。在难度分布上,基于 pass rate 的难度均匀相对较好,这样整体分布更适合模型学习。其中简单题(pass rate = 1)尽量占比小于 20-30%,中高难的题目尽量提升占比(可通过上采样 unique query 或者 1q5a-1q6a)。此外,1qna 相比 1q1a 多 epoch 能够带来更好的结果,但是更多的 unique query 1q1a 好于重复 query 的 1qna,因此在 query 足够多时 1q1a 扩 query 即可。Reasoning 应尽量为简单问题提供简短回答、复杂问题提供更长的回答。Agentic 尽可能保证轮次均匀,长轮次数据的收益极大。
3.3 RL
- RL 和 SFT 基本一致,RL 更重要的是对指标的观测(如 entropy / p95 response length);更多的指标观测能够带来更加本质的认知,同时促进算法的优化
- 相比 SFT,RL 应该采用更加复杂且没训练过的 query 分布覆盖评测集,同时在训练过程中过滤有问题的 response(尤其是正例)。在难度分布上,最理想的情况是保证难度分布始终在 0.3-0.6 区间,即对于模型来说是 learnable 的,超过 0.7 的 acc 往往会带来模型训练的不稳定
- 更重要的,RL 应尽量保持一个稳定的分布,体现在训练过程中统计量的变化。相对重要的统计量包括 grad norm、optimizer norm、极端 token 的概率分位数、训练 policy 和采样 policy 的距离【off-policy 程度】(用 kl 散度或者 prob diff 度量),应尽可能保证这几个统计量整体平稳,或者呈现周期性变化。对于 entropy 和长度等指标,应观测到模型效果随这几个指标变化带来的训练 acc 的变化
- 模型的 RL scaling curve 由训练分布、优化目标、以及 SFT 的 pattern 决定,其中训练分布影响对模型参数的分配以及对下游指标的泛化(train v.s. test)、优化目标影响 train acc 的收敛点同时影响 pattern 的选择(带约束的最优化问题)、SFT 影响 RL 组装 pattern 的搜索空间(尽管可以将 RL 看作搜索问题,但是当 SFT 的好pattern 被淹没在众多的坏 pattern 中时,RL 需要通过极大的搜索计算量才能够完成 pattern 的筛选。因此 SFT 应尽可能预先提供一个/若干好的 pattern 作为 base)
- RL 算法优化的核心目标是,如何用更少的训练成本达到相同的最终状态,以及如何能够让模型充分消耗 entropy 和 length(因为 naive 算法很可能无法让 entropy 下降到更低的位置,也无法让 length 充分上涨)
3.4 其他
- 比较正确的做事方式是先通过大盘覆盖来提升能力,做到 60 分;之后通过评测集反推提升定向指标,做到
10080 分 - 【26.5.10 更新】优先正向做事,之后通过观测/反馈(如监控指标、数据回流、网络反馈)找到当前的问题,之后再逐一解决问题
- 如何判定蒸馏哪个大哥:在评测集上用不同大哥模型蒸馏,看哪个效果更好
4. 如何做实验
TBD
5. 以往的经验和教训
- 目标导向的做事方式会更清晰明确。相对简单的目标会方便做取舍。目标要定的够高,低的目标只会带来更低的结果。需要自顶向下的规划,自底向上的规划会跑偏或者雕花。决策要有记录,没有记录的决策无法复盘和提升
- 打开链路的每个环节是做到高水平的必要条件,通常只要能关注到每个环节(尤其是链路的第一环 [query 覆盖、网页解析] 和最后一环 [去重]),并进行思考和优化,而不是 take for granted,算法效果就能有显著的提升。在这个过程中,文档质量很重要,不仅能暴露想法(尤其是有问题的想法)、共享有用的结论,更能够方便其他人进行 review
- 很多迭代是基于结果的,所以基于实验和评测(以及观测)的优化是尤为重要的。在做任何事情时,不用一开始就构建复杂评测集,10 个小问题已经足够(除非有开源);社媒是好的测试集;一些实验被认为没效果可能仅仅是因为评测不够完备;比较正确的做事方式是先通过大盘覆盖来提升能力,做到 60 分;之后通过评测集反推,做到
10080 分 - 应该以项目制来做事,项目制指不同方向的同学(包括但不限于算法、工程、评测、产品、优化)一起为一个统一的目标负责,而不是拆解子任务外包给横向团队(如区分算法、工程);这时候就依赖参与项目的所有人理解项目目标,并对其他方向的工作细节有一定程度的了解
- 尽量做能够长期能够 scale 的事情,不要做临时打补丁的工作;长期能够 scale 的事情指,做这件事情是有规划的,当前做的经验/结果能够给后续迭代带来 inisight,且能够扩展到更大量级/更多方向;临时打补丁的事情不能给后续带来 insight,同时可能为后续迭代给出错误的归因和结论
- 长期更能够 scale 的事情往往基于更形而上的理念,如提升模型智能、提升模型自主性,而不是某些特定任务
- 向下一层能够有积累的事情,对应的是某个领域的深耕(如 code)、某个模块的深耕(如 RL),它的结果可能能够迁移到其他领域,但是需要做这个事情的人有深刻的认知
- 变化快的东西不要搞重的工程化,重工程化的事情只适合相对成熟的方向和做归档
- 有门槛的只有工程化规模化的产物(如数据、基建),算法是没有门槛的
- 尊重评测、尊重 timeline