第 14 讲:分页、页表与 TLB
分页的关键不是“把内存切小”,而是逻辑上连续的地址空间,可以映射到物理上分散的等大块。程序依然看见从 0 向上的连续地址,OS 却能够从任意空闲页框中拼出它。
页、页框和页表
- 页(page):虚拟地址空间中的固定大小块;
- 页框(frame):物理内存中的同大小块;
- 页表:从虚拟页号 VPN 到物理页框号 PFN 的映射,并附带存在位、读写执行权限、访问位、修改位等状态。
基本分页不需要每个进程的页框彼此相邻,因而消除了连续分配的外部碎片。最后一页通常装不满,仍会有页内碎片。
若进程运行前所有页都必须装入、运行中没有请求调页和页面对换,课件称为纯分页。第 16 讲的请求分页复用同一套页号—页框映射,再增加驻留位、后备位置和缺页处理,不能把“分页”与“虚拟内存”直接当成同义词。
地址拆分和转换
页大小 字节时,虚拟地址 可拆为:
查页表得到 后:
因为 是 2 的幂,硬件不需做真正除法:低 位就是页内偏移,其余高位就是页号。
完整算例
设页大小为 4 KiB,虚拟地址为 0x00005ABC,页表将 VPN 5 映射到 PFN 0x12。
- 4 KiB B,偏移占 12 位;
0x5ABC = 0x5 * 0x1000 + 0xABC;- VPN =
0x5,offset =0xABC; - PFN =
0x12; - 。
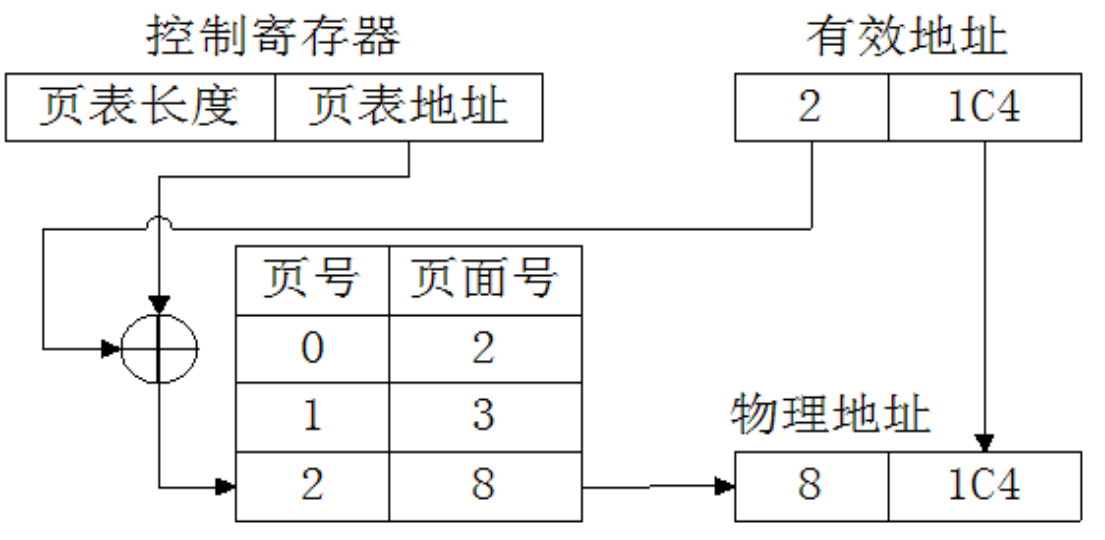
偏移在转换前后不变,只是页号被页框号替换。
课件中的地址转换图把硬件动作串在了一起:先由页号定位页表项并检查越界,再用查出的页框号替换页号,页内偏移原样带到物理地址。
页表本身放在哪里
页表通常在内存中,PCB 或架构寄存器保留当前页表根。于是一次数据访存变成:
- 访问页表项;
- 再访问目标数据。
这样性能几乎减半,TLB 就是为了缓存近期页表项而存在的。
页面大小的权衡
| 小页 | 大页 |
|---|---|
| 页内碎片较少 | 页表项数较少 |
| 页表更大 | TLB 一个项能覆盖更多字节 |
| I/O 单次调页量小 | 顺序/大块访问更高效 |
| 稀疏、小粒度保护更灵活 | 不必要调入更多数据 |
页大小是硬件与 OS 共同的设计参数,不是越小越精细就一定越好。
为什么要多级页表
32 位虚拟地址、4 KiB 页时:
每个进程需要 个单级页表项。若每项 4 B,页表是 4 MiB,即使进程只用了很少地址,也要为整个空间准备它。
两级页表将 32 位地址拆为常见的 10 | 10 | 12:
页目录索引  页表索引  页内偏移
10 bit 10 bit 12 bit页目录项指向二级页表。某一大片虚拟空间没被使用时,对应二级页表根本不用创建。它节省的是稀疏地址空间的页表存储,代价是 TLB 未命中时要逐级访问。
页表自映射:OS 怎样用虚拟地址访问页表
页表在物理内存里,但开启分页后,内核自己访存也要给出虚拟地址。常见技巧是在页目录中保留一项,让它指向页目录自身所在页框:
- 当虚拟地址的一级索引落到这项时,硬件会把页目录当作下一层页表;
- 改变二级索引,就可把各张页表映射进一段固定虚拟窗口;
- 一级、二级索引都选自映射项时,还能映射到页目录自身。
这样内核无需为每张页表另存一套临时映射,就能按固定公式定位 PDE/PTE。总复习课件中的 32 位两级页表示意正是在说明这种递归映射;它不是多分配一份页表,而是让已有页表在自己的地址空间中“可被看见”。
TLB:页表项的高速缓存
TLB 通常以 VPN 和 ASID 作为标签,记录 PFN 与权限。
- TLB 命中:立即得到 PFN,然后只访问目标内存;
- TLB 未命中但页表有效:硬件或 OS 走访页表,填充 TLB,重试访问;
- 页表项显示不在内存:这才是缺页,需要进入虚拟内存处理;
- 权限不允许:是保护异常,不是用换页就能修复的缺页。
不要把 TLB miss 和 page fault 混在一起。前者只是快速缓存里没有转换记录,页面可能一直在 RAM;后者才可能需要慢得多的磁盘 I/O。
有效访问时间算例
设 TLB 查询 ns,内存访问 ns,命中率 ,且忽略缺页:
未命中路径比命中路径多一次页表内存访问。多级页表未命中时,还要按级数增加页表访问次数。
ASID 用来区分不同进程的相同 VPN,可避免每次进程切换都把 TLB 全部清空。
哈希页表与反置页表
哈希页表
用虚拟页号做哈希,桶里的链表项保存 VPN -> PFN。适合巨大而稀疏的地址空间,查找时在对应桶中核对 VPN。
反置页表
传统页表是每个虚拟页一项;反置页表是每个物理页框一项,项中记录当前装的 (PID/ASID, VPN)。
- 页表总大小与物理内存大小有关,不再跟每个进程的虚拟空间成正比;
- 但查询是用
(PID, VPN)去找哪个 PFN,与表的物理顺序相反,通常需要哈希和 TLB 加速; - 共享页的表达也要额外处理,因为同一 PFN 可对应多组虚拟名称。
共享与保护
两个进程可将各自页表中的不同 VPN 指向同一 PFN,从而共享动态库或共享内存。同一页表项上的权限位又可以表达:
- 只读代码页;
- 可读写数据页;
- 用户/内核可访问性;
- 可执行与禁止执行。
访问每一页时都由 MMU 检查,所以分页同时提供了地址转换、隔离、共享和粒度统一的保护。
做地址转换题的顺序
- 由页大小求偏移位数;
- 按题目给的多级宽度切分虚拟地址;
- 逐级查表,每一级都要检查存在位/越界/权限;
- 最终得到 PFN 后与原 offset 拼接;
- 若问内存访问次数,分清 TLB 命中、未命中与缺页三条路径。