第六讲 · 单周期 MIPS CPU
对应材料:2024 PPT“ MIPS 处理器设计——单周期”,并用 2025 复习提纲的 CPU 模型对比核对范围。
单周期 CPU 的规则只有一句:一条指令从取指到写回,全部在一个时钟周期内完成。
这不等于“每条指令只有一个动作”。lw 仍然要取指、读寄存器、算地址、读数据存储器、写回寄存器;只是这些组合逻辑必须在同一个时钟边沿之间跑完。
1. 先分清状态与组合逻辑
单周期数据通路中:
- 状态元件:PC、寄存器堆、存储器;它们保存跨周期可见的信息;
- 组合逻辑:加法器、扩展器、ALU、MUX、控制器;输入确定后,经过传播延迟得到输出;
- 时钟边沿:把本周期计算出的下一 PC、寄存器写回值等提交到状态元件。
可以把一个周期理解为:
边沿后读出旧状态 → 组合逻辑传播 → 边沿前形成新状态 → 下一边沿写入2. CPU 的七个核心部件
| 部件 | 主要输入 | 主要输出 | 职责 |
|---|---|---|---|
| PC | 下一 PC | 当前指令地址 | 保存控制流位置 |
| NPC | PC、立即数、寄存器跳转地址 | PC+4、分支/跳转目标 | 计算下一 PC |
| IM | PC | 32 位指令 | 取指 |
| RF | rs/rt、写地址、写数据 | 两个寄存器值 | 读操作数、写回 |
| EXT | imm16、扩展方式 | 32 位立即数 | 符号/零扩展 |
| ALU | 两个 32 位操作数、运算控制 | 结果、Zero | 运算、比较、算地址 |
| DM | 地址、写数据、读写使能 | 读数据 | load/store |
课件把指令存储器 IM 与数据存储器 DM 分开。这样同一周期既能取下一条指令所需的指令,又能为当前指令访问数据,避免结构冲突;从系统角度看,可把它理解为分离的指令/数据 Cache 接口模型。
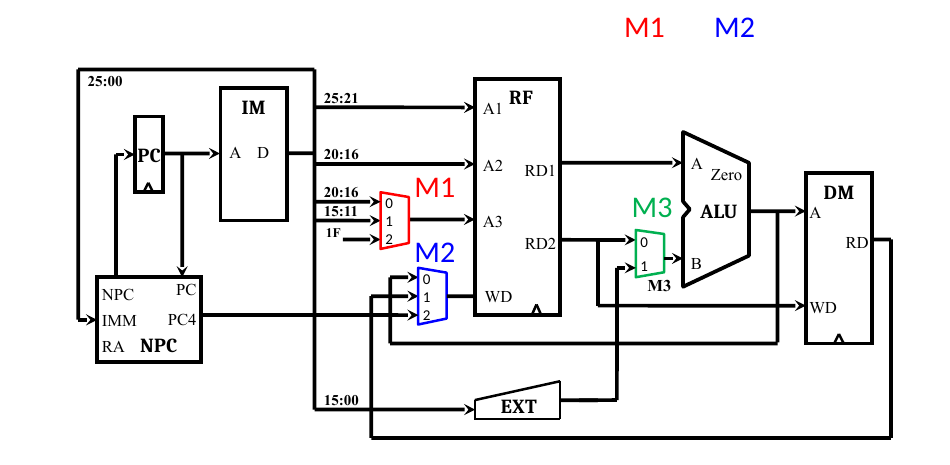
图中只截取 2024 单周期课件的数据通路主体。M1、M2、M3 是多路选择器:分别选择写寄存器编号、写回数据和 ALU 第二操作数。
2.1 课件的设计方法:先独立建模,再综合
课件没有让人直接照着大图连线,而是强调三条设计原则:
- 机制与策略分离:PC、RF、ALU、DM 等部件提供可复用机制,控制器按指令选择策略;
- 高内聚、低耦合:每个部件职责集中,部件之间只通过清楚的输入输出连接;
- 指令级独立建模:先由每条指令的 RTL 推导自己的连接与控制,再求并集、为多来源输入增加 MUX。
课程使用的 MIPS-C0 子集以 addu/subu/ori/lw/sw/beq/jal/jr 等代表性指令覆盖运算、访存和控制流。完成每条指令的数据通路表后,再合并相同部件、归并输入来源并综合控制信号;这样增加新指令时能明确看见需要改哪个接口,而不是在整张图上试错。
3. RTL:先把指令功能写成“数据去哪儿”
寄存器传输级语言(RTL)不关心具体门电路,只精确描述状态变化。例如:
设计数据通路时先写 RTL,再从结果向前倒推需要哪些部件与连接。这比盯着一张大图背线可靠得多。
4. 五个阶段是功能分解,不是五个周期
课件把指令执行分成:
- IF:取指令、计算 ;
- ID:译码、读寄存器、扩展立即数;
- EX:ALU 运算、地址计算或比较;
- MEM:访问数据存储器;
- WB:结果写回寄存器堆。
在单周期 CPU 里,这五段只是同一个周期内的逻辑先后关系。某些指令不需要全部阶段,例如 sw 没有 WB,R 型指令不读 DM;但时钟周期仍按最慢的完整路径统一设置。
5. 用倒推法建立每类指令的数据通路
5.1 R 型:addu rd,rs,rt
最终要写 ,倒推:
- RF 写地址选
rd; - RF 写数据来自 ALU;
- ALU 做加法;
- ALU 两个输入来自 RF 的
rs、rt; - IM 输出指令字段;PC 顺序更新到 。
正向数据流为:
PC → IM → rs/rt → RF → ALU(add) → RF[rd]
 \→ NPC(PC+4) → PC
subu/and/or 的连接完全相同,只改变 ALU 控制。这就是把“机制”和“策略”分离:硬件路径复用,控制器选择具体运算。
5.2 I 型运算:ori rt,rs,imm16
与 R 型相比只改两处:
- ALU 第二输入不再来自 ,而来自零扩展立即数;
- RF 写地址由
rd改选rt。
因此要增加 EXT,并在 ALU.B 与 RF 写地址前放 MUX。
5.3 lw
从写回倒推:
RF[rt] ← DM 读出值
DM 地址 ← ALU 结果
ALU ← R[rs] + signext(imm16)
所以 lw 需要两级串行的“大部件”:先 ALU 算地址,再 DM 读数据。它通常成为单周期 CPU 的关键路径。
5.4 sw
sw 的地址计算与 lw 相同,但方向相反:
- DM 地址来自 ALU;
- DM 写数据来自 ;
- 打开存储器写使能;
- 不写寄存器堆。
若误开 RF 写使能,指令虽然完成了存储,还会意外破坏寄存器。这说明“不需要的写操作必须明确关闭”。
5.5 beq
beq 同时做比较和下一 PC 选择:
ALU 可复用减法: 时 Zero=1。真正选择分支目标的信号可写为
Branch 说明当前确实是分支指令,Zero 说明比较成立;缺一不可。
5.6 jal 与 jr
按课程单周期模型:
jal 让 RF 写地址增加常量 31、写回数据增加 ;jr 让 NPC 再增加一个来自寄存器的候选输入。每增加一类来源,通常就是在相应端口前增加 MUX。
6. 为什么到处都是 MUX
同一个输入端可能服务多类指令:
| 被选择的端口 | 候选来源 |
|---|---|
| RF 写地址 | rd、rt、31 |
| RF 写数据 | ALU 结果、DM 读数据、 |
| ALU.B | 、扩展后的立即数 |
| 下一 PC | 、分支目标、J 型目标、 |
MUX 是共享数据通路的代价,也是控制器真正发挥作用的地方。没有 MUX,只能给每类指令复制一套硬件;MUX 太多、级联太深,又会拉长关键路径。
7. 控制器:把 opcode/funct 翻成选择与使能
控制器读取 opcode 与 funct,产生两类信号:
- 功能选择:ALU 做什么、EXT 怎样扩展、NPC 选哪种地址;
- 写使能:RF、DM 是否允许写入。
概念性的控制关系如下:
| 指令 | RF 写 | DM 写 | ALU.B | RF 写地址 | RF 写数据 | 下一 PC |
|---|---|---|---|---|---|---|
| R 型 | 是 | 否 | rd | ALU | ||
ori | 是 | 否 | 零扩展立即数 | rt | ALU | |
lw | 是 | 否 | 符号扩展立即数 | rt | DM | |
sw | 否 | 是 | 符号扩展立即数 | 无关 | 无关 | |
beq | 否 | 否 | 无关 | 无关 | 条件选择 | |
jal | 是 | 否 | 无关 | 31 | J 型目标 | |
jr | 否 | 否 | 无关 | 无关 | 无关 |
表中的“无关”不是随便驱动都可以。它表示该结果不会被写入状态元件;真正必须安全的是写使能和下一 PC。
7.1 主控制器与 ALU 控制器
常见实现把控制拆成两层:
- 主控制器按
opcode判断指令大类,产生访存、写回、MUX 等控制,并给出抽象ALUOp; - ALU 控制器再结合
funct,生成具体 ALU 运算码。
这样主控制器不用为每个 R 型 funct 重复大部分相同逻辑。
8. 时序与关键路径
单周期时钟周期至少覆盖所有指令中最慢的一条组合路径:
课件示例把 RF 读写延迟设为 100 ps、其他主要部件各 200 ps,lw 的路径最长,得到约 800 ps 的时钟周期,即最高频率约
无论当前执行的是很快的 addu 还是很慢的 lw,都要等满这 800 ps。单周期的 CPI 恒为 1,却不代表一定快;性能由
共同决定。
9. 与多周期模型的边界
2025 复习提纲把单周期、多周期和流水线列在同一教学视图中,但现有完整设计课件主要展开单周期与流水线。复习提纲给出的多周期对比是:
- 把一条指令拆成多个较短周期;
- 不同指令所需周期数可不同;
- 同一功能部件可在不同周期复用;
- 时钟可更短,但平均 CPI 大于 1,控制器需要记住当前步骤。
因此这里不补造未提供的多周期详细状态图。考试若只按现有材料,重点是三种模型的性能关系,而非凭空背一套多周期控制编码。
10. 看大图时的固定路线
不要顺着所有线乱看。对任一指令只追四件事:
- 读了谁:IM 字段怎样接 RF 与 EXT;
- 算了什么:ALU 输入来自哪里、执行什么;
- 写了谁:RF 或 DM 的写地址、写数据、写使能;
- 下一条去哪:NPC 选 、分支、跳转还是寄存器。
把每条指令都写成 RTL,再填写这四问,整张单周期数据通路图就只是多条简单路径的叠加。