第 9 讲 · 神经网络
SVM 先选一个核函数,再在对应特征空间中找边界。神经网络则把“特征怎样表示”和“怎样分类”放进同一个可训练系统:前面的层逐步变换输入,最后一层完成预测。
从人工神经元到感知机
一个神经元先做加权求和,再过激活函数:
早期 MP 神经元和 Hebb 学习规则提供了生物启发,感知机进一步用错分样本调整权重。对标签 ,错分时可做:
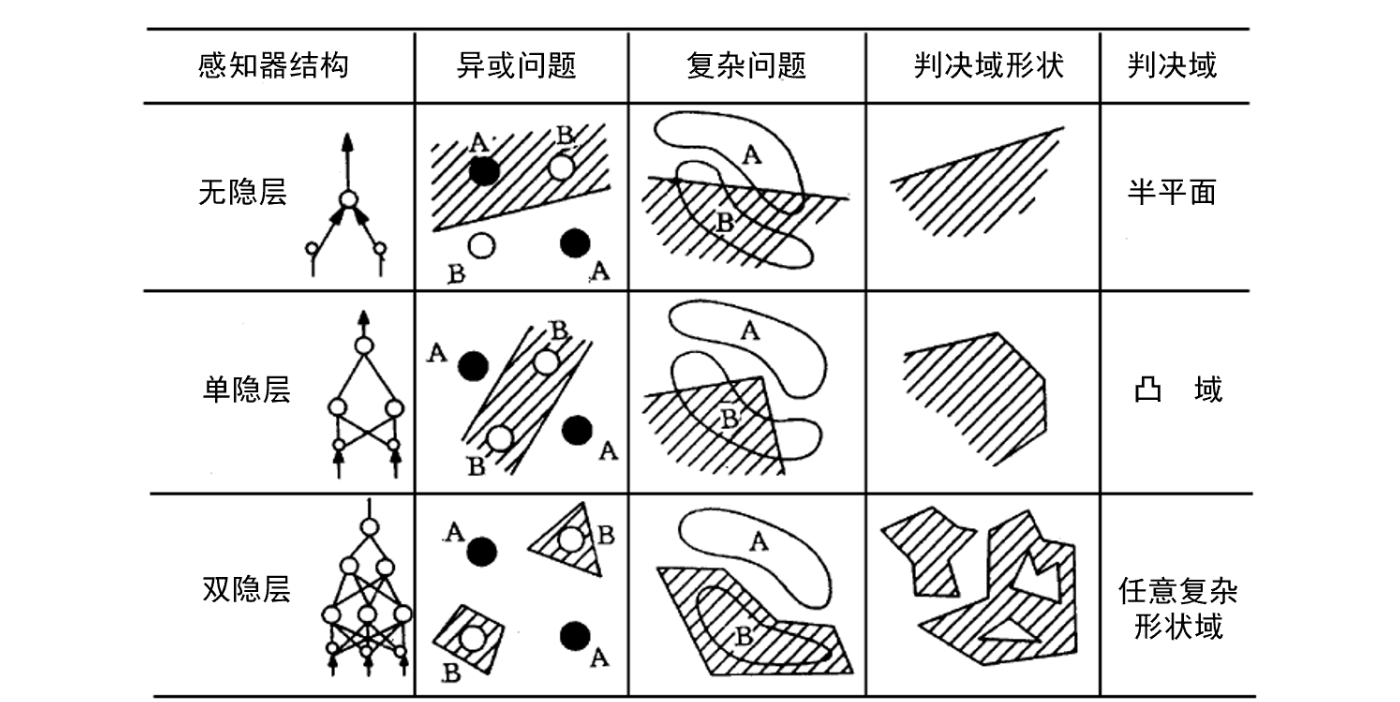
感知机能实现 AND、OR 等线性可分逻辑,却无法单层解决 XOR。这不是训练技巧问题,而是几何上不存在一条直线把 XOR 两类分开。
多层网络为什么需要非线性
多层感知机写成:
如果去掉 ,两层仿射变换可合并为一层:
所以网络“深”不是因为矩阵乘得多,而是每层之间的非线性让函数族变丰富。常见激活:
- sigmoid 输出 0—1,但饱和区梯度小;
- tanh 输出 -1—1,仍会饱和;
- ReLU 为 ,正区梯度稳定、计算简单。
反向传播就是链式法则复用
前向传播保存每层中间值并算出损失。反向传播从损失开始,沿计算图反向乘局部导数。例如:
同一个中间梯度只算一次,随后分发给前驱节点,这使大网络训练成为可能。所有权重若初始化成相同值,同层神经元会收到相同梯度、永远学成一样,因此要随机初始化;初始化尺度过大或过小又会引起激活和梯度不稳定。
CNN:利用图像的空间结构
全连接层把每个像素连到每个神经元,参数很多,也忽略了邻近像素更相关的事实。卷积神经网络使用:
- 局部感受野:卷积核只看一个局部窗口;
- 权重共享:同一个卷积核滑过整张图,检测相同模式;
- 多通道特征图:不同卷积核学习边缘、纹理和更高层结构;
- 池化或步幅:缩小空间尺寸,提高一定平移容忍度。
课件依次回顾 LeNet、AlexNet、ZFNet、GoogLeNet、VGG 和 ResNet。与其死背年份,不如记住改进主线:网络变深、激活和训练方法改进、多尺度分支提高效率、统一的小卷积堆叠,以及 ResNet 用残差连接让信息和梯度绕过若干层:
RNN:让序列拥有状态
循环神经网络在每一步把当前输入和上一隐藏状态合并:
同一组参数在所有时间步共享,可表示一对多、多对一和多对多任务。训练时把网络沿时间展开,再用 BPTT 反向传播。长序列上反复乘相似 Jacobian,梯度可能指数变小或变大,形成梯度消失或爆炸。
LSTM:给长期信息一条更平滑的通道
LSTM 维护细胞状态 ,用门控制信息:
遗忘门决定保留多少旧状态,输入门决定写入多少新候选,输出门决定暴露多少状态。它缓解长依赖问题,但并未让序列训练完全没有困难。
Fashion-MNIST 实践的完整链路
课件用 28×28 灰度服饰图做十分类。最简单的 MLP 把图像展平为 784 维,经过 256 个隐藏单元,再输出 10 类 logits:
model = nn.Sequential(
    nn.Flatten(),
    nn.Linear(28 * 28, 256),
    nn.ReLU(),
    nn.Linear(256, 10),
)
训练循环的固定结构是:取小批量、前向、算损失、清空旧梯度、反向、优化器更新;测试时关闭梯度并切到评估模式。分类通常把原始 logits 直接交给交叉熵,不要先手工 softmax 后再传一次。
CNN、RNN/LSTM 都把特定结构写进网络。下一讲先从统计语言模型出发,再看到 Attention 和 Transformer 怎样让序列位置直接交互。